이 코드는 어떤 문제를 푸나요?
두 CPU가 동시에 카운터를 1씩 올릴 때 둘 다 옛 값 10을 읽고 11을 쓰면 한 번의 증가가 사라집니다. 원자적 연산은 이 중간 끼어들기를 막습니다. arm64의 LSE 또는 LL/SC, x86의 LOCK 명령, RISC-V의 AMO 또는 LR/SC는 이를 구현하지만 주변 메모리의 순서 보장은 별도 조건입니다.
읽을 범위: v6.18.37 · arch/arm64/include/asm/atomic.h · ATOMIC_FETCH_OP / ATOMIC_FETCH_OPS 34–44행입니다. 아래에 이 범위의 원문과 각 줄의 설명을 실었습니다. 주제 전체의 흐름과 다른 경로는 기존 분석에서 함께 읽으실 수 있습니다.
먼저 알아둘 개념
읽기·수정·쓰기
현재 값을 읽은 결과로 새 값을 만드는 묶음입니다. READ_ONCE와 WRITE_ONCE를 각각 호출했다고 이 묶음 전체가 원자적이 되지는 않습니다.
acquire와 release
acquire는 뒤의 접근, release는 앞의 접근과 연결하는 순서 규칙입니다. 서로 다른 주소의 데이터 공개를 설명할 때 필요합니다.
토큰 결합 ##
C 전처리기가 함수 이름을 조립하는 문법입니다. CPU가 실행하는 덧셈이 아니라 빌드 중 API 변형을 만드는 작업입니다.
처음 읽을 때
카운터 값이 10에서 12가 되어야 하는 두 CPU 예를 먼저 그려 보십시오.
더 깊이 살펴볼 때
성공한 연산뿐 아니라 실패한 비교 교환의 순서 보장과 LL/SC 재시도 비용도 구분해 보십시오.
그림으로 보는 변화
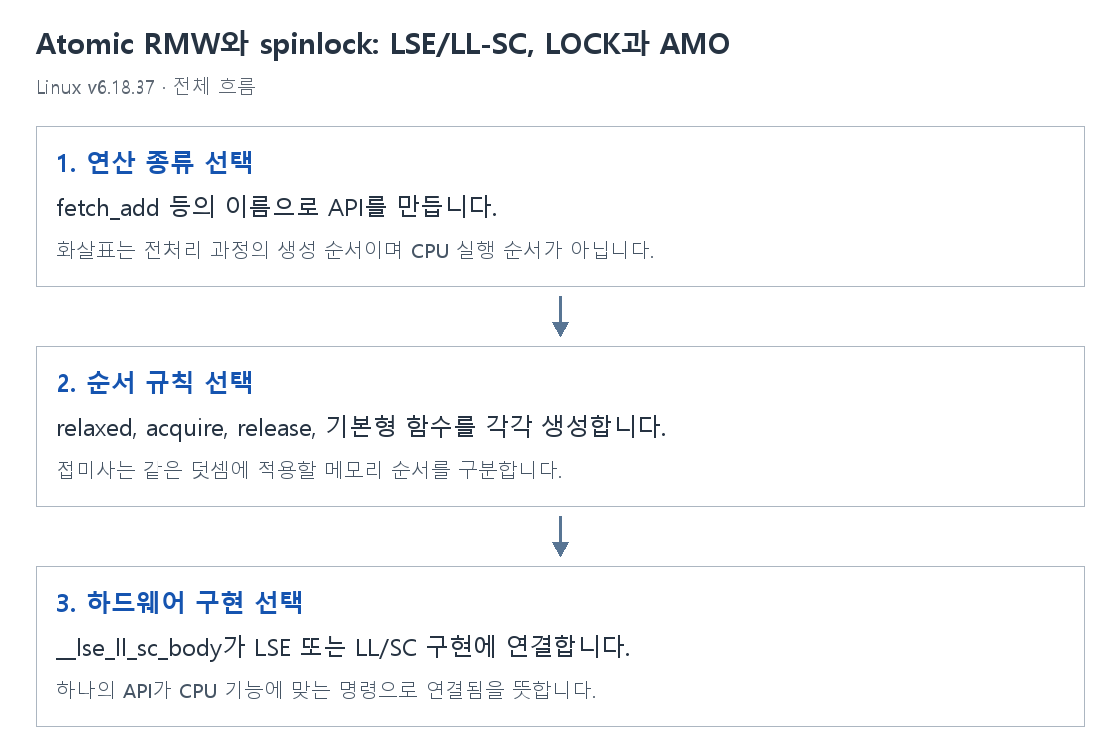
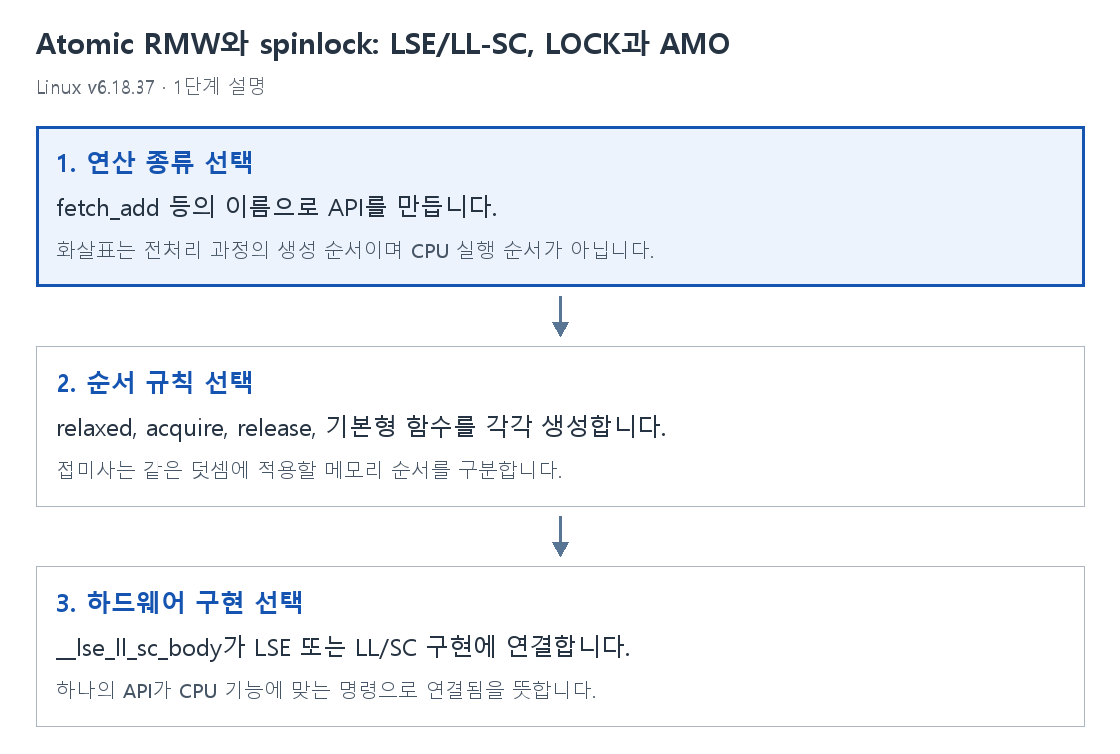
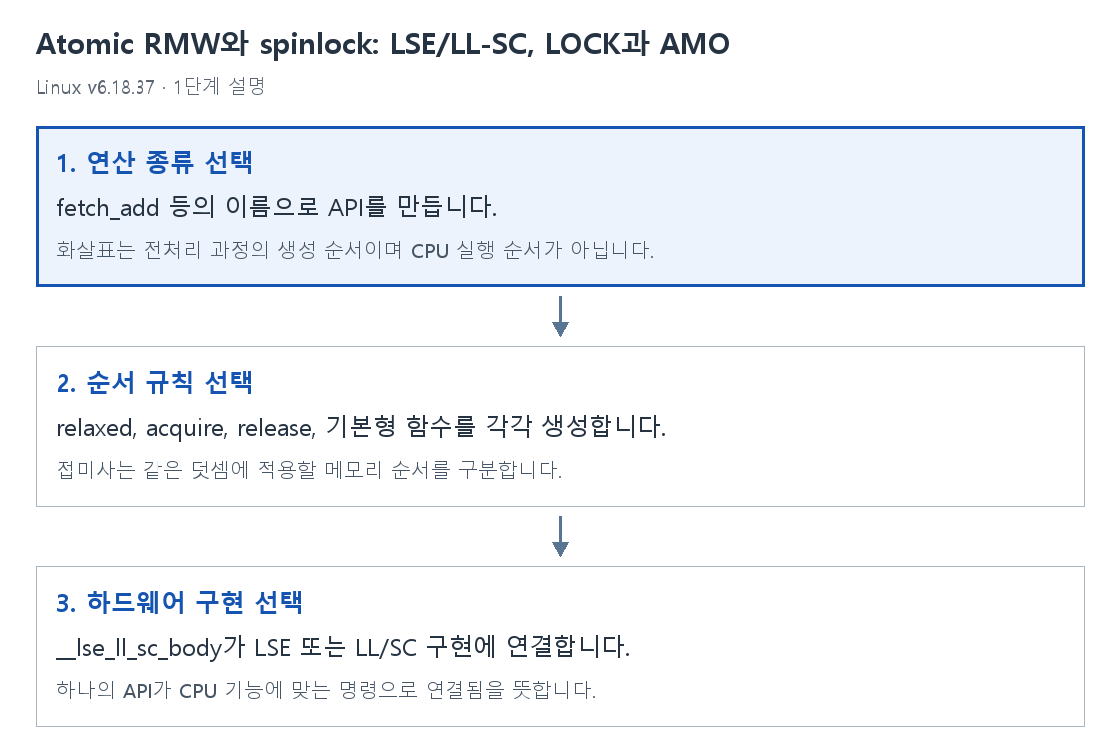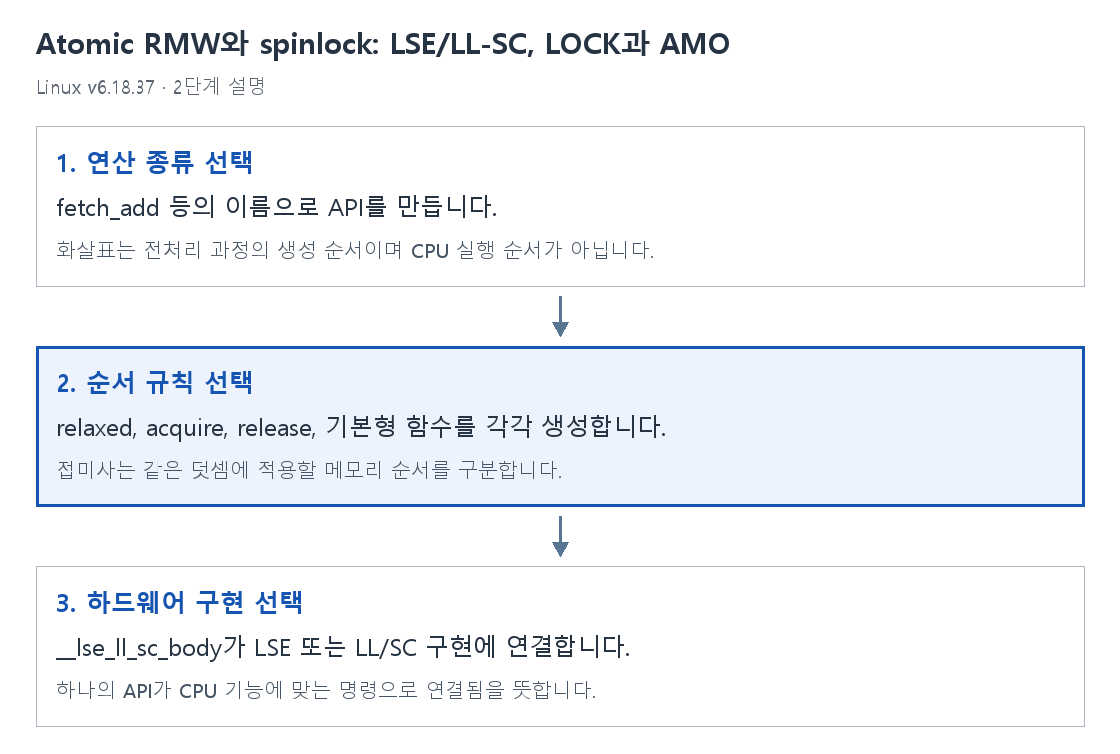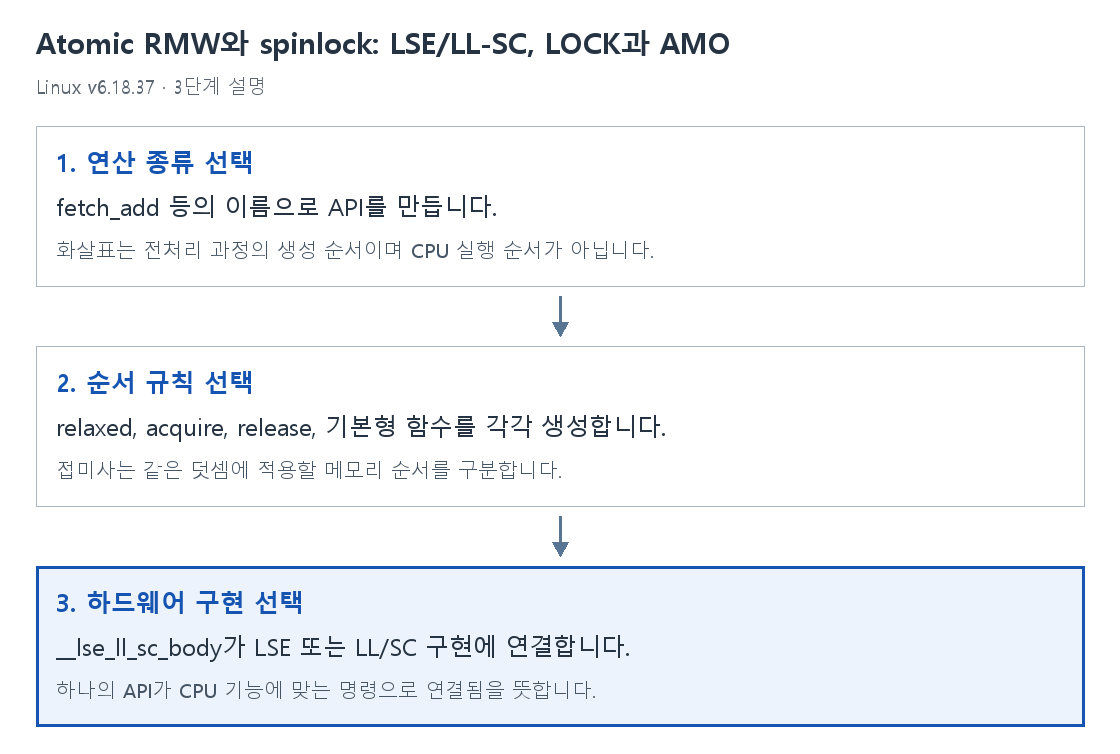
1. 연산 종류 선택
fetch_add 등의 이름으로 API를 만듭니다.
화살표는 전처리 과정의 생성 순서이며 CPU 실행 순서가 아닙니다.
2. 순서 규칙 선택
relaxed, acquire, release, 기본형 함수를 각각 생성합니다.
접미사는 같은 덧셈에 적용할 메모리 순서를 구분합니다.
3. 하드웨어 구현 선택
__lse_ll_sc_body가 LSE 또는 LL/SC 구현에 연결합니다.
하나의 API가 CPU 기능에 맞는 명령으로 연결됨을 뜻합니다.
ATOMIC_FETCH_OP / ATOMIC_FETCH_OPS를 한 줄씩 읽기
줄 번호는 v6.18.37 원문 기준입니다. 주석·빈 줄을 포함한 함수 전체를 먼저 보고, 그 아래에서 각 줄을 설명합니다.
#define ATOMIC_FETCH_OP(name, op)					\
static __always_inline int arch_##op##name(int i, atomic_t *v)		\
{									\
	return __lse_ll_sc_body(op##name, i, v);			\
}

#define ATOMIC_FETCH_OPS(op)						\
	ATOMIC_FETCH_OP(_relaxed, op)					\
	ATOMIC_FETCH_OP(_acquire, op)					\
	ATOMIC_FETCH_OP(_release, op)					\
ATOMIC_FETCH_OP( , op)#define ATOMIC_FETCH_OP(name, op) \연산 이름 op와 접미사 name을 받아 함수 하나를 생성하는 C 전처리 매크로입니다. 줄 끝 역슬래시는 정의가 다음 줄에도 이어짐을 뜻합니다.
static __always_inline int arch_##op##name(int i, atomic_t *v) \##로 토큰을 결합합니다. 예를 들어 op가 atomic_fetch_add이고 name이 _acquire면 arch_atomic_fetch_add_acquire가 됩니다. i는 피연산자, v는 수정할 atomic_t의 주소입니다.
return __lse_ll_sc_body(op##name, i, v); \연산과 순서 접미사를 유지한 채 LSE 또는 LL/SC 구현으로 연결하고 그 결과를 반환합니다. fetch 연산이라면 반환값은 갱신 전 값입니다.
#define ATOMIC_FETCH_OPS(op) \이번에는 같은 연산의 메모리 순서 변형 네 개를 한꺼번에 생성할 매크로를 정의합니다.
ATOMIC_FETCH_OP(_relaxed, op) \relaxed 변형을 만듭니다. 대상 값의 원자성은 유지하지만 주변 메모리에 추가 acquire/release 순서를 붙이지 않습니다.
ATOMIC_FETCH_OP(_acquire, op) \acquire 변형을 만듭니다. 후속 접근과 연산 사이의 순서 보장이 필요한 소비자 쪽에 사용합니다.
ATOMIC_FETCH_OP(_release, op) \release 변형을 만듭니다. 앞선 접근을 공개하는 생산자 쪽 순서와 연결됩니다.
ATOMIC_FETCH_OP( , op)접미사가 없는 기본형을 만듭니다. 해당 Linux atomic API가 정한 기본 메모리 순서를 따릅니다. 이 네 줄은 네 연산을 순차 실행하는 코드가 아닙니다.
함께 생각해 볼 질문
relaxed는 증가가 유실되어도 된다는 뜻입니까?
아닙니다. 대상 변수의 원자성은 유지하고 주변 메모리 접근의 추가 순서를 보장하지 않는다는 뜻입니다.
atomic_add와 atomic_fetch_add는 무엇이 다릅니까?
fetch 계열은 연산 전 값을 반환합니다. 반환값 유무와 순서 보장은 API별로 함께 확인해야 합니다.
스핀락은 원자적 증가와 같습니까?
아닙니다. 스핀락은 임계 구역 전체의 상호 배제와 잠금 획득·해제 순서를 구성합니다.
출처와 읽은 범위
Linux stable v6.18.37 · arch/arm64/include/asm/atomic.h
해당 버전 원본 파일 · 기존 코드 분석 · 설명 원고