속도 순위 대신 전송 구조를 고릅니다
| 인터페이스 | 기본 구조 | 설계 질문 |
|---|---|---|
| APB | SETUP 다음 ACCESS, 단일 전송 | 설정 레지스터 접근의 대기를 어떻게 처리할까? |
| AHB | 주소와 이전 데이터 단계가 겹침 | 수락한 주소와 완료된 데이터를 어떻게 연결할까? |
| AXI4 | 독립된 AW·W·B·AR·R 채널 | 여러 미완료 요청과 응답 순서를 어떻게 추적할까? |
UART 설정에 APB, MCU 메모리에 AHB, 여러 요청자의 메모리 경로에 AXI를 쓰는 것은 흔한 구성이지 용도 제한이 아닙니다. 클록, 폭, 중재, 버퍼와 대상 장치가 다르면 같은 프로토콜의 처리량도 달라집니다. Arm AXI4 입문서도 대역폭과 지연을 별도 지표로 다룹니다.
APB: 두 클록은 최소값입니다
PSEL=1, PENABLE=0인 SETUP은 한 클록입니다. 이후 ACCESS에서 PENABLE=1이 되고, PREADY=0이면 요청 주소·제어와 쓰기 데이터를 유지하며 기다립니다. PREADY=1인 완료 에지 뒤에는 IDLE 또는 다음 SETUP으로 갑니다. 대기 없는 네 번의 단일 접근은 8클록이지만 APB 버스트는 아닙니다. APB Issue E §3·4.
연속 접근에서도 각 전송의 SETUP은 필요합니다. 같은 장치를 계속 선택하는 경우와 다른 장치로 전환하는 경우를 구별하고, 완료되지 않은 ACCESS를 새 전송으로 세지 않습니다. APB5의 wake-up·parity·RME 확장도 구성 옵션입니다. PWAKEUP·parity는 Issue D, PNSE는 Issue E에서 추가됐으며 모든 포트에 있다고 가정하지 않습니다.
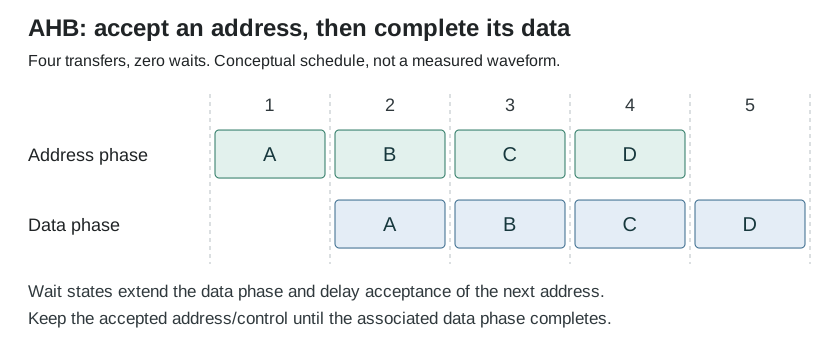
AHB: 주소를 기억한 뒤 데이터를 연결합니다
대기 없는 네 beat는 첫 주소 단계와 네 데이터 단계를 합쳐 5클록에 끝날 수 있습니다. 선택된 장치의 HREADYOUT이 낮아져 HREADY=0이면 해당 인터페이스가 기다립니다. SoC의 모든 독립 경로가 멈추는 것은 아닙니다. AHB Issue C §1.3·3·5.
NONSEQ는 처음 또는 단일 전송, SEQ는 연속 beat입니다. BUSY와 IDLE을 데이터 beat로 세지 않습니다. 대기 중에도 규격이 허용한 BUSY→SEQ·IDLE→NONSEQ 전환이 있으므로 주소·제어가 언제나 고정된다는 검사는 부정확합니다.
4바이트 단위 WRAP4의 주소가 0x38→0x3C→0x30→0x34인 것은 16바이트 경계에서 감기기 때문입니다. 증가형 버스트는 1KB 경계를 넘지 않아야 합니다. 접근 크기를 바꿔도 같은 주소열을 기대하면 안 됩니다.
모니터는 HREADY=1에서 수락한 주소·제어를 보관하고 뒤의 데이터·응답과 연결합니다. ERROR는 첫 클록 HRESP=1, HREADYOUT=0, 다음 클록 HRESP=1, HREADYOUT=1입니다. 완료 시점만 보면 첫 ERROR 클록을 놓칩니다. 단순히 직전 클록의 주소와 데이터를 짝짓지 않습니다.
AXI4: 채널 하나의 수락은 거래 전체의 완료가 아닙니다
쓰기 주소 AW, 쓰기 데이터 W, 쓰기 응답 B, 읽기 주소 AR, 읽기 데이터·응답 R을 분리합니다. 각 채널은 ACLK 상승 에지에서 VALID && READY이면 전송합니다. 송신자는 READY를 기다렸다가 VALID를 올리면 안 되며, 수락 전까지 VALID와 해당 정보를 유지합니다. READY가 먼저 올라오는 것은 허용됩니다. AXI/ACE Issue H.c §A3.
AW와 W의 수락 순서는 고정되지 않습니다. 쓰기 응답 B는 주소와 마지막 데이터 beat가 모두 수락된 뒤에 나옵니다. 읽기는 R 채널에서 데이터와 응답을 받고 RLAST로 마지막 beat를 구분합니다. 같은 ID의 여러 미완료 요청도 가능하지만 같은 방향의 응답 순서를 지켜야 합니다. 서로 다른 ID가 재정렬될 수 있다는 사실은 항상 병렬로 진행한다는 보장이 아닙니다.
| 버스트 | beat 수 | 주소 진행 |
|---|---|---|
| INCR | 1–256 | 증가 |
| FIXED | 1–16 | 동일 주소 |
| WRAP | 2·4·8·16 | 정해진 경계에서 감김 |
버스트는 4KB 경계를 넘지 않습니다. 길이, 한 beat의 바이트 수, 데이터 버스 폭은 다른 값입니다. AXI4 입문서 §5.3·7. APB 8클록과 AHB·AXI의 예시 5클록을 실측 순위로 비교하지 말고 주소 수락부터 최종 응답까지 같은 조건으로 측정합니다.
AXI-Lite: B 응답이 막히면 다음 쓰기는 어디에 남을까요?
AXI4-Lite는 한 거래의 데이터가 한 beat이며, 여러 미완료 거래를 허용하되 수락량을 제한할 수도 있습니다. AW와 W를 모두 받은 뒤 B 응답을 내며, BREADY를 기다렸다가 BVALID를 처음 올리는 방식은 안 됩니다. Issue H.c §A3.2·A3.3.1·B1.1. 여기서는 메모리 매핑된 쓰기 채널만 다룹니다. AXI4-Stream의 TVALID/TREADY 예제가 아닙니다.
B 슬롯이 하나여도 앞쪽 저장 공간은 별도로 셉니다
BVALID && !BREADY인 동안 기존 응답의 VALID와 BRESP를 보존해야 합니다. 그렇다고 다음 AW·W 수락이 무조건 금지되는 것은 아닙니다. 받은 주소·데이터를 별도 버퍼에 남길 수 있으면 수락하고, 그 공간까지 찼다면 READY를 내려 추가 수락을 막습니다. 내부 처리나 응답을 보관할 다른 곳도 없는데 다음 쓰기를 처리하면, 같은 BVALID 한 비트에 두 응답을 겹쳐 잃을 수 있습니다.
고정 소스 easyaxil.v의 OPT_SKIDBUFFER=1 경로는 AW와 W에 각각 skid buffer를 두고, 두 입력이 준비됐으며 B 슬롯이 비었거나 현재 응답이 이번 에지에 수락될 때 내부 쓰기를 처리합니다. 이전 B 응답 완료와 다음 응답 생성이 같은 에지에 일어나면 BVALID가 계속 1이어도 서로 다른 응답입니다. 외부 AW/W 핸드셰이크와 내부 처리 신호 axil_write_ready를 같은 사건으로 세지 않습니다.
이 경로의 skidbuffer.v는 OPT_OUTREG=0, OPT_PASSTHROUGH=0으로 선택되어 각 채널에 보관 엔트리 1개와 비어 있을 때의 통과 경로를 갖습니다. WDATA와 WSTRB를 함께 보존합니다. 다른 옵션·구현의 깊이까지 1개라고 일반화하면 안 됩니다. 규격의 조건은 인터페이스 입력에서 출력으로 조합 경로를 만들지 않는 것이며, BREADY를 AWREADY에 조합 논리로 바로 연결하라는 뜻이 아닙니다.
주소·데이터·내부 처리·응답 완료의 네 숫자
리셋이 없는 관측 구간에서 누적 AW 수락을 A, W 수락을 W, 순서대로 한 쌍을 내부 처리한 횟수를 P, B 핸드셰이크 완료를 B라고 놓습니다. 아래의 설명용 모델은 AW 보관 1개, W 보관 1개, 처리된 쓰기의 B 슬롯 1개이며 별도 실행 파이프라인은 없습니다. 따라서 0 ≤ A−P ≤ 1, 0 ≤ W−P ≤ 1, 0 ≤ P−B ≤ 1을 확인합니다. 이는 이 모델의 용량 불변식이지 모든 AXI-Lite 장치의 고정 큐 크기 규정이 아닙니다.
| 상승 에지 | 외부 수락 | 내부 처리·응답 완료 | 에지 후 (A,W,P,B) |
|---|---|---|---|
| 1 | AW0만 수락 | 주소 보관, W0 대기 | (1,0,0,0) |
| 2 | W0 수락 | 쓰기 0 처리, B0가 다음 구간에 유효 | (1,1,1,0) |
| 3 | AW1·W1 수락 | BREADY=0: B0 유지, 다음 쌍은 버퍼에 보관 | (2,2,1,0) |
| 4 | 없음: AW2·W2는 제시됐지만 READY=0 | BREADY=0, 세 저장 자원 모두 유지 | (2,2,1,0) |
| 5 | 없음: 에지 직전 AW/W 버퍼는 여전히 가득 참 | BREADY=1: B0 완료와 쓰기 1 처리, B1로 교체 | (2,2,2,1) |
| 6 | 유지하던 AW2·W2 수락 | B1 완료와 쓰기 2 처리, B2로 교체 | (3,3,3,2) |
| 7 | 없음 | B2 완료, 미완료 거래 0개 | (3,3,3,3) |
위 표는 초기 상태가 빈 설명용 모델의 계산 결과이며 RTL 시뮬레이터 파형이 아닙니다. AW0보다 W0가 먼저 와도 독립적으로 보관해야 합니다. 버퍼가 없는 설계는 양쪽 VALID와 저장 여유를 확인한 뒤 수락을 제한하는 다른 정책을 쓸 수 있습니다. AW와 W가 항상 같은 클록에 도착한다고 가정하는 것과는 다릅니다.
개수 검사만으로는 충분하지 않습니다
- 리셋이 없을 때 정체된 채널의 VALID와 해당 정보가 다음 에지까지 유지되는지 봅니다. AWADDR·AWPROT, WDATA·WSTRB, BRESP를 각 채널과 함께 추적합니다.
- B 완료가 수락한 AW·W 쌍을 앞서지 않는지 확인하고, 주소·데이터 식별자를 붙인 scoreboard로 짝과 응답 순서를 따로 검사합니다. 개수가 같아도 데이터 교환·중복은 놓칠 수 있습니다.
- AW 선행, W 선행, 여러 클록의 BREADY=0, 응답 교체와 연속 쓰기를 각각 실행합니다. 유한 길이 테스트 통과는 임의의 입력에 대한 형식 증명이 아닙니다.
- 리셋 때 VALID와 보관 상태를 초기화하는 조건을 정하고 계수 구간을 새로 시작합니다. 한쪽만 로컬 리셋한 뒤 미완료 요청을 정상 완료한 것으로 세면 안 됩니다. 인터커넥트의 정지·배출·복구 계약은 별도입니다.
- 용량과 보존은 안전성 조건입니다. 상대가 결국 BREADY를 올리는지 등 진행 가정이 없으면, 모든 요청이 끝난다는 활성 속성까지 증명할 수 없습니다.
2026년 10월 29일 H.c 규격과 위 커밋의 두 RTL 파일을 직접 대조했습니다. 설명용 JavaScript 모델의 개수·순서·정체 검사를 했으며 RTL 컴파일, 형식 검증 도구, 합성·배치배선, FPGA 실측은 수행하지 않았습니다. 역사적 vendor 예제의 결함을 현재 제품 전체의 결함으로 주장하지 않습니다.
인터커넥트와 브리지는 구현 조건을 함께 봅니다
같은 manager의 동일 ID 읽기 응답 또는 쓰기 응답은 목적지가 달라도 요청 순서를 지켜야 합니다. 그러나 이를 반드시 재정렬 버퍼로 구현해야 하는 것은 아닙니다. 요청 발행을 제한하는 방법도 있습니다. Issue H.c §A5·A6. Round-robin 중재, 포트별 병렬 경로, 큐 분리는 제품의 선택입니다. 공유 큐의 앞 요청이 막혀 뒤 요청도 기다리는 현상을 AXI 전체의 필연적 특성으로 확대하지 않습니다.
AXI → APB
지원되는 4-beat 버스트를 같은 접근 폭의 한 APB 경로로 변환한다면 네 번의 단일 전송으로 나눕니다. 폭 변환이 있으면 하위 전송 수를 다시 계산합니다. 각 ACCESS의 대기와 오류를 기록하고 상위 응답에 어떻게 결합하는지 해당 브리지 계약을 확인합니다. 읽기 우선, 최대 16개 주변장치, 특정 오류 매핑을 모든 브리지의 규칙으로 쓰지 않습니다.
AXI → AHB
AHB의 주소·데이터 단계와 1KB 경계는 AXI의 채널 및 4KB 경계와 다릅니다. 변환기가 버스트를 단일 전송이나 새 NONSEQ로 나눌 수도 있습니다. 클록 도메인 교차, ID 표, 버퍼 깊이가 항상 필요한 고정 구성이라고 단정하지 않습니다. 실제 구현 사례는 Lattice Unified Interconnect와 중재·CDC·레지스터 슬라이스에서 별도로 다룹니다.
주소 디코더의 미할당 영역과 장치가 배정받았지만 응답하지 않는 영역도 구분합니다. 기본 오류 응답기가 있다는 이유만으로 모든 무응답이 해결된다고 가정하지 않습니다.
AXI5 Issue L: Credited는 선택 기능입니다
기본 AXI_Transport=Ready는 VALID/READY를 사용합니다. AXI5에서 선택하는 Credited는 수신자가 CRDT로 credit을 먼저 주고 송신자가 가진 credit으로 전송하는 방식입니다. 연결된 양쪽의 transport가 같아야 합니다. 새 credit을 받은 같은 클록에 바로 쓰지 않으며, credit이 없으면 VALID를 올릴 수 없습니다. Issue L §A2.2·A2.4.
PENDING은 VALID보다 한 클록 먼저 올라와야 하지만 다음 전송을 확약하지 않습니다. 계속 높게 두거나 전송 없이 내릴 수도 있습니다. Resource Plane(RP)은 흐름 제어 자원을 나눕니다. AW/W·AR은 구성별 1–8개이며 기본 1개, B/R은 1개입니다. 같은 쓰기의 AW/W는 같은 RP를 사용합니다. 다른 RP 간 순서는 보장되지 않으며 같은 채널의 동일 ID 미완료 거래를 다른 RP로 이어 발행해서는 안 됩니다.
이 옵션이 모든 배치에서 더 높은 클록이나 낮은 지연을 보장하지는 않습니다. 캐시 일관성·snoop은 별도 구성 조건이므로, credit 전송만 보고 특정 peer-cache hit나 캐시 상태 전이를 단정하지 않습니다.
테스트에는 수락·대기·완료를 따로 남깁니다
- 클록·폭·접근 크기·버스트 종류·버퍼 깊이·대상 주소를 입력 조건으로 고정합니다.
- 첫 요청, 각 beat의 수락, 대기 구간과 최종 응답을 별도 시각으로 기록합니다.
- 첫·중간·마지막 beat 대기, 연속 요청, 동일 ID와 서로 다른 ID, 주소 경계 및 오류를 나눠 점검합니다.
- 브리지는 상·하위 거래 수와 오류 처리 결과를 연결합니다. 프로토콜 변환 성공과 메모리·장치의 실제 작업 완료를 동일시하지 않습니다.
출처와 확인 범위
2026년 10월 26일 확인. 저장된 Abhishek Chakraborty의 AMBA 설명을 계기로 규격과 다시 대조해 작성했습니다. 원저자의 애니메이션은 재사용하지 않았으며 RTL·실기기 실행 결과를 제시하는 글이 아닙니다.
- Arm AMBA APB, Issue E §1·3·4·5: 단계, 대기와 선택 신호.
- Arm AMBA AHB, Issue C §1.3·3.6·3.7·5.1: 단계 연결, 버스트, 대기 예외와 오류.
- Arm AMBA AXI/ACE, Issue H.c §A3·A5·A6: AXI4 수락·응답·순서. Issue J부터 AXI4 내용이 제거됐으므로 최신 문서 번호를 AXI4 근거로 대신 쓰지 않습니다.
- Arm Introduction to AMBA AXI4 §4·5·7: 거래·전송, 길이와 순서.
- Arm AMBA AXI, Issue L §A2.2·A2.4.1·A2.4.2·A2.4.4: 공식 색인의 해당 절을 확인했습니다. 전체 PDF의 직접 열기는 시간 초과되어 전체 쪽 검토로 표시하지 않습니다.
- AMBA 선택 원문 · AHB 파이프라인 원문. 저장 본문과 실제 애니메이션 재생 확인은 별개입니다.
AXI5 검증: 배타 접근, 원자 연산과 응답의 의미
앞의 AXI4 설명과 별도로, 이 절은 Arm AXI Issue L의 A3–A6을 기준으로 합니다. Issue L의 선택 기능을 AXI4의 공통 기능으로 읽지 않습니다. 같은 ID의 읽기 응답끼리, 쓰기 응답끼리의 순서는 지켜야 하지만 읽기와 쓰기 사이, 서로 다른 ID·Manager 사이까지 전역 FIFO가 되는 것은 아닙니다. Scoreboard는 방향·ID·목적지·주소 범위와 속성을 함께 추적해야 합니다. 같은 ID만으로 CPU의 메모리 배리어를 대신할 수 없습니다.
Exclusive read의 EXOKAY는 대상이 배타 접근을 지원하고 읽기를 감시했음을 뜻합니다. 후속 exclusive write는 같은 주소·ID와 규정된 일치 속성을 사용해야 합니다. 감시 조건이 유지되어 쓰기가 성공하면 EXOKAY와 함께 갱신하고, 충돌로 실패하면 OKAY를 반환하면서 메모리를 갱신하지 않습니다. 읽기 자체가 다른 요청을 차단하는 잠금은 아닙니다.
하지만 미지원 대상의 exclusive read는 유효한 데이터를 OKAY로 돌려줄 수 있습니다. 이때 후속 exclusive write를 보내지 않는 것이 권고됩니다. 미지원 대상에 그 쓰기를 보내면 OKAY를 반환하면서 실제로 갱신할 수 있기 때문입니다. 검증기는 같은 OKAY라도 일반 쓰기, 지원 대상의 배타 실패, 미지원 대상의 응답을 구분해야 합니다.
Atomic_Transactions는 기본값이 미지원인 AXI5 선택 기능입니다. AWATOP 원자 요청에서는 AWLOCK=0이며 exclusive와 한 거래로 결합하지 않습니다. AtomicStore는 B 응답으로 완료하고, AtomicLoad·AtomicSwap·AtomicCompare는 이전 데이터를 R로 반환하며 B 응답도 사용합니다. AtomicCompare의 비교 성공은 BRESP만으로 알 수 없고 반환된 이전 값과 비교값을 대조합니다. 지원 대상·연산·크기·정렬·strobe 및 R/B 완료를 각각 확인해야 합니다.
AxCACHE는 요청의 bufferable·modifiable·allocation 속성이지 CPU 캐시나 시스템 일관성의 단일 스위치가 아닙니다. Allocate와 Other Allocate의 위치는 AR에서 각각 bit 2·3, AW에서 bit 3·2입니다. Bufferable 쓰기는 중간 지점의 응답을 허용하는 조건도 있으므로 B 수신과 최종 목적지의 작업 완료를 무조건 동일시하지 않습니다.
4-bit AxQOS는 중재 정책의 입력입니다. 높은 값의 우선 처리가 권고되지만 세부 정책·마감시간·기아 방지를 보장하지 않으며 순서 제약이 우선합니다. AxPROT의 권한·보안·명령 속성도 접근 제어를 실제로 시행하는 회로를 대신하지 않습니다. Issue L의 대체 신호 AxPRIV·AxINST·AxPAS를 쓰는 구성은 고전적 AxPROT 구성과 구별합니다.
WSTRB가 비활성인 byte lane을 쓰기 갱신으로 비교하지 않습니다. Read burst의 RRESP는 beat마다 달라도 되며 오류가 발생해도 요구되는 beat 수와 RLAST를 검사해야 합니다. 일반 B 완료 응답을 burst 내부 오류의 단순 최대값이라고 해석하지 않습니다. 추가 B 응답을 사용하는 확장 구성은 별도 계약으로 검증합니다.
확인 시나리오는 동일 ID 응답 추월, 서로 다른 ID 재정렬, 배타 성공·충돌·미지원, AtomicCompare의 이전 값, 부분 쓰기와 중간 read 오류를 분리합니다. 이는 소스에 근거한 검증 설계이며 RTL 시뮬레이션·형식 증명·실측 결과는 아닙니다. 기존 10월 26일 출처 기록과 별도로, 10월 30일에는 Issue L PDF의 응답·속성·순서·배타·원자 연산 절을 직접 대조했습니다. 저장된 AXI Guide Part 2는 질문의 출처이며 원저자 그림이나 미확인 Part 3을 재게시하지 않았습니다.
English summary. Exclusive failure and unsupported exclusive access can both return OKAY but have different memory effects. Optional AXI5 atomics, per-channel ordering, request attributes and per-beat read responses require separate checks. A response or priority value alone is not a system-wide completion or latency guarantee.