OOM report의 첫 줄에 적힌 process가 memory를 가장 많이 사용한 process일까요? 반드시 그렇지는 않습니다. 그 process는 이미 memory pressure가 높은 상황에서 allocation을 요청했다가, 우연히 OOM 처리에 진입한 쪽일 수 있습니다.
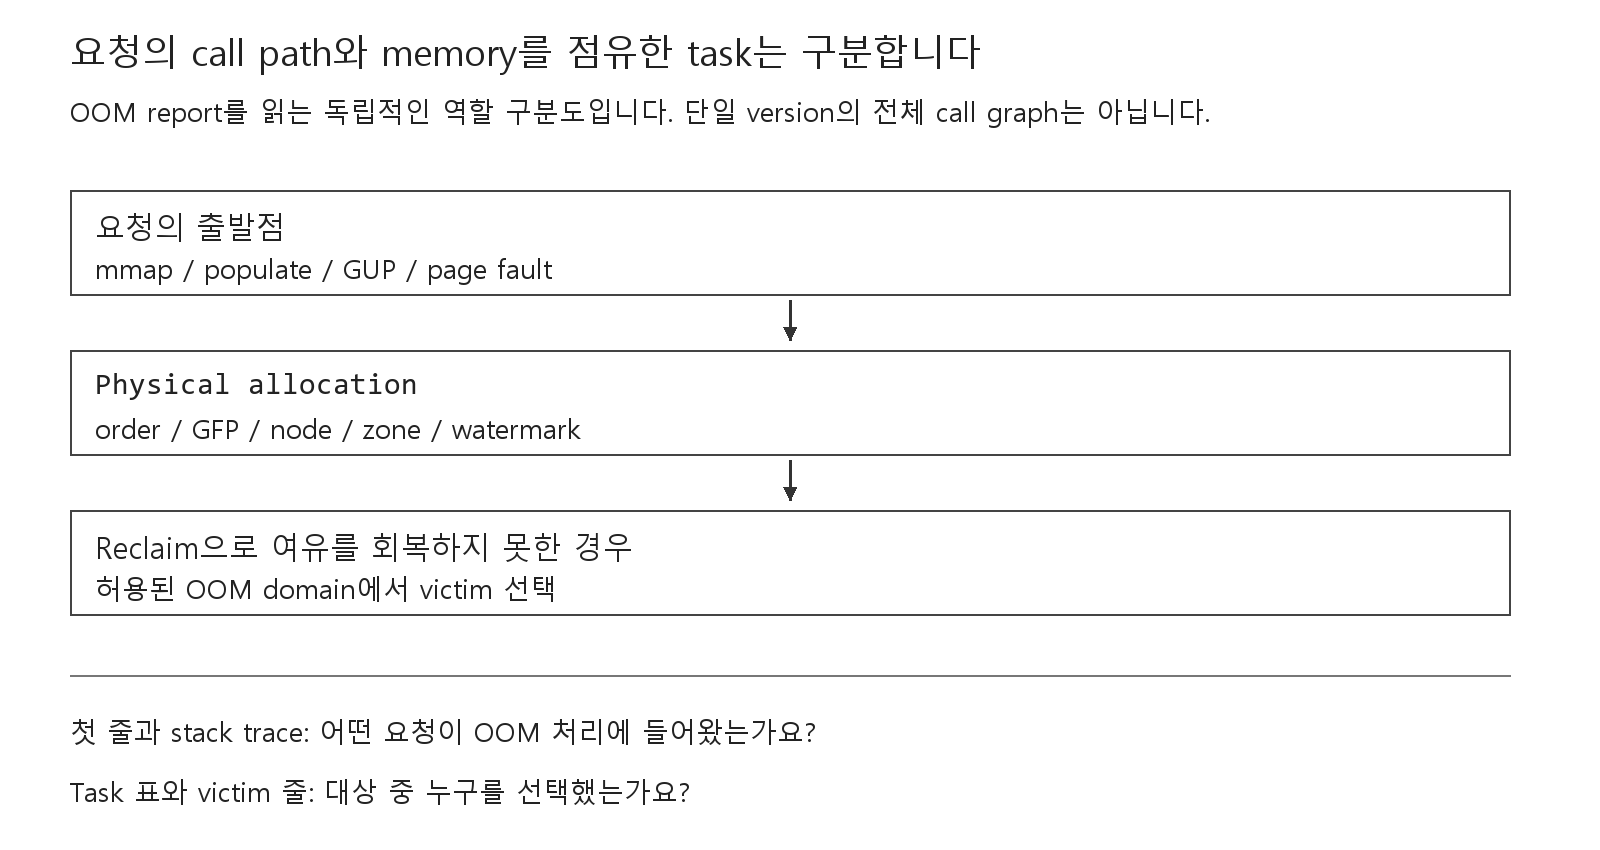
Report를 읽을 때는 요청한 쪽과 victim으로 선택된 쪽을 먼저 구분해야 합니다. 여기서는 Linux v6.12의 OOM 및 page allocator 구현을 기준으로 읽는 순서를 정리하겠습니다. 실제 log의 필드와 단위는 생성한 kernel version에 따라 달라질 수 있습니다.
첫 줄은 요청의 제약을 설명합니다
실패한 allocation에 관한 줄에는 보통 invoking task, GFP mask, order, oom_score_adj가 나타납니다. Task 이름만 보고 원인을 확정하기 전에, 어떤 memory를 어떤 조건으로 요청했는지 확인해야 합니다.
GFP mask는 단순히 allocation의 크기를 나타내지 않습니다. 사용할 수 있는 zone, reclaim이나 I/O를 허용하는지와 같은 조건이 요청 경로에 영향을 줍니다. 예를 들어 user page를 위한 요청과 atomic context의 요청은 같은 free memory를 보더라도 선택 가능한 동작이 다릅니다.
책의 예제에는 GFP_HIGHUSER_MOVABLE | __GFP_COMP | __GFP_ZERO가 표시되어 있습니다. User memory를 위한 movable allocation, compound metadata 초기화와 zeroing에 관련된 요청입니다. 다만 해당 줄의 order는 0입니다. __GFP_COMP가 인쇄됐다는 이유만으로 이번 요청이 실제 higher-order compound folio였다고 읽으시면 안 됩니다. Hexadecimal mask와 flag의 대응도 log를 생성한 kernel version에 맞추어 해석해야 합니다.
Order는 2^order개의 연속된 base pages를 뜻합니다. Base page가 4 KiB인 시스템에서 order 0은 4 KiB, order 3은 32 KiB입니다. Order 0 요청이 실패한 상황을 “큰 연속 block이 없어서 생긴 higher-order fragmentation”만으로 설명할 수는 없습니다. 반대로 높은 order에서는 총량뿐 아니라 연속성이 중요합니다.
Allocation 실패가 모두 OOM kill로 연결되는 것도 아닙니다. Costly allocation, retry flag, 현재 task와 allocation context에 따라 처리 경로가 달라집니다. Linux v6.12의 일반적인 allocator slowpath에서 costly order 요청은 OOM victim을 골라 해결하는 경로와 구분됩니다. 임의의 높은 order 실패를 곧바로 “OOM killer가 동작해야 한다”로 해석하시면 안 됩니다.
첫 줄의 oom_score_adj 역시 그 task의 조정값입니다. 최종 victim의 값이 적힌 줄과 혼동하지 않도록 PID와 함께 읽어야 합니다. 이 조정값은 memory 사용량을 바꾸는 것이 아니라 victim 선택에 영향을 주는 항목입니다.
Stack trace에서 allocation 경로를 확인합니다
Stack trace 앞부분에는 CPU, PID, task 이름, kernel version과 build 정보, taint 상태 등이 나타날 수 있습니다. 동일한 함수 이름이라도 version이 다르면 구현이 달라지므로, 분석에 사용할 source를 먼저 맞추는 것이 중요합니다.
Taint 정보도 단순한 장식이 아닙니다. Out-of-tree module 등으로 변경된 kernel인지와 같은 환경 해석에 필요할 수 있습니다. 다만 taint가 있다는 사실만으로 그 module이 이번 OOM의 원인이라고 단정할 수는 없습니다.
호출 경로에서는 page allocation slowpath와 reclaim, out_of_memory()로 이어지는 연결을 살펴봅니다. 이렇게 얻은 경로는 “이 task가 무엇을 하다가 allocation을 요구했는가”를 알려 줍니다. 시스템 전체의 memory를 누가 오래 점유했는지까지 stack trace 하나가 알려 주지는 않습니다.
책의 과거 trace에서는 mmap 경로 뒤에 __mm_populate()와 populate_vma_page_range(), GUP와 fault 경로가 보입니다. Mapping 범위를 만드는 일뿐 아니라 pages를 미리 populate하는 과정에서도 allocation이 필요할 수 있다는 뜻입니다. 함수 offset이나 build-specific syscall wrapper 이름을 현재 kernel의 call graph로 그대로 옮기지는 않겠습니다.
Global free와 요청 가능한 memory를 구분합니다
시스템 전체 free memory가 0보다 크다는 이유로 OOM report가 잘못되었다고 판단해서는 안 됩니다. 요청에 허용된 node와 zone, watermark, lowmem reserve, order 조건을 통과해야 allocation이 가능합니다. Cgroup이나 NUMA policy에 의한 제한도 global 총량과 다른 범위를 만들 수 있습니다.
예를 들어 낮은 주소의 zone에 free pages가 남아 있어도, 상위 zone의 요청이 그 자원을 마음대로 고갈시킬 수는 없습니다. Lowmem reserve는 특정 zone만 사용할 수 있는 요청을 보호합니다. free > min처럼 두 값만 비교하면 reserve를 빠뜨릴 수 있습니다.
Watermark boost도 함께 봐야 합니다. Fragmentation과 관련해 boost가 적용되면 판단에 쓰는 watermark가 달라집니다. 다만 어떤 출력이 이미 boost를 포함한 값을 표시하는지는 해당 version의 출력 구현을 확인해야 합니다. Log와 zoneinfo의 값을 섞어 놓고 boost를 두 번 더하지 않도록 주의해야 합니다.
Free가 남은 과거 report를 계산해 봅니다
책에 실린 과거 report는 kernel 6.0.0+, base page 4 KiB인 환경의 예입니다. 이 글을 위해 Linux v6.12에서 새로 실행한 실험이 아닙니다. Triggering allocation은 order 0이므로 높은 order block의 부족만으로 원인을 설명할 수 없습니다.
Normal zone에는 free 42,176 KiB가 있지만 min은 42,304 KiB입니다. Free가 0이 아니어도 min보다 128 KiB 부족합니다. DMA zone에는 free가 15,360 KiB 남아 있지만, Normal-class 요청이 fallback할 때 보호하는 reserve를 함께 보아야 합니다.
그 report에서 DMA의 관련 reserve는 7,938 pages입니다. 이를 같은 단위로 맞추면 7,938 * 4 KiB = 31,752 KiB이고 min 124 KiB와 합친 단순 보호 기준은 31,876 KiB입니다. 따라서 free 15,360 KiB는 이 기준에도 못 미칩니다.
DMA32도 같은 방식으로 계산할 수 있습니다. 원래 zone log의 min은 25,148 KiB이고, Normal-class 요청에 대한 reserve는 4,978 pages입니다. 4,978 * 4 = 19,912 KiB를 더하면 45,060 KiB입니다. Free 44,940 KiB는 이 단순 비교에서 120 KiB 부족합니다.
| Zone | Log의 min | 관련 reserve | Min + reserve | Free |
|---|---|---|---|---|
| DMA | 124 KiB | 7938 * 4 = 31752 KiB |
31,876 KiB | 15,360 KiB |
| DMA32 | 25,148 KiB | 4978 * 4 = 19912 KiB |
45,060 KiB | 44,940 KiB |
| Normal | 42,304 KiB | 0 KiB | 42,304 KiB | 42,176 KiB |
이는 Normal-class fallback과 일반적인 min 비교를 가정한 계산입니다. 원본 Table 14-1·14-2의 DMA32 행에는 raw watermark와 reserve를 더한 값이 서로 섞여 있고 high 값의 오기도 있으므로, 여기서는 앞의 실제 zone log에서 다시 계산했습니다. Boost는 이 예제에서 0입니다. 다른 report에서는 출력한 watermark에 boost가 이미 들어 있는지 확인한 뒤 계산해야 합니다.
이 예는 남아 있는 free와 요청 가능한 memory가 다른 이유를 읽는 연습입니다. GFP 및 allocation flags, order별 조정과 사용할 수 없는 free memory 등을 포함하는 실제 watermark 판정을 이 표의 산술로 대체할 수는 없습니다. 예외적인 reserve 접근이나 다른 OOM domain까지 이 표 하나로 판정하는 것도 아닙니다.
마지막 victim 줄까지 연결해서 읽습니다
Report의 task 표와 victim 요약은 앞의 실패 요청과 다른 질문에 답합니다. Task 표에는 virtual size, RSS, page table memory, swap 관련 통계와 oom_score_adj 등이 나타납니다. 표의 어떤 필드는 pages, 다른 필드는 bytes 등 별도 단위일 수 있으므로 header를 기준으로 환산해야 합니다.
Linux의 thread도 task로 표현되지만, OOM report의 task 표가 언제나 모든 thread를 단순히 한 줄씩 출력한다고 가정해서는 안 됩니다. Shared mm을 사용하는 task의 처리와 표시 대상은 실제 dump_tasks() 구현에 따라 읽어야 합니다. Userspace에서 process를 찾을 때는 PID와 TGID의 의미도 구분해야 합니다.
일반적인 badness 계산에서는 RSS, swap entries, page table의 비용과 조정값이 중요합니다. 가장 큰 virtual address range를 가진 task가 반드시 선택되는 것은 아닙니다. OOM domain의 제한과 제외 조건도 적용됩니다.
마지막으로 선택된 victim의 PID, 이름, anonymous/file/shmem RSS와 page table 통계를 확인합니다. 큰 total-vm만 강조하지 말고 실제 resident 구성, swap, 보호 설정과 allocation의 제한 범위를 함께 보셔야 합니다. First line의 triggering task와 이 victim이 같을 수도 있지만, 같아야 하는 것은 아닙니다.
아래는 단위 변환을 연습하기 위한 독립적인 가상 task 표이며 실제 OOM 실행 기록이 아닙니다. 원래 report의 모든 task를 복제한 표도 아닙니다. Base page는 4 KiB로 가정했습니다.
| Task | total_vm (pages) |
rss (pages) |
pgtables_bytes (bytes) |
swapents (entries) |
oom_score_adj |
|---|---|---|---|---|---|
worker-a |
262144 | 8192 | 65536 | 512 | 0 |
worker-b |
32768 | 16384 | 131072 | 0 | -500 |
worker-a의 virtual size는 1 GiB이지만 RSS는 32 MiB입니다. Page table 비용은 65536 / 1024 = 64 KiB이며, 4 KiB page 단위 비용으로 보면 16 pages입니다. 일반적인 anonymous swap entry 512개는 2 MiB에 해당합니다. pgtables_bytes에 page 크기를 다시 곱하지 않는 것이 중요합니다. 반면 worker-b는 virtual size가 더 작아도 RSS가 64 MiB입니다. 여기서 두 task의 실제 victim 순위를 단정하지는 않겠습니다. OOM domain, 제외 조건, 조정값의 적용 범위가 더 필요합니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access edition, 2025, §14.4.1–14.4.2 및 §14.4.8.
- Linux v6.12
mm/oom_kill.c - Linux v6.12
mm/page_alloc.c