파일의 다음 page가 이미 page cache에 있어도 process가 그 주소에 처음 접근하면 PTE가 없어 fault가 날 수 있습니다. storage I/O를 앞당기는 readahead와 달리 fault-around는 이미 준비된 내용을 page table에 미리 연결하는 비용 절감입니다. 기다려야 할 대상을 건너뛰는 이유도 이 목적에서 나옵니다.
아래 설명은 upstream Linux v6.18의 do_fault_around()와 generic filemap_map_pages()를 기준으로 합니다. filesystem에 map_pages callback이 있어야 하고 architecture 및 large-folio 조건에 따라 설치 경로의 세부는 달라질 수 있습니다.
후보 범위부터 page-table 안으로 제한합니다
generic read fault는 fault 주소 주변의 여러 page를 한 번에 연결할 기회를 봅니다. 후보가 같은 PTE table 안에 있도록 제한하면 한 table의 lock을 잡고 여러 entry를 다룰 수 있습니다. 서로 다른 table로 넘어가며 lock 순서를 복잡하게 만들지 않으려는 선택입니다.
window 크기는 power of two이며 PTE table이 수용하는 page 수를 넘을 수 없습니다. 흔히 이야기하는 64 KiB는 4 KiB base page에서 16 page라는 예시이지 고정된 사용자 ABI는 아닙니다. fault_around_bytes를 노출하는 debugfs 설정 역시 일반 sysfs의 모든 시스템에 같은 형태로 존재한다고 가정하면 안 됩니다.
계산에서는 fault의 PTE offset을 window에 맞춰 내린 위치와 VMA 시작을 비교해 시작을 보정합니다. 그다음 보정한 시작에 window page 수를 더해 끝을 정하고 VMA 끝과 PTE table 끝으로 다시 제한합니다. 원래 정렬 window의 앞부분만 잘라 내는 계산과 다를 수 있습니다.
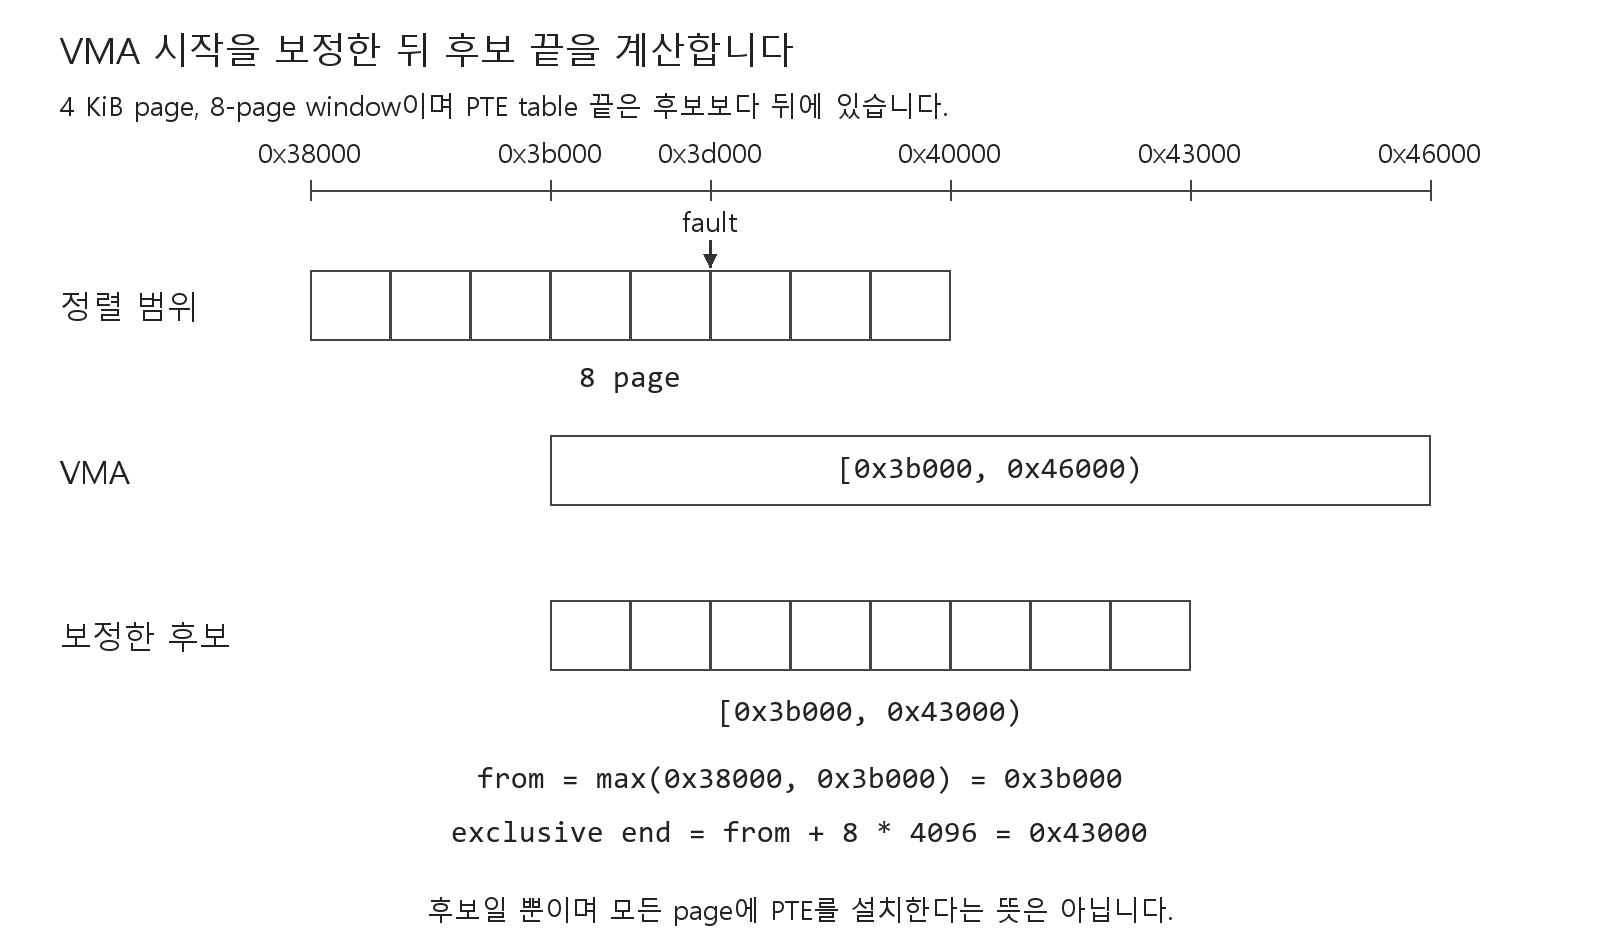
예시에서 fault는 0x3d000에 있고 정렬한 시작은 0x38000이지만 VMA 시작은 0x3b000입니다. 보정한 시작에 여덟 page를 더하면 후보 끝은 0x43000이 됩니다. VMA나 PTE table의 끝이 더 앞에 있다면 그 경계가 우선합니다. 내부 map_pages 전달 index의 inclusive end와 그림의 exclusive 주소 표현도 구별해야 합니다. 범위 계산 전체 구현
current 내부 설정 이름은 page 단위의 fault_around_pages입니다. byte 단위를 노출한 debugfs 이름과 내부 계산 단위를 섞어 비교하면 안 됩니다. should_fault_around()는 callback 존재 외에 userfaultfd 조건으로 최적화가 금지되었는지와 window가 1 page를 넘는지도 검사합니다. do_fault_around()는 PTE table이 없을 때 미리 할당할 수 있으며 실패하면 VM_FAULT_OOM입니다. storage I/O가 없다는 사실이 allocation까지 전혀 없다는 뜻은 아닙니다.
아래는 v6.18 mm/memory.c의 두 전체 함수입니다. source·GPL-2.0-only attribution을 보존한 kernel 발췌이며 standalone program은 아닙니다. callback 호출은 RCU read-side 구간 안에서 수행합니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.18 mm/memory.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/memory.c
 * Copyright (C) 1991, 1992, 1993, 1994 Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 */

static inline bool should_fault_around(struct vm_fault *vmf)
{
	/* No ->map_pages?  No way to fault around... */
	if (!vmf->vma->vm_ops->map_pages)
		return false;

	if (uffd_disable_fault_around(vmf->vma))
		return false;

	/* A single page implies no faulting 'around' at all. */
	return fault_around_pages > 1;
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.18 mm/memory.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/memory.c
 * Copyright (C) 1991, 1992, 1993, 1994 Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 */

static vm_fault_t do_fault_around(struct vm_fault *vmf)
{
	pgoff_t nr_pages = READ_ONCE(fault_around_pages);
	pgoff_t pte_off = pte_index(vmf->address);
	/* The page offset of vmf->address within the VMA. */
	pgoff_t vma_off = vmf->pgoff - vmf->vma->vm_pgoff;
	pgoff_t from_pte, to_pte;
	vm_fault_t ret;

	/* The PTE offset of the start address, clamped to the VMA. */
	from_pte = max(ALIGN_DOWN(pte_off, nr_pages),
		       pte_off - min(pte_off, vma_off));

	/* The PTE offset of the end address, clamped to the VMA and PTE. */
	to_pte = min3(from_pte + nr_pages, (pgoff_t)PTRS_PER_PTE,
		      pte_off + vma_pages(vmf->vma) - vma_off) - 1;

	if (pmd_none(*vmf->pmd)) {
		vmf->prealloc_pte = pte_alloc_one(vmf->vma->vm_mm);
		if (!vmf->prealloc_pte)
			return VM_FAULT_OOM;
	}

	rcu_read_lock();
	ret = vmf->vma->vm_ops->map_pages(vmf,
			vmf->pgoff + from_pte - pte_off,
			vmf->pgoff + to_pte - pte_off);
	rcu_read_unlock();

	return ret;
}
lookup은 기다리지 않을 대상을 먼저 고릅니다
filemap_map_pages()는 mapping의 XArray를 RCU로 순회합니다. 현재의 next_uptodate_folio() 계열은 retry entry와 exceptional value를 구별하고 실제 folio에 nonzero 참조를 얻은 뒤 entry를 다시 확인합니다.
잠긴 folio는 기다리지 않습니다. trylock이 실패해도 건너뜁니다. lock을 얻은 뒤에는 mapping과 uptodate 상태를 다시 검사합니다. lookup과 lock 사이에 truncate가 개입할 수 있기 때문입니다. not-uptodate folio나 readahead marker 같은 조건도 이 빠른 최적화의 대상에서 빠질 수 있습니다.
이 경로에서 선택하지 않은 folio가 잘못된 데이터라는 뜻은 아닙니다. 단지 기다리거나 새 I/O를 해야 하는 작업을 일반 fault 경로에 맡긴 것입니다. 후보 window 안에 빈 구간이 있다고 그 hole을 storage에서 채우려고 하지 않습니다.
folio_try_get()은 nonzero 참조를 얻는 연산이지 folio lock을 얻는 연산이 아닙니다. 현재 helper는 참조를 먼저 확보한 뒤 locked 여부와 reload 결과를 검사하고, 내용이 유효하고 marker가 없는 대상에 별도로 folio_trylock()을 수행합니다. lock 뒤에도 mapping·uptodate·현재 EOF를 검사하며, lock 뒤 제외할 때에는 unlock과 put, lock 전 제외할 때에는 put을 합니다. not-uptodate 상태를 반드시 아직 한 번도 disk에서 읽지 않은 상태라고 단정하지도 않습니다.
다음은 v6.18의 next_uptodate_folio() 전체입니다. 입력 end는 inclusive이며 적합한 folio가 없으면 NULL입니다. caller의 RCU 구간 안에서 사용하고, 성공하면 잠긴 folio와 그 참조를 후속 설치 경로에 넘깁니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Copyright (C) 1994-1999  Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 * The book's exact source tag is not asserted.
 */

static struct folio *next_uptodate_folio(struct xa_state *xas,
		struct address_space *mapping, pgoff_t end_pgoff)
{
	struct folio *folio = xas_next_entry(xas, end_pgoff);
	unsigned long max_idx;

	do {
		if (!folio)
			return NULL;
		if (xas_retry(xas, folio))
			continue;
		if (xa_is_value(folio))
			continue;
		if (!folio_try_get(folio))
			continue;
		if (folio_test_locked(folio))
			goto skip;
		/* Has the page moved or been split? */
		if (unlikely(folio != xas_reload(xas)))
			goto skip;
		if (!folio_test_uptodate(folio) || folio_test_readahead(folio))
			goto skip;
		if (!folio_trylock(folio))
			goto skip;
		if (folio->mapping != mapping)
			goto unlock;
		if (!folio_test_uptodate(folio))
			goto unlock;
		max_idx = DIV_ROUND_UP(i_size_read(mapping->host), PAGE_SIZE);
		if (xas->xa_index >= max_idx)
			goto unlock;
		return folio;
unlock:
		folio_unlock(folio);
skip:
		folio_put(folio);
	} while ((folio = xas_next_entry(xas, end_pgoff)) != NULL);

	return NULL;
}
이전 API와 비교할 때에는 세 함수를 함께 읽어야 합니다. v6.0의 두 wrapper와 worker는 첫 검색에 xas_find(), 다음 검색에 xas_next_entry()를 사용합니다. 그 버전은 빠른 locked 검사를 nonzero ref 확보보다 먼저 수행합니다. 아래는 각 함수의 전체 정의이며 현재의 단일 cursor helper와 섞은 호출관계가 아닙니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.0 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.0/mm/filemap.c
 * Copyright (C) 1994-1999  Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 * The book's exact source tag is not asserted.
 */

static inline struct folio *first_map_page(struct address_space *mapping,
					  struct xa_state *xas,
					  pgoff_t end_pgoff)
{
	return next_uptodate_page(xas_find(xas, end_pgoff),
				  mapping, xas, end_pgoff);
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.0 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.0/mm/filemap.c
 * Copyright (C) 1994-1999  Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 * The book's exact source tag is not asserted.
 */

static inline struct folio *next_map_page(struct address_space *mapping,
					 struct xa_state *xas,
					 pgoff_t end_pgoff)
{
	return next_uptodate_page(xas_next_entry(xas, end_pgoff),
				  mapping, xas, end_pgoff);
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.0 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.0/mm/filemap.c
 * Copyright (C) 1994-1999  Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 * The book's exact source tag is not asserted.
 */

static struct folio *next_uptodate_page(struct folio *folio,
				       struct address_space *mapping,
				       struct xa_state *xas, pgoff_t end_pgoff)
{
	unsigned long max_idx;

	do {
		if (!folio)
			return NULL;
		if (xas_retry(xas, folio))
			continue;
		if (xa_is_value(folio))
			continue;
		if (folio_test_locked(folio))
			continue;
		if (!folio_try_get_rcu(folio))
			continue;
		/* Has the page moved or been split? */
		if (unlikely(folio != xas_reload(xas)))
			goto skip;
		if (!folio_test_uptodate(folio) || folio_test_readahead(folio))
			goto skip;
		if (!folio_trylock(folio))
			goto skip;
		if (folio->mapping != mapping)
			goto unlock;
		if (!folio_test_uptodate(folio))
			goto unlock;
		max_idx = DIV_ROUND_UP(i_size_read(mapping->host), PAGE_SIZE);
		if (xas->xa_index >= max_idx)
			goto unlock;
		return folio;
unlock:
		folio_unlock(folio);
skip:
		folio_put(folio);
	} while ((folio = xas_next_entry(xas, end_pgoff)) != NULL);

	return NULL;
}
file index와 virtual address를 연결합니다
cached folio는 파일의 index로 찾지만 설치할 PTE는 process의 virtual address로 정합니다. VMA 시작과 file offset의 관계를 이용해 두 좌표를 연결합니다. VMA가 이동했거나 file offset이 0이 아닌 mapping도 있으므로 folio->index를 그대로 virtual page number라고 생각해서는 안 됩니다.
large folio에서는 한 객체가 여러 base page를 나타냅니다. 필요한 subpage와 virtual address를 맞추어 설치하고, 조건이 허용하면 더 큰 단위로 처리하는 현재 분기도 있습니다. folio 참조 하나를 얻었다는 사실과 실제로 몇 PTE에 소유권을 연결했는지는 다른 계산입니다.
후보 범위에 적합한 folio가 하나도 없으면 최적화는 그냥 끝날 수 있습니다. 이 결과는 원래 fault를 해결할 수 없다는 판정이 아닙니다. 일반 fault 경로가 demand page를 별도로 준비할 기회가 남습니다.
PTE lock 아래에서도 기존 entry를 덮지 않습니다
page-table lock을 얻은 뒤에는 실제 target PTE가 비어 있는지 확인해야 합니다. 다른 실행 경로가 먼저 설치했거나 특별한 marker가 있다면 무조건 덮어쓸 수 없습니다. lookup 단계의 관찰과 PTE를 수정하는 단계의 직렬화가 따로 필요한 이유입니다.
설치할 때에는 page table entry뿐 아니라 RSS와 reverse mapping, reference accounting도 함께 맞춰야 합니다. lookup 참조를 사용한 PTE의 참조로 넘기거나 실제 설치에 쓰지 않은 참조는 내려놓습니다. folio lock을 풀었다고 process의 mapping 수명이 끝나는 것은 아닙니다.
architecture에 필요한 MMU cache 갱신도 수행합니다. 빈 PTE에 새 mapping을 넣는 일은 이미 있던 translation을 철회하는 unmap과 같지 않습니다. 그래서 이 경로의 갱신을 일반적인 TLB shootdown 설명으로 통째로 대체해서는 안 됩니다.
fault 주소 자체까지 설치했다면 generic caller가 같은 주소에 중복으로 page를 넣지 않도록 결과를 전달합니다. 함수 이름이나 반환 flag만 따로 보기보다, 어느 주소를 이미 처리했고 후속 fault가 무엇을 해야 하는지를 함께 읽어야 합니다. folio 선택과 PTE 설치
과거 loop의 vmf->address == addr 비교는 지금 준비한 target이 실제 fault 주소인지 묻습니다. 이 비교만으로 filesystem이 이미 PTE를 설치했다는 뜻은 아닙니다. 그 구현은 비어 있는 PTE를 확인한 뒤 fault 주소에 해당하면 결과를 VM_FAULT_NOPAGE로 정하고 바로 이어 실제 설치를 수행했습니다. 주소의 일치, 기존 PTE의 존재와 이번 설치의 완료를 구별해야 합니다.
현재 전체 함수에서는 먼저 얻은 folio 뒤에 파일 끝을 다시 계산해 후보 end를 줄이고, i_size를 넘는 PMD mapping을 피합니다. shmem/tmpfs의 별도 PMD 예외가 있으므로 모든 mapping에 하나의 거대 page 규칙을 적용하지 않습니다. PTE mapping 자체를 얻지 못한 경로도 folio를 unlock·put한 뒤 끝나며, order-0과 large-folio PTE 설치는 서로 다른 helper에 맡깁니다.
RSS는 실제 설치 결과를 모아 갱신합니다. mmap_miss도 후보 개수만큼 무조건 차감하는 것이 아니라 helper가 보고한 감소량을 마지막에 현재 counter와 비교해 0 아래로 내려가지 않게 반영합니다. 원본의 first/next-page wrapper와 직접 do_set_pte() loop를 v6.18의 동일한 호출 stack으로 오해하지 않도록 현재 전체 정의를 함께 읽는 편이 좋습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Copyright (C) 1994-1999 Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 */

vm_fault_t filemap_map_pages(struct vm_fault *vmf,
			     pgoff_t start_pgoff, pgoff_t end_pgoff)
{
	struct vm_area_struct *vma = vmf->vma;
	struct file *file = vma->vm_file;
	struct address_space *mapping = file->f_mapping;
	pgoff_t file_end, last_pgoff = start_pgoff;
	unsigned long addr;
	XA_STATE(xas, &mapping->i_pages, start_pgoff);
	struct folio *folio;
	vm_fault_t ret = 0;
	unsigned long rss = 0;
	unsigned int nr_pages = 0, folio_type;
	unsigned short mmap_miss = 0, mmap_miss_saved;

	rcu_read_lock();
	folio = next_uptodate_folio(&xas, mapping, end_pgoff);
	if (!folio)
		goto out;

	file_end = DIV_ROUND_UP(i_size_read(mapping->host), PAGE_SIZE) - 1;
	end_pgoff = min(end_pgoff, file_end);

	/*
	 * Do not allow to map with PMD across i_size to preserve
	 * SIGBUS semantics.
	 *
	 * Make an exception for shmem/tmpfs that for long time
	 * intentionally mapped with PMDs across i_size.
	 */
	if ((file_end >= folio_next_index(folio) || shmem_mapping(mapping)) &&
	    filemap_map_pmd(vmf, folio, start_pgoff)) {
		ret = VM_FAULT_NOPAGE;
		goto out;
	}

	addr = vma->vm_start + ((start_pgoff - vma->vm_pgoff) << PAGE_SHIFT);
	vmf->pte = pte_offset_map_lock(vma->vm_mm, vmf->pmd, addr, &vmf->ptl);
	if (!vmf->pte) {
		folio_unlock(folio);
		folio_put(folio);
		goto out;
	}

	folio_type = mm_counter_file(folio);
	do {
		unsigned long end;

		addr += (xas.xa_index - last_pgoff) << PAGE_SHIFT;
		vmf->pte += xas.xa_index - last_pgoff;
		last_pgoff = xas.xa_index;
		end = folio_next_index(folio) - 1;
		nr_pages = min(end, end_pgoff) - xas.xa_index + 1;

		if (!folio_test_large(folio))
			ret |= filemap_map_order0_folio(vmf,
					folio, addr, &rss, &mmap_miss);
		else
			ret |= filemap_map_folio_range(vmf, folio,
					xas.xa_index - folio->index, addr,
					nr_pages, &rss, &mmap_miss, file_end);

		folio_unlock(folio);
	} while ((folio = next_uptodate_folio(&xas, mapping, end_pgoff)) != NULL);
	add_mm_counter(vma->vm_mm, folio_type, rss);
	pte_unmap_unlock(vmf->pte, vmf->ptl);
	trace_mm_filemap_map_pages(mapping, start_pgoff, end_pgoff);
out:
	rcu_read_unlock();

	mmap_miss_saved = READ_ONCE(file->f_ra.mmap_miss);
	if (mmap_miss >= mmap_miss_saved)
		WRITE_ONCE(file->f_ra.mmap_miss, 0);
	else
		WRITE_ONCE(file->f_ra.mmap_miss, mmap_miss_saved - mmap_miss);

	return ret;
}
현재 구현에서 실제 설치와 참조의 인계를 맡은 helper도 함께 읽어야 합니다. 다음 세 함수 역시 같은 v6.18 source의 전체 정의입니다. PMD 경로는 이미 거대 mapping이 있거나 설치에 성공한 경우 folio lock과 caller 참조를 서로 다른 방식으로 정리하고, PTE 경로로 남으면 미리 할당한 table을 사용할 수 있습니다. true 반환을 단순히 새 PMD를 만들었다는 뜻으로만 읽어서는 안 됩니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 3608-3634
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static bool filemap_map_pmd(struct vm_fault *vmf, struct folio *folio,
		pgoff_t start)
{
	struct mm_struct *mm = vmf->vma->vm_mm;

	/* Huge page is mapped? No need to proceed. */
	if (pmd_trans_huge(*vmf->pmd)) {
		folio_unlock(folio);
		folio_put(folio);
		return true;
	}

	if (pmd_none(*vmf->pmd) && folio_test_pmd_mappable(folio)) {
		struct page *page = folio_file_page(folio, start);
		vm_fault_t ret = do_set_pmd(vmf, folio, page);
		if (!ret) {
			/* The page is mapped successfully, reference consumed. */
			folio_unlock(folio);
			return true;
		}
	}

	if (pmd_none(*vmf->pmd) && vmf->prealloc_pte)
		pmd_install(mm, vmf->pmd, &vmf->prealloc_pte);

	return false;
}
order-0 경로는 hardware-poison page와 비어 있지 않은 PTE를 제외하며, 설치하지 않을 때 caller 참조를 내립니다. mmap_miss 감소 후보는 workingset 여부를 보고 PTE 검사 전에 셀 수 있으므로 이 counter를 실제 새 PTE 수나 RSS와 같은 수량으로 보아서는 안 됩니다.
filemap_map_order0_folio_v6_18.c
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 3771-3804
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static vm_fault_t filemap_map_order0_folio(struct vm_fault *vmf,
		struct folio *folio, unsigned long addr,
		unsigned long *rss, unsigned short *mmap_miss)
{
	vm_fault_t ret = 0;
	struct page *page = &folio->page;

	if (PageHWPoison(page))
		goto out;

	/* See comment of filemap_map_folio_range() */
	if (!folio_test_workingset(folio))
		(*mmap_miss)++;

	/*
	 * NOTE: If there're PTE markers, we'll leave them to be
	 * handled in the specific fault path, and it'll prohibit
	 * the fault-around logic.
	 */
	if (!pte_none(ptep_get(vmf->pte)))
		goto out;

	if (vmf->address == addr)
		ret = VM_FAULT_NOPAGE;

	set_pte_range(vmf, folio, page, 1, addr);
	(*rss)++;
	return ret;

out:
	/* Locked folios cannot get truncated. */
	folio_ref_dec(folio);
	return ret;
}
large-folio 경로는 EOF·VMA·PTE-table 경계를 만족하면 처음 받은 부분 범위보다 넓게 folio 전체를 연결할 수도 있습니다. 중간의 poison이나 기존 PTE를 만나면 앞서 모은 연속 구간을 설치하고 제외할 page를 건너뜁니다. 설치 수만큼 RSS와 folio 참조를 조정하되 처음 받은 참조 하나를 재사용하며, 아무 설치에도 쓰지 못했다면 그 참조를 내립니다. 마지막에는 caller의 원래 PTE cursor도 복원합니다. 이 helper들을 수록했다고 architecture별 set_pte_range()나 모든 하위 의존성까지 standalone로 제공·compile했다는 뜻은 아닙니다.
filemap_map_folio_range_v6_18.c
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 3681-3769
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static vm_fault_t filemap_map_folio_range(struct vm_fault *vmf,
			struct folio *folio, unsigned long start,
			unsigned long addr, unsigned int nr_pages,
			unsigned long *rss, unsigned short *mmap_miss,
			pgoff_t file_end)
{
	struct address_space *mapping = folio->mapping;
	unsigned int ref_from_caller = 1;
	vm_fault_t ret = 0;
	struct page *page = folio_page(folio, start);
	unsigned int count = 0;
	pte_t *old_ptep = vmf->pte;
	unsigned long addr0;

	/*
	 * Map the large folio fully where possible:
	 *
	 *  - The folio is fully within size of the file or belong
	 *    to shmem/tmpfs;
	 *  - The folio doesn't cross VMA boundary;
	 *  - The folio doesn't cross page table boundary;
	 */
	addr0 = addr - start * PAGE_SIZE;
	if ((file_end >= folio_next_index(folio) || shmem_mapping(mapping)) &&
	    folio_within_vma(folio, vmf->vma) &&
	    (addr0 & PMD_MASK) == ((addr0 + folio_size(folio) - 1) & PMD_MASK)) {
		vmf->pte -= start;
		page -= start;
		addr = addr0;
		nr_pages = folio_nr_pages(folio);
	}

	do {
		if (PageHWPoison(page + count))
			goto skip;

		/*
		 * If there are too many folios that are recently evicted
		 * in a file, they will probably continue to be evicted.
		 * In such situation, read-ahead is only a waste of IO.
		 * Don't decrease mmap_miss in this scenario to make sure
		 * we can stop read-ahead.
		 */
		if (!folio_test_workingset(folio))
			(*mmap_miss)++;

		/*
		 * NOTE: If there're PTE markers, we'll leave them to be
		 * handled in the specific fault path, and it'll prohibit the
		 * fault-around logic.
		 */
		if (!pte_none(ptep_get(&vmf->pte[count])))
			goto skip;

		count++;
		continue;
skip:
		if (count) {
			set_pte_range(vmf, folio, page, count, addr);
			*rss += count;
			folio_ref_add(folio, count - ref_from_caller);
			ref_from_caller = 0;
			if (in_range(vmf->address, addr, count * PAGE_SIZE))
				ret = VM_FAULT_NOPAGE;
		}

		count++;
		page += count;
		vmf->pte += count;
		addr += count * PAGE_SIZE;
		count = 0;
	} while (--nr_pages > 0);

	if (count) {
		set_pte_range(vmf, folio, page, count, addr);
		*rss += count;
		folio_ref_add(folio, count - ref_from_caller);
		ref_from_caller = 0;
		if (in_range(vmf->address, addr, count * PAGE_SIZE))
			ret = VM_FAULT_NOPAGE;
	}

	vmf->pte = old_ptep;
	if (ref_from_caller)
		/* Locked folios cannot get truncated. */
		folio_ref_dec(folio);

	return ret;
}
readahead와의 차이는 남은 작업에 있습니다
readahead가 성공하면 cache에 내용이 준비될 가능성이 커집니다. fault-around가 성공하면 process가 그 내용에 접근하기 위한 PTE를 미리 얻게 됩니다. 하나가 다른 하나를 대신하지 않습니다.
따라서 sequential mmap의 성능을 볼 때 cache miss 수와 page fault 수가 함께 줄어야만 정상이라고 생각해서는 안 됩니다. 이미 RAM에 있는 내용에 PTE만 추가하는 fault가 남을 수 있고, 준비된 주변 page를 한 번에 연결해 그 비용을 줄일 수도 있습니다. fault-around는 이 두 번째 기회를 빠르고 비대기적으로 사용하는 최적화입니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 9, §9.8.
- Linux v6.18: do_fault_around, filemap_map_pages와 folio 선택.
- Linux v6.0: first_map_page, next_map_page, next_uptodate_page 비교 정의.