작은 allocation을 반복하는 프로그램에서 malloc()이 매번 system call을 수행하지는 않습니다. allocator는 이미 확보한 공간을 나누어 쓰다가 필요할 때 kernel에 주소 범위를 더 요청합니다. 전통적인 요청 방법이 program break를 옮기는 brk()입니다. 이때 allocator가 다루는 byte 단위 끝과 kernel이 mapping을 관리하는 page 단위 끝을 구분해야 동작을 이해할 수 있습니다.
ELF segment와 heap의 시작
실행 image의 .text에는 code, .rodata에는 read-only 정적 data, .data에는 초기화된 정적 data, .bss에는 zero 초기화할 data가 놓입니다. program break는 이 data 영역 뒤의 heap 끝을 나타냅니다. 실제 시작 위치에는 실행 image의 배치와 randomization도 관계하므로 모든 process에서 .bss 마지막 byte에 고정된다고 생각해서는 안 됩니다.
stack은 함수 호출의 자동 저장 공간이며, 성장 가능한 stack VMA에서는 fault가 확장 계기가 될 수 있습니다. 함수 반환 뒤에도 살아야 하거나 stack에 두기에는 큰 객체는 heap allocator의 관리 대상이 됩니다. allocator가 작은 요청에는 brk, 큰 요청에는 별도 mmap을 사용하는 것은 흔한 정책이지만 API가 강제하는 규칙은 아닙니다.
여기서 stack pointer의 이동과 stack VMA의 변경도 구분해야 합니다. 함수의 자동 변수, VLA, alloca()가 stack 공간을 사용할 수 있지만 함수 반환 때마다 kernel이 VMA를 축소하는 것은 아닙니다. ELF section의 순서 역시 process 배치를 이해하기 위한 출발점이며, shared library·별도 anonymous mapping까지 모두 main heap에 들어가는 것은 아닙니다.
sbrk(delta)는 break를 상대적으로 바꾸고 sbrk(0)은 현재 값을 조회하는 libc interface입니다. brk(addr)는 절대 주소를 지정합니다. kernel system call의 반환 규칙과 libc가 제공하는 성공·실패 규칙도 같지 않습니다. allocator와 별도로 이 interface를 호출하면 allocator가 소유한다고 믿는 범위를 변경할 수 있으므로 일반 application의 allocation 방법으로 섞어 쓰면 안 됩니다.
libc의 brk()는 성공하면 0, 실패하면 -1을 반환하고 errno를 설정합니다. sbrk()의 성공 값은 변경 전 break이며 실패 값은 (void *)-1입니다. 반면 Linux의 raw brk syscall은 일반적인 요청 거절을 기존 break의 반환으로 표현합니다. 요청 주소가 반환되지 않았는데도 음수가 아니라는 이유로 성공 처리하면 안 됩니다. mmap_lock의 killable 획득이 중단되는 경로처럼 syscall error를 반환하는 경우도 따로 있습니다.
같은 page 안에서는 byte 끝만 바뀝니다
kernel은 mm->brk를 byte 단위로 보관하지만 VMA는 page 단위입니다. 기존 break와 새 break를 PAGE_ALIGN()한 값이 같으면 새 page를 mapping할 필요가 없습니다. 다만 byte 단위 data limit 검사는 이 빠른 경로보다 먼저 해야 합니다. 그렇지 않으면 page 안에서 조금씩 늘리는 요청이 정렬되지 않은 RLIMIT_DATA 한계를 우회할 수 있습니다.
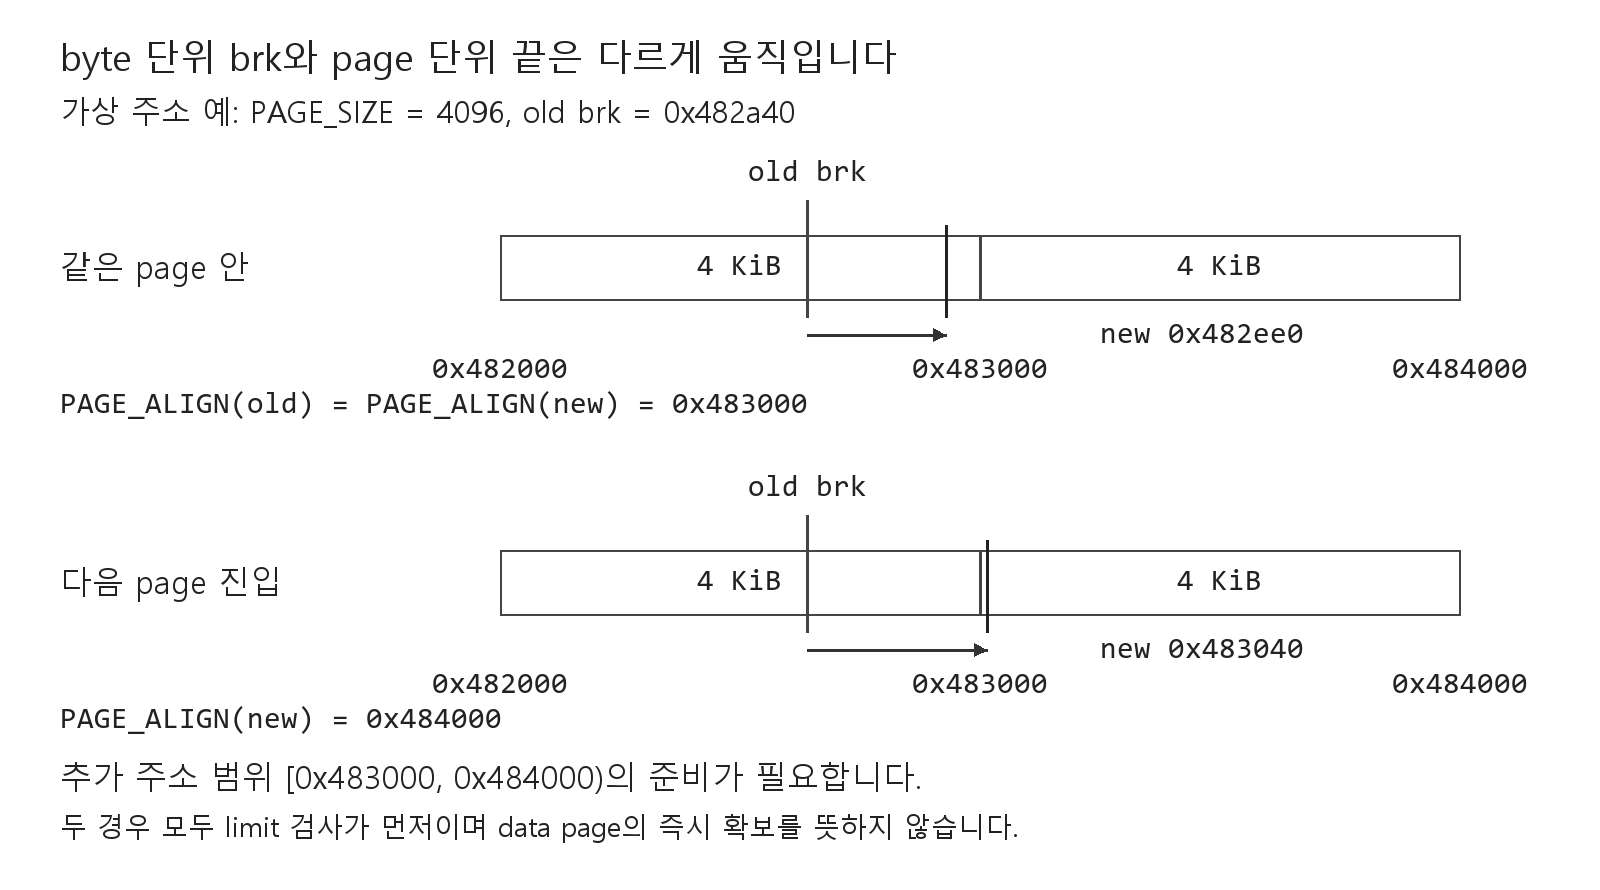
그림의 첫 요청은 0x482a40에서 0x482ee0으로 이동하지만 정렬된 끝은 모두 0x483000입니다. 두 번째 요청은 0x483040까지 이동하므로 [0x483000, 0x484000)을 유효한 범위에 추가해야 합니다. 이 추가가 곧 data page의 즉시 allocation을 뜻하지는 않습니다.
확장과 축소는 같은 작업이 아닙니다
break 변경은 VMA를 수정하므로 mmap_lock의 write 보호 아래 진행합니다. 축소는 줄어드는 정렬 범위를 unmap하고, 확장은 새 범위가 뒤의 VMA와 충돌하지 않는지 확인합니다. 다음 VMA가 downward stack이면 단순한 vm_start가 아니라 guard gap을 포함한 경계를 보아야 합니다. 빈 공간이 조금 남아 있다는 사실만으로 heap 확장을 허용할 수는 없습니다.
먼저 허용할 최소 break를 결정합니다. 실행 image의 start_brk와 data 끝, compatibility configuration 및 break randomization 상태가 이 판단에 관계합니다. 따라서 요청을 0에 가깝게 줄인다고 data segment까지 자유롭게 해제할 수는 없습니다. 정렬된 끝이 같은 경우에는 mm->brk만 바꾸지만, 실제 page 범위가 줄어들 때에는 unmap의 성공 여부까지 확인해야 합니다.
RB-tree 기반 syscall 경로는 축소 전에 origbrk를 보관하고 새 mm->brk를 먼저 기록합니다. 내부 unmap이 lock을 낮출 수 있기 때문입니다. unmap이 실패하면 기존 break를 복구하고 실패 경로로 나갑니다. 내부 반환 값 1은 이 경로에서 lock이 이미 downgrade되었다는 표시이지 사용자에게 돌려줄 break 값이 아닙니다. 그러므로 축소가 확장보다 단순하다는 말도 "어떤 실패도 없다"는 보장은 아닙니다. 확장에서는 다음 VMA의 guard-adjusted 시작과 새 끝 사이에 추가 page 여유까지 검사한 뒤 do_brk_flags()를 호출합니다.
RB-tree 기반 구현의 do_brk_flags()는 일반 mapping의 여러 절차를 공유합니다. 허용된 flags를 확인하고, 주소 범위와 memlock 한계를 검사하며, 다른 caller가 남겨 둔 겹침을 제거할 수 있습니다. brk syscall에서는 이미 빈 범위를 확인했지만 vm_brk_flags() 같은 다른 진입점까지 같은 전제라고 볼 수 없습니다.
이 helper에 caller가 추가할 수 있는 bit는 해당 구현에서 VM_EXEC뿐입니다. 기본 data flags, VM_ACCOUNT, mm->def_flags는 helper가 합칩니다. 기본 flags의 VM_MAYEXEC는 나중에 실행 권한을 부여할 수 있는 상한이며, 지금 VM_EXEC가 켜졌다는 뜻은 아닙니다. get_unmapped_area(..., MAP_FIXED)의 범위 검사, future-lock 한계와 겹침 제거를 통과한 뒤에야 확장량을 검사합니다. 따라서 다른 진입점에서는 기존 mapping을 지운 뒤 후속 검사가 실패할 수 있다는 순서도 중요합니다.
그 뒤에는 RLIMIT_AS·data accounting, VMA 개수 제한, commit 및 security 검사, 인접 VMA와의 merge 시도가 이어집니다. merge할 수 없으면 새 VMA를 allocation하여 anonymous 상태와 경계·offset·flags를 설정하고 주소 index에 연결합니다. 초기 vm_pgoff는 addr >> PAGE_SHIFT로 정하고 vm_page_prot는 VMA flags에서 계산합니다. 성공하면 virtual-memory 통계와 VM_SOFTDIRTY도 갱신합니다. 어느 검사에서 실패했는지에 따라 새 범위를 확보하지 못할 수 있으므로 break 값과 VMA 변경을 일관되게 복구해야 합니다.
commit 청구 뒤 vm_area_alloc()에 실패했다면 그 청구량을 vm_unacct_memory()로 되돌립니다. 성공 경로에서는 새 VMA를 만들었든 기존 VMA를 늘렸든 perf_event_mmap() 통지와 total_vm·data_vm, 필요한 locked_vm 증가가 이어집니다. VMA allocation을 생략한 merge도 새 virtual 범위를 공짜로 얻는 것은 아닙니다. syscall은 lock 해제 상태에 맞는 정리를 하고 userfaultfd 완료 통지를 처리한 뒤, 필요한 경우에만 population을 요청합니다.
MCL_FUTURE와 population의 방향
보통의 heap 확장은 demand paging으로 data page allocation을 미룹니다. mlockall(MCL_FUTURE)는 이후 mapping의 residency 정책에 영향을 주므로 locked 범위의 확장에는 memlock 검사가 추가됩니다. 이 정책을 “미리 fault하지 말라는 요청”으로 해석하면 반대가 됩니다. v6.18의 brk 구현은 성공한 확장에 VM_LOCKED가 적용되면 population을 요청합니다. on-fault locking은 별도의 정책 구분입니다.
이전 구현의 linked list·red/black VMA tree helper와 v6.18의 VMA iterator·Maple Tree helper는 같은 build의 호출 목록이 아닙니다. 유지되는 핵심은 byte limit을 먼저 검사하고, 주소 충돌과 accounting을 통과한 뒤 mapping을 변경하며, residency 작업은 그 성공과 구분한다는 점입니다.
v5.18 brk의 전체 진입점과 확장 함수
고전 RB-tree 경로를 실제 code로 읽으려면 syscall과 확장 helper를 함께 보는 편이 좋습니다. 아래 두 정의는 Linux v5.18 전체이며 생략한 분기는 없습니다. 책의 정확한 origin commit을 특정한 코드나 v6.18 구현이라고 제시하지 않습니다. tab을 네 칸 기준으로 표시하고 긴 선언 한 줄만 나누었습니다. 전체 source 파일은 v5.18 코드 묶음에서 받으실 수 있습니다. 각 파일의 원 header와 license를 보존했으며, 한국어 해설과 upstream code의 license는 구분합니다. 이 묶음은 kernel 전체 build tree나 userspace 실행 예제가 아닙니다.
SYSCALL_DEFINE1(brk)
공식 v5.18 mm/mmap.c, L195–L290 · 전체 source 파일
// SPDX-License-Identifier: GPL-2.0-only
/*
 * mm/mmap.c
 *
 * Written by obz.
 *
 * Address space accounting code    <alan@lxorguk.ukuu.org.uk>
 */
/* Linux v5.18: mm/mmap.c */
SYSCALL_DEFINE1(brk, unsigned long, brk)
{
    unsigned long newbrk, oldbrk, origbrk;
    struct mm_struct *mm = current->mm;
    struct vm_area_struct *next;
    unsigned long min_brk;
    bool populate;
    bool downgraded = false;
    LIST_HEAD(uf);

    if (mmap_write_lock_killable(mm))
        return -EINTR;

    origbrk = mm->brk;

#ifdef CONFIG_COMPAT_BRK
    /*
     * CONFIG_COMPAT_BRK can still be overridden by setting
     * randomize_va_space to 2, which will still cause mm->start_brk
     * to be arbitrarily shifted
     */
    if (current->brk_randomized)
        min_brk = mm->start_brk;
    else
        min_brk = mm->end_data;
#else
    min_brk = mm->start_brk;
#endif
    if (brk < min_brk)
        goto out;

    /*
     * Check against rlimit here. If this check is done later after the test
     * of oldbrk with newbrk then it can escape the test and let the data
     * segment grow beyond its set limit the in case where the limit is
     * not page aligned -Ram Gupta
     */
    if (check_data_rlimit(rlimit(RLIMIT_DATA), brk, mm->start_brk,
                  mm->end_data, mm->start_data))
        goto out;

    newbrk = PAGE_ALIGN(brk);
    oldbrk = PAGE_ALIGN(mm->brk);
    if (oldbrk == newbrk) {
        mm->brk = brk;
        goto success;
    }

    /*
     * Always allow shrinking brk.
     * __do_munmap() may downgrade mmap_lock to read.
     */
    if (brk <= mm->brk) {
        int ret;

        /*
         * mm->brk must to be protected by write mmap_lock so update it
         * before downgrading mmap_lock. When __do_munmap() fails,
         * mm->brk will be restored from origbrk.
         */
        mm->brk = brk;
        ret = __do_munmap(mm, newbrk, oldbrk-newbrk, &uf, true);
        if (ret < 0) {
            mm->brk = origbrk;
            goto out;
        } else if (ret == 1) {
            downgraded = true;
        }
        goto success;
    }

    /* Check against existing mmap mappings. */
    next = find_vma(mm, oldbrk);
    if (next && newbrk + PAGE_SIZE > vm_start_gap(next))
        goto out;

    /* Ok, looks good - let it rip. */
    if (do_brk_flags(oldbrk, newbrk-oldbrk, 0, &uf) < 0)
        goto out;
    mm->brk = brk;

success:
    populate = newbrk > oldbrk && (mm->def_flags & VM_LOCKED) != 0;
    if (downgraded)
        mmap_read_unlock(mm);
    else
        mmap_write_unlock(mm);
    userfaultfd_unmap_complete(mm, &uf);
    if (populate)
        mm_populate(oldbrk, newbrk - oldbrk);
    return brk;

out:
    mmap_write_unlock(mm);
    return origbrk;
}
CONFIG_COMPAT_BRK와 brk_randomized가 min_brk를 결정하는 분기, RLIMIT_DATA 검사, 같은 page의 빠른 경로를 순서대로 확인할 수 있습니다. 축소의 ret == 1은 __do_munmap()이 read lock으로 downgrade했다는 내부 신호입니다. 성공과 거절 모두 실제로 소유한 lock 종류에 맞게 종료합니다. expansion의 population은 lock과 userfaultfd 통지를 정리한 다음 진행합니다.
do_brk_flags()
공식 v5.18 mm/mmap.c, L2997–L3063 · 전체 source 파일
// SPDX-License-Identifier: GPL-2.0-only
/*
 * mm/mmap.c
 *
 * Written by obz.
 *
 * Address space accounting code    <alan@lxorguk.ukuu.org.uk>
 */
/* Linux v5.18: mm/mmap.c */
static int do_brk_flags(unsigned long addr, unsigned long len, unsigned long flags,
    struct list_head *uf)
{
    struct mm_struct *mm = current->mm;
    struct vm_area_struct *vma, *prev;
    struct rb_node **rb_link, *rb_parent;
    pgoff_t pgoff = addr >> PAGE_SHIFT;
    int error;
    unsigned long mapped_addr;

    /* Until we need other flags, refuse anything except VM_EXEC. */
    if ((flags & (~VM_EXEC)) != 0)
        return -EINVAL;
    flags |= VM_DATA_DEFAULT_FLAGS | VM_ACCOUNT | mm->def_flags;

    mapped_addr = get_unmapped_area(NULL, addr, len, 0, MAP_FIXED);
    if (IS_ERR_VALUE(mapped_addr))
        return mapped_addr;

    error = mlock_future_check(mm, mm->def_flags, len);
    if (error)
        return error;

    /* Clear old maps, set up prev, rb_link, rb_parent, and uf */
    if (munmap_vma_range(mm, addr, len, &prev, &rb_link, &rb_parent, uf))
        return -ENOMEM;

    /* Check against address space limits *after* clearing old maps... */
    if (!may_expand_vm(mm, flags, len >> PAGE_SHIFT))
        return -ENOMEM;

    if (mm->map_count > sysctl_max_map_count)
        return -ENOMEM;

    if (security_vm_enough_memory_mm(mm, len >> PAGE_SHIFT))
        return -ENOMEM;

    /* Can we just expand an old private anonymous mapping? */
    vma = vma_merge(mm, prev, addr, addr + len, flags,
            NULL, NULL, pgoff, NULL, NULL_VM_UFFD_CTX, NULL);
    if (vma)
        goto out;

    /*
     * create a vma struct for an anonymous mapping
     */
    vma = vm_area_alloc(mm);
    if (!vma) {
        vm_unacct_memory(len >> PAGE_SHIFT);
        return -ENOMEM;
    }

    vma_set_anonymous(vma);
    vma->vm_start = addr;
    vma->vm_end = addr + len;
    vma->vm_pgoff = pgoff;
    vma->vm_flags = flags;
    vma->vm_page_prot = vm_get_page_prot(flags);
    vma_link(mm, vma, prev, rb_link, rb_parent);
out:
    perf_event_mmap(vma);
    mm->total_vm += len >> PAGE_SHIFT;
    mm->data_vm += len >> PAGE_SHIFT;
    if (flags & VM_LOCKED)
        mm->locked_vm += (len >> PAGE_SHIFT);
    vma->vm_flags |= VM_SOFTDIRTY;
    return 0;
}
security_vm_enough_memory_mm() 통과 뒤 새 VMA allocation에 실패하면 commit을 되돌립니다. 반대로 merge 성공도 out에서 virtual 범위와 locked 통계를 증가시킵니다. 이 helper의 성공은 물리 page가 모두 준비되었다는 뜻이 아니며, syscall의 반환 break와도 구분해야 합니다.
참고 자료
Lorenzo Stoakes, The Linux Memory Manager, Chapter 5, §5.0.1. 현재 경계 검사와 population은 Linux v6.18 mm/mmap.c의 brk 구현, libc 반환 규칙은 brk(2)을 참고하실 수 있습니다.