RAM 범위의 시작과 끝이 1 GiB에 정렬되지 않았다면 전체를 1 GiB leaf로 덮을 수는 없습니다. 그렇다고 모든 부분을 4 KiB로 처리할 필요도 없습니다. 작은 head, 큰 middle, 다시 작은 tail로 나누면 alignment를 지키면서 table의 수를 줄일 수 있습니다.
이것이 direct map을 만드는 두 번째 문제입니다. 접근 가능한 RAM에서 table 공급지를 마련한 뒤에는 어떤 크기의 leaf로 어디까지 연결할지 결정해야 합니다. x86-64의 split_mem_range()와 하위 mapper를 upstream Linux v6.18 기준으로 읽겠습니다.
크기가 아니라 alignment 구간을 나눕니다
시작 주소가 2 MiB 경계에 못 미치면 먼저 4 KiB page로 그 경계까지 갑니다. 그 뒤 2 MiB로 다음 1 GiB 경계까지, 1 GiB로 큰 middle을, 남은 2 MiB tail과 마지막 4 KiB tail을 처리할 수 있습니다. 최대 다섯 구간이며 사용하는 page 크기는 세 종류입니다.
예를 들어 다음은 직접 고른 연습용 physical range입니다. 모든 큰 크기를 허용한다고 가정한 alignment 분할식이며, 실제 allocation이나 kernel 실행 trace가 아닙니다.
input: [0x00201000, 0x80201000)

4 KiB head: [0x00201000, 0x00400000)
2 MiB head: [0x00400000, 0x40000000)
1 GiB body: [0x40000000, 0x80000000)
2 MiB tail: [0x80000000, 0x80200000)
4 KiB tail: [0x80200000, 0x80201000)
입력은 [start, end)이고 end는 exclusive입니다. PFN으로 옮기는 PFN_DOWN()과 경계에 맞추는 round_up()·round_down()을 구분해야 합니다. byte 주소를 먼저 page 좌표로 바꾸었다면 이후 alignment의 단위도 그 좌표에 맞아야 합니다.
struct map_range는 start·end와 page_size_mask를 보관합니다. save_mr()는 빈 range를 저장하지 않고 배열 한계를 검사하며 다음 index를 돌려줍니다. caller가 모든 중간 구간에 별도의 부재 검사를 반복하지 않아도 되는 이유입니다.
저장할 유효한 구간이 있는데 nr_range >= NR_RANGE_MR이면 save_mr()는 panic으로 멈춥니다. array 밖에 쓰고 계속 진행하는 경로가 아닙니다. PFN을 인자로 받지만 구조체의 start·end에는 PAGE_SHIFT만큼 되돌린 byte 주소를 저장합니다. 따라서 동일한 필드 이름이 보여도 계산 중 PFN 좌표인지 저장된 byte 좌표인지 확인해야 합니다.
아래는 v6.18의 전체 map_range 선언과 전체 save_mr()입니다. 빈 입력은 record도 index 증가도 만들지 않습니다. caller가 받는 반환값은 저장한 range 수이지 마지막 physical 주소가 아닙니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:204-208
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete struct: map_range
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

struct map_range {
	unsigned long start;
	unsigned long end;
	unsigned page_size_mask;
};
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:327-341
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete function: save_mr
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

static int __meminit save_mr(struct map_range *mr, int nr_range,
			     unsigned long start_pfn, unsigned long end_pfn,
			     unsigned long page_size_mask)
{
	if (start_pfn < end_pfn) {
		if (nr_range >= NR_RANGE_MR)
			panic("run out of range for init_memory_mapping\n");
		mr[nr_range].start = start_pfn<<PAGE_SHIFT;
		mr[nr_range].end   = end_pfn<<PAGE_SHIFT;
		mr[nr_range].page_size_mask = page_size_mask;
		nr_range++;
	}

	return nr_range;
}
짧은 입력에서는 다섯 부분이 전부 생기지 않습니다. 첫 4 KiB head의 끝은 다음 2 MiB 경계와 입력 끝 중 작은 값입니다. 2 MiB head가 다음 1 GiB 경계까지 갈 수 없다면 입력 끝을 2 MiB 아래 경계로 내린 값을 끝으로 삼습니다. 1 GiB body는 시작을 위로, 끝을 아래로 맞춘 뒤 유효할 때만 저장합니다. 각 단계는 실제로 저장한 끝으로 cursor를 갱신하고 tail이 남은 부분을 받습니다. 처음부터 1 GiB가 들어갈 길이인지 별도로 가정하지 않아도 범위가 빠지지 않도록 하는 구조입니다.
허용 mask와 RAM 범위
정렬에 맞는 range라도 전역 policy가 1 GiB를 금지하면 그 크기로 mapping할 수 없습니다. split_mem_range()는 각 구간에 전역 page_size_mask를 적용합니다. 큰 경계로 나눴다는 사실은 그 크기의 leaf를 반드시 만든다는 보장이 아닙니다.
1 GiB body의 mask도 1 GiB만을 뜻하지 않습니다. 전역 mask와 2 MiB·1 GiB 후보의 합집합을 AND하므로 큰 leaf가 불가능할 때 내려갈 작은 크기의 허용도 함께 남습니다. head·tail의 2 MiB 후보는 해당 bit만 검사하고 4 KiB 부분은 큰 크기 mask가 0입니다. 정렬 구간의 이름과 실제 허용 크기의 집합을 분리해야 이 fallback이 보입니다.
초기 boot에서는 adjust_range_page_size_mask()가 한 번 더 검토합니다. 작은 요청 구간을 큰 alignment로 바깥까지 확장해 보았을 때 그 전체가 실제 memory인지 확인할 수 있으면 더 큰 크기를 허용합니다. 요청 경계 밖의 RAM까지 같은 leaf로 표현해도 되는지 보는 판단입니다.
이 판단은 alignment만으로 physical hole을 RAM으로 만드는 것이 아닙니다. memblock_is_region_memory() 같은 범위 조건이 필요합니다. 큰 leaf가 이미 설치된 부분을 뒤 구간에서 다시 만날 수 있으므로 하위 mapper도 기존 entry를 재사용할 수 있어야 합니다.
adjust_range_page_size_mask()를 부르는 조건은 !after_bootmem입니다. buddy allocator를 사용하는 이후 단계에 이 조정을 무조건 반복하는 알고리즘은 아닙니다. 또한 각 크기를 추가할 때 전역 policy가 그 크기를 허용하는지, 현재 구간에 그 bit가 아직 없는지부터 확인합니다. RAM이 이어져 있다는 이유만으로 boot에서 금지한 1 GiB policy를 다시 켜지는 않습니다.
32-bit에는 추가 경계가 있습니다. 2 MiB 후보를 추가하려고 바깥 정렬한 end가 max_low_pfn을 넘으면 continue로 현재 record의 나머지 검사까지 건너뜁니다. 단순히 해당 bit의 OR만 생략하는 분기가 아닙니다. 아래 v6.18 전체 adjust_range_page_size_mask()에는 이 build 분기도 포함돼 있습니다. 주로 x86-64의 큰 leaf를 설명하더라도 shared source 안의 32-bit 제한을 없던 것으로 읽지 않습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:347-375
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete function: adjust_range_page_size_mask
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

static void __ref adjust_range_page_size_mask(struct map_range *mr,
							 int nr_range)
{
	int i;

	for (i = 0; i < nr_range; i++) {
		if ((page_size_mask & (1<<PG_LEVEL_2M)) &&
		    !(mr[i].page_size_mask & (1<<PG_LEVEL_2M))) {
			unsigned long start = round_down(mr[i].start, PMD_SIZE);
			unsigned long end = round_up(mr[i].end, PMD_SIZE);

#ifdef CONFIG_X86_32
			if ((end >> PAGE_SHIFT) > max_low_pfn)
				continue;
#endif

			if (memblock_is_region_memory(start, end - start))
				mr[i].page_size_mask |= 1<<PG_LEVEL_2M;
		}
		if ((page_size_mask & (1<<PG_LEVEL_1G)) &&
		    !(mr[i].page_size_mask & (1<<PG_LEVEL_1G))) {
			unsigned long start = round_down(mr[i].start, PUD_SIZE);
			unsigned long end = round_up(mr[i].end, PUD_SIZE);

			if (memblock_is_region_memory(start, end - start))
				mr[i].page_size_mask |= 1<<PG_LEVEL_1G;
		}
	}
}
마지막에는 주소가 이어지고 mask가 같은 인접 구간을 합칩니다. 1 GiB를 금지해 head·tail이 모두 2 MiB policy가 된 경우처럼 원래 나누었던 이유가 사라질 수 있기 때문입니다. NR_RANGE_MR은 이 작업의 보조 구간 용량이지 가능한 physical page 크기의 개수가 아닙니다.
merge는 앞 구간의 start를 보존하고 뒤의 record들을 앞으로 옮긴 다음 range 수를 줄입니다. 같은 위치에서 새 이웃을 다시 비교하므로 세 구간 이상이 연속으로 합쳐지는 경우도 처리합니다. 마지막 debug 출력은 end에서 1을 뺀 inclusive 표시와 가장 큰 허용 크기 문자열을 사용하지만 내부 range는 end-exclusive이며 문자열이 최종 leaf 설치 내역을 실측한 값은 아닙니다. split_mem_range() 전체에서 조정·merge·출력의 순서를 구별할 수 있습니다.
전체 split_mem_range()의 시작에는 또 다른 32-bit 예외가 있습니다. 처음 PFN이 0이면 첫 PMD 크기 구간을 작은 page로 처리하여, 고정 범위 MTRR이 걸리는 낮은 1 MiB와 그 위 영역을 큰 page 하나에 섞는 문제를 피합니다. x86-32의 PAE 여부에 따라 PMD 크기 자체도 달라질 수 있으므로 이를 모든 architecture의 고정된 2 MiB 규칙이라고 일반화하지 않습니다.
아래는 v6.18 split_mem_range() 전체입니다. head와 tail을 별도 불완전 함수로 잘라 보여 주지 않습니다. 앞의 다섯 구간 예제는 이 전체 함수 중 x86-64의 alignment 분할을 읽기 위한 것으로, 32-bit 특별 처리나 뒤의 mask 조정·merge까지 실행한 결과는 아닙니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:402-500
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete function: split_mem_range
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

static int __meminit split_mem_range(struct map_range *mr, int nr_range,
				     unsigned long start,
				     unsigned long end)
{
	unsigned long start_pfn, end_pfn, limit_pfn;
	unsigned long pfn;
	int i;

	limit_pfn = PFN_DOWN(end);

	/* head if not big page alignment ? */
	pfn = start_pfn = PFN_DOWN(start);
#ifdef CONFIG_X86_32
	/*
	 * Don't use a large page for the first 2/4MB of memory
	 * because there are often fixed size MTRRs in there
	 * and overlapping MTRRs into large pages can cause
	 * slowdowns.
	 */
	if (pfn == 0)
		end_pfn = PFN_DOWN(PMD_SIZE);
	else
		end_pfn = round_up(pfn, PFN_DOWN(PMD_SIZE));
#else /* CONFIG_X86_64 */
	end_pfn = round_up(pfn, PFN_DOWN(PMD_SIZE));
#endif
	if (end_pfn > limit_pfn)
		end_pfn = limit_pfn;
	if (start_pfn < end_pfn) {
		nr_range = save_mr(mr, nr_range, start_pfn, end_pfn, 0);
		pfn = end_pfn;
	}

	/* big page (2M) range */
	start_pfn = round_up(pfn, PFN_DOWN(PMD_SIZE));
#ifdef CONFIG_X86_32
	end_pfn = round_down(limit_pfn, PFN_DOWN(PMD_SIZE));
#else /* CONFIG_X86_64 */
	end_pfn = round_up(pfn, PFN_DOWN(PUD_SIZE));
	if (end_pfn > round_down(limit_pfn, PFN_DOWN(PMD_SIZE)))
		end_pfn = round_down(limit_pfn, PFN_DOWN(PMD_SIZE));
#endif

	if (start_pfn < end_pfn) {
		nr_range = save_mr(mr, nr_range, start_pfn, end_pfn,
				page_size_mask & (1<<PG_LEVEL_2M));
		pfn = end_pfn;
	}

#ifdef CONFIG_X86_64
	/* big page (1G) range */
	start_pfn = round_up(pfn, PFN_DOWN(PUD_SIZE));
	end_pfn = round_down(limit_pfn, PFN_DOWN(PUD_SIZE));
	if (start_pfn < end_pfn) {
		nr_range = save_mr(mr, nr_range, start_pfn, end_pfn,
				page_size_mask &
				 ((1<<PG_LEVEL_2M)|(1<<PG_LEVEL_1G)));
		pfn = end_pfn;
	}

	/* tail is not big page (1G) alignment */
	start_pfn = round_up(pfn, PFN_DOWN(PMD_SIZE));
	end_pfn = round_down(limit_pfn, PFN_DOWN(PMD_SIZE));
	if (start_pfn < end_pfn) {
		nr_range = save_mr(mr, nr_range, start_pfn, end_pfn,
				page_size_mask & (1<<PG_LEVEL_2M));
		pfn = end_pfn;
	}
#endif

	/* tail is not big page (2M) alignment */
	start_pfn = pfn;
	end_pfn = limit_pfn;
	nr_range = save_mr(mr, nr_range, start_pfn, end_pfn, 0);

	if (!after_bootmem)
		adjust_range_page_size_mask(mr, nr_range);

	/* try to merge same page size and continuous */
	for (i = 0; nr_range > 1 && i < nr_range - 1; i++) {
		unsigned long old_start;
		if (mr[i].end != mr[i+1].start ||
		    mr[i].page_size_mask != mr[i+1].page_size_mask)
			continue;
		/* move it */
		old_start = mr[i].start;
		memmove(&mr[i], &mr[i+1],
			(nr_range - 1 - i) * sizeof(struct map_range));
		mr[i--].start = old_start;
		nr_range--;
	}

	for (i = 0; i < nr_range; i++)
		pr_debug(" [mem %#010lx-%#010lx] page %s\n",
				mr[i].start, mr[i].end - 1,
				page_size_string(&mr[i]));

	return nr_range;
}
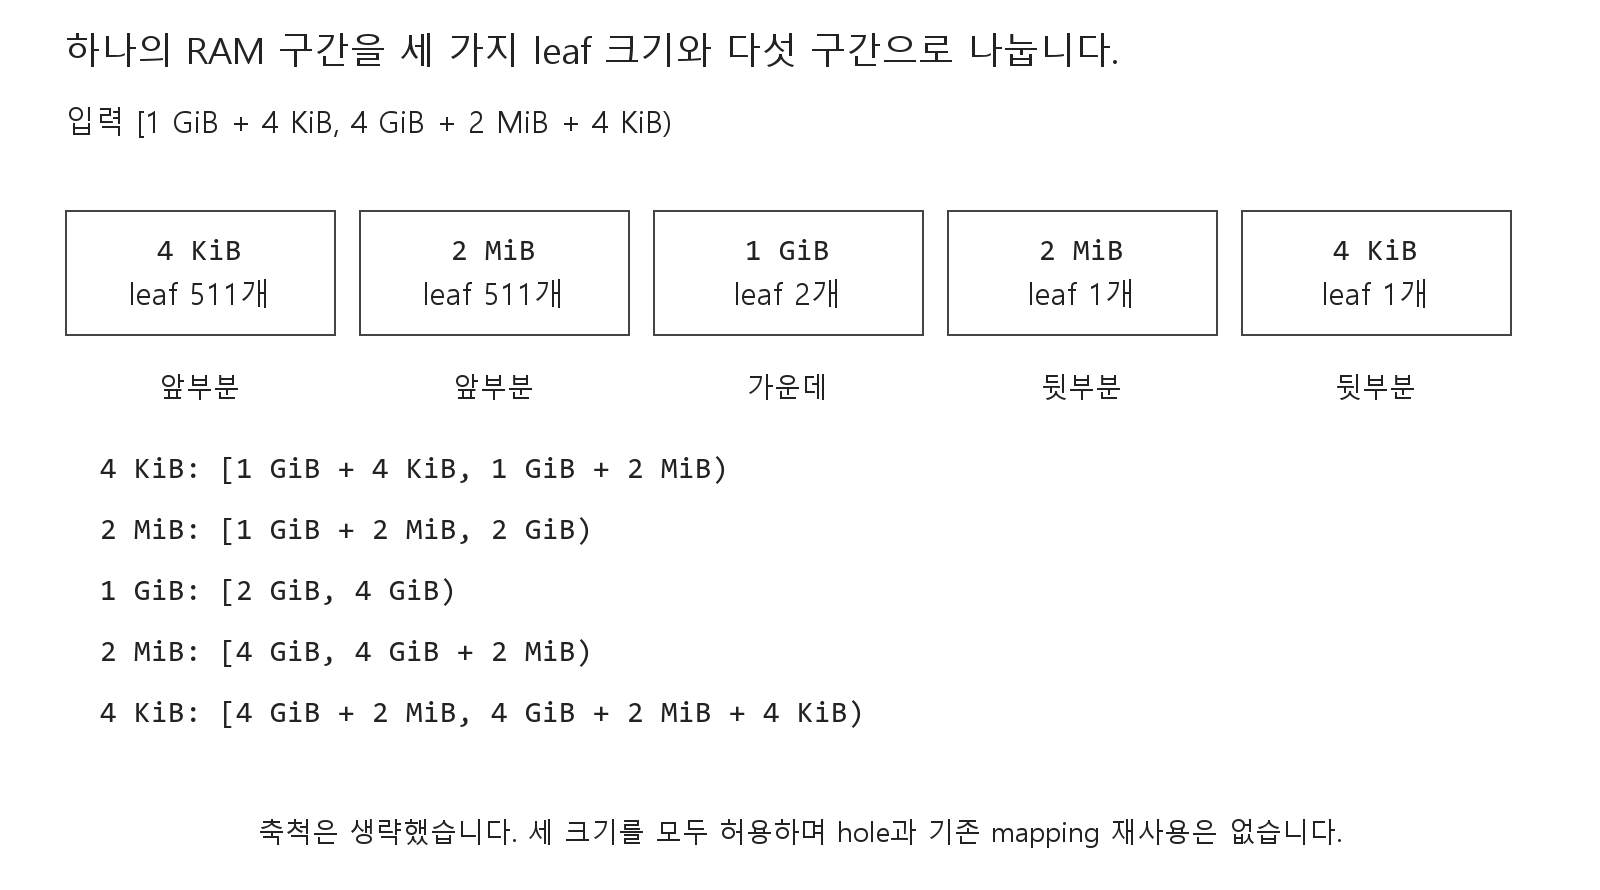
그림은 위 산술 예제와 다른 [1 GiB + 4 KiB, 4 GiB + 2 MiB + 4 KiB) 입력입니다. 같은 다섯 구간의 원리를 보여 주며, 모든 큰 크기를 허용하고 firmware hole, 기존 mapping과 mask 조정은 생략했습니다.
PGD부터 다시 쓰는 조건
kernel_physical_mapping_init() 아래는 physical 입력을 direct-map virtual 범위로 바꾸어 PGD 경계를 순회합니다. 이미 하위 table이 있다면 그 table을 얻어 필요한 부분을 채웁니다. 없다면 alloc_low_page()로 새 table을 준비한 뒤 entry를 공개합니다.
상위 init_memory_mapping()은 map_range 배열을 0으로 초기화하고 분할 결과를 하나씩 하위 mapper에 넘깁니다. 각 반환값은 mapping한 마지막 physical 끝이며, 마지막 결과를 add_pfn_range_mapped()에 PFN으로 기록하고 PFN 단위로 반환합니다. 바로 위 init_range_memory_mapping()이 반환하는 mapped RAM의 byte 수와는 다릅니다. end PFN을 mapped page 개수로 착각하면 시작 주소가 0이 아닌 range에서 계산이 틀어집니다.
그 단위 전환은 전체 init_memory_mapping()의 마지막 두 줄에서 확인할 수 있습니다. prot은 caller가 넘긴 값을 각 하위 호출로 전달하며, 함수가 모든 요청을 내부에서 무조건 PAGE_KERNEL로 바꾸는 것은 아닙니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:535-556
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete function: init_memory_mapping
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

unsigned long __ref init_memory_mapping(unsigned long start,
					unsigned long end, pgprot_t prot)
{
	struct map_range mr[NR_RANGE_MR];
	unsigned long ret = 0;
	int nr_range, i;

	pr_debug("init_memory_mapping: [mem %#010lx-%#010lx]\n",
	       start, end - 1);

	memset(mr, 0, sizeof(mr));
	nr_range = split_mem_range(mr, 0, start, end);

	for (i = 0; i < nr_range; i++)
		ret = kernel_physical_mapping_init(mr[i].start, mr[i].end,
						   mr[i].page_size_mask,
						   prot);

	add_pfn_range_mapped(start >> PAGE_SHIFT, ret >> PAGE_SHIFT);

	return ret >> PAGE_SHIFT;
}
여기까지 추가한 init.c의 struct와 함수는 모두 공식 v6.18 source 그대로입니다. 개별 SPDX가 없는 source이므로 COPYING에 따른 GPL-2.0-only로 구별하고 source 범위·hash, license text를 제공합니다. 책에서 사용한 정확한 tag와 같다는 claim은 하지 않으며 kernel 내부 의존성은 별도입니다. 실행 실험을 수행한 code가 아닙니다.
*_init 계열은 초기화 문맥을 전달하며 entry를 안전하게 설정하는 역할을 합니다. 기존 entry를 전혀 다른 하위 table로 덮는 상황을 정상적인 재설치로 취급해서는 안 됩니다. mapping 재사용과 잘못된 교체를 구별해야 table leak과 translation 불일치를 막을 수 있습니다.
현재 wrapper는 __kernel_physical_mapping_init()에 init=true를 전달합니다. 새 table을 채운 뒤 init_mm.page_table_lock 아래 부모에 연결하며, 새 상위 연결이 생겼을 때에만 pgd_changed를 세워 root 동기화를 요청합니다. init이 선택하는 safe setter는 기존 present entry를 다른 값으로 덮는 상황을 경고하는 전제를 담고 있습니다. TLB flush까지 자동으로 해 주는 보편적인 교체 API는 아닙니다. 변경용 kernel_physical_mapping_change()는 별도의 문맥이며 caller의 TLB flush 책임도 다릅니다. init_64.c의 wrapper와 본체를 한 쌍으로 읽어야 하는 이유입니다.
5-level이면 P4D table을 실제로 내려가고 4-level이면 folded P4D를 거쳐 PUD로 연결합니다. 실제 table을 하나 더 할당하는지와 공통 helper가 어느 이름을 사용하는지를 구별해야 합니다. 전체 흐름은 다음과 같지만 모든 helper를 나열한 구현은 아닙니다.
init_memory_mapping()
  split_mem_range()
  kernel_physical_mapping_init()
    __kernel_physical_mapping_init()
      phys_p4d_init()
        phys_pud_init()
          phys_pmd_init()
            phys_pte_init()
이 블록은 구현코드가 아닌 호출관계입니다. leaf를 만나면 그 아래 table을 만들지 않을 수 있고, 기존 mapping을 재사용하면 allocation도 생략합니다.
아래는 v6.18 init_64.c의 wrapper와 본체를 생략 없이 분리한 것입니다. source의 GPL-2.0-only와 copyright notice를 각 파일에 유지했으며 출처·범위 기록, license text를 제공합니다. kernel 내부 의존성을 포함하는 standalone program은 아니고 실행하지 않았습니다.
kernel_physical_mapping_init.c
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:800-807
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: kernel_physical_mapping_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

unsigned long __meminit
kernel_physical_mapping_init(unsigned long paddr_start,
			     unsigned long paddr_end,
			     unsigned long page_size_mask, pgprot_t prot)
{
	return __kernel_physical_mapping_init(paddr_start, paddr_end,
					      page_size_mask, prot, true);
}
__kernel_physical_mapping_init.c
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:743-791
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: __kernel_physical_mapping_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static unsigned long __meminit
__kernel_physical_mapping_init(unsigned long paddr_start,
			       unsigned long paddr_end,
			       unsigned long page_size_mask,
			       pgprot_t prot, bool init)
{
	bool pgd_changed = false;
	unsigned long vaddr, vaddr_start, vaddr_end, vaddr_next, paddr_last;

	paddr_last = paddr_end;
	vaddr = (unsigned long)__va(paddr_start);
	vaddr_end = (unsigned long)__va(paddr_end);
	vaddr_start = vaddr;

	for (; vaddr < vaddr_end; vaddr = vaddr_next) {
		pgd_t *pgd = pgd_offset_k(vaddr);
		p4d_t *p4d;

		vaddr_next = (vaddr & PGDIR_MASK) + PGDIR_SIZE;

		if (pgd_val(*pgd)) {
			p4d = (p4d_t *)pgd_page_vaddr(*pgd);
			paddr_last = phys_p4d_init(p4d, __pa(vaddr),
						   __pa(vaddr_end),
						   page_size_mask,
						   prot, init);
			continue;
		}

		p4d = alloc_low_page();
		paddr_last = phys_p4d_init(p4d, __pa(vaddr), __pa(vaddr_end),
					   page_size_mask, prot, init);

		spin_lock(&init_mm.page_table_lock);
		if (pgtable_l5_enabled())
			pgd_populate_init(&init_mm, pgd, p4d, init);
		else
			p4d_populate_init(&init_mm, p4d_offset(pgd, vaddr),
					  (pud_t *) p4d, init);

		spin_unlock(&init_mm.page_table_lock);
		pgd_changed = true;
	}

	if (pgd_changed)
		sync_global_pgds(vaddr_start, vaddr_end - 1);

	return paddr_last;
}
같은 kernel root를 여러 process에 반영합니다
process마다 PGD가 있으므로 kernel 상위 entry를 새로 만들면 다른 root도 같은 kernel table에 도달할 수 있어야 합니다. 기존 entry가 가리키던 하위 table을 공유하는 경우와, root에서 새 pointer를 연결해야 하는 경우는 다릅니다.
sync_global_pgds()는 4/5-level에 맞는 경로를 고릅니다. 5-level 경로는 기준 kernel PGD와 pgd_list의 root들을 대조합니다. list는 pgd_lock으로, 관련 entry 작업은 해당 경로의 mm lock으로 보호합니다. constructor·destructor가 list에 root를 추가·제거하는 일도 이 보호와 연결됩니다.
source와 target이 둘 다 nonempty일 때 서로 다른 하위 table을 가리키면 오류입니다. 현재 코드는 그 주소 관계를 검사하고, target이 비어 있을 때 기준 entry를 설치합니다. 이미 nonempty인 entry를 무조건 덮어쓰는 복사 loop로 읽으면 안 됩니다.
mapper의 입력 end는 보통 exclusive이지만 이 동기화 함수의 range 계약에는 inclusive end가 사용됩니다. 경계 helper와 overflow 검사가 그 차이를 처리합니다. 끝 주소 숫자를 서로 다른 함수 사이에서 그대로 재사용해도 된다는 뜻이 아닙니다.
동기화가 boot에서만 필요하다는 주장도 성립하지 않습니다. 확인한 arch_sync_kernel_mappings()는 이 경로를 연결하고 vmalloc 등은 ARCH_PAGE_TABLE_SYNC_MASK로 필요한 상위 변경을 알립니다. 4-level에서는 folded PGD만 보지 않고 P4D 측 동기화를 고려하는 이유도 여기에 있습니다.
5-level 구현은 다음 PGD 경계로 진행하다 unsigned wrap으로 addr < start가 되면 멈춥니다. 비어 있는 기준 entry는 건너뛰고, pgd_lock을 잡은 상태에서 pgd_list를 순회합니다. 각 mm의 page-table lock에 붙은 Xen 관련 comment는 해당 보호의 역사적 이유를 설명하며, 모든 data-page 작업을 이 lock이 보호한다는 뜻은 아닙니다. 같은 하위 table을 가리키는 nonempty entry는 그대로 두고 empty target만 채웁니다.
4-level에서는 folded PGD의 pgd_none()이 항상 false인 점 때문에 P4D를 실제 비교 대상으로 사용합니다. 아래 dispatcher와 두 전체 함수는 같은 공통 목적을 서로 다른 실제 level에서 수행합니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:218-224
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: sync_global_pgds
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static void sync_global_pgds(unsigned long start, unsigned long end)
{
	if (pgtable_l5_enabled())
		sync_global_pgds_l5(start, end);
	else
		sync_global_pgds_l4(start, end);
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:133-168
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: sync_global_pgds_l5
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static void sync_global_pgds_l5(unsigned long start, unsigned long end)
{
	unsigned long addr;

	for (addr = start; addr <= end; addr = ALIGN(addr + 1, PGDIR_SIZE)) {
		const pgd_t *pgd_ref = pgd_offset_k(addr);
		struct page *page;

		/* Check for overflow */
		if (addr < start)
			break;

		if (pgd_none(*pgd_ref))
			continue;

		spin_lock(&pgd_lock);
		list_for_each_entry(page, &pgd_list, lru) {
			pgd_t *pgd;
			spinlock_t *pgt_lock;

			pgd = (pgd_t *)page_address(page) + pgd_index(addr);
			/* the pgt_lock only for Xen */
			pgt_lock = &pgd_page_get_mm(page)->page_table_lock;
			spin_lock(pgt_lock);

			if (!pgd_none(*pgd_ref) && !pgd_none(*pgd))
				BUG_ON(pgd_page_vaddr(*pgd) != pgd_page_vaddr(*pgd_ref));

			if (pgd_none(*pgd))
				set_pgd(pgd, *pgd_ref);

			spin_unlock(pgt_lock);
		}
		spin_unlock(&pgd_lock);
	}
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:170-212
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: sync_global_pgds_l4
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static void sync_global_pgds_l4(unsigned long start, unsigned long end)
{
	unsigned long addr;

	for (addr = start; addr <= end; addr = ALIGN(addr + 1, PGDIR_SIZE)) {
		pgd_t *pgd_ref = pgd_offset_k(addr);
		const p4d_t *p4d_ref;
		struct page *page;

		/*
		 * With folded p4d, pgd_none() is always false, we need to
		 * handle synchronization on p4d level.
		 */
		MAYBE_BUILD_BUG_ON(pgd_none(*pgd_ref));
		p4d_ref = p4d_offset(pgd_ref, addr);

		if (p4d_none(*p4d_ref))
			continue;

		spin_lock(&pgd_lock);
		list_for_each_entry(page, &pgd_list, lru) {
			pgd_t *pgd;
			p4d_t *p4d;
			spinlock_t *pgt_lock;

			pgd = (pgd_t *)page_address(page) + pgd_index(addr);
			p4d = p4d_offset(pgd, addr);
			/* the pgt_lock only for Xen */
			pgt_lock = &pgd_page_get_mm(page)->page_table_lock;
			spin_lock(pgt_lock);

			if (!p4d_none(*p4d_ref) && !p4d_none(*p4d))
				BUG_ON(p4d_pgtable(*p4d)
				       != p4d_pgtable(*p4d_ref));

			if (p4d_none(*p4d))
				set_p4d(p4d, *p4d_ref);

			spin_unlock(pgt_lock);
		}
		spin_unlock(&pgd_lock);
	}
}
alloc_low_pages의 두 시대
after_bootmem 전에는 일반 buddy allocator를 사용할 수 없으므로 초기 buffer 또는 memblock이 table을 공급합니다. buffer의 남은 용량과 can_use_brk_pgt를 보고, 필요하면 이미 mapping한 PFN 범위 안에서 memblock_phys_alloc_range()를 시도합니다.
현재 구현에는 허용되는 경우 extend_brk() fallback도 있습니다. 이를 포함해도 공급하지 못하면 초기화가 진행할 수 없어 panic으로 끝납니다. 반환하기 전에는 각 table page를 clear하므로 상위 entry가 가리킬 때부터 빈 상태가 정의돼 있습니다.
after_bootmem 뒤에는 필요한 order를 계산하여 __get_free_pages(GFP_ATOMIC | __GFP_ZERO, order) 계열로 갑니다. 함수가 같은 이름이라고 boot 전후의 allocation 계약과 실패 형태까지 같지는 않습니다. num page 요청과 그 수를 수용하는 buddy order도 구별해야 합니다.
boot 전 경로에서 이 helper가 반환 직전 __va()로 각 page를 clear할 수 있으려면 선택한 PFN들이 이미 접근 가능한 direct-map 범위 안에 있어야 합니다. min_pfn_mapped·max_pfn_mapped가 table 공급 조건에 관여하는 이유입니다. after_bootmem 분기는 그 loop에 도달하지 않고 zeroing을 요청한 buddy allocation 결과를 바로 반환합니다. 아래는 v6.18 init.c의 전체 alloc_low_pages()입니다. 이 파일의 license는 개별 SPDX가 아닌 kernel COPYING을 기준으로 구별했습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.18, arch/x86/mm/init.c:127-168
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init.c
 * Complete function: alloc_low_pages
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 * Source has no SPDX header; license follows kernel COPYING.
 */

__ref void *alloc_low_pages(unsigned int num)
{
	unsigned long pfn;
	int i;

	if (after_bootmem) {
		unsigned int order;

		order = get_order((unsigned long)num << PAGE_SHIFT);
		return (void *)__get_free_pages(GFP_ATOMIC | __GFP_ZERO, order);
	}

	if ((pgt_buf_end + num) > pgt_buf_top || !can_use_brk_pgt) {
		unsigned long ret = 0;

		if (min_pfn_mapped < max_pfn_mapped) {
			ret = memblock_phys_alloc_range(
					PAGE_SIZE * num, PAGE_SIZE,
					min_pfn_mapped << PAGE_SHIFT,
					max_pfn_mapped << PAGE_SHIFT);
		}
		if (!ret && can_use_brk_pgt)
			ret = __pa(extend_brk(PAGE_SIZE * num, PAGE_SIZE));

		if (!ret)
			panic("alloc_low_pages: can not alloc memory");

		pfn = ret >> PAGE_SHIFT;
	} else {
		pfn = pgt_buf_end;
		pgt_buf_end += num;
	}

	for (i = 0; i < num; i++) {
		void *adr;

		adr = __va((pfn + i) << PAGE_SHIFT);
		clear_page(adr);
	}

	return __va(pfn << PAGE_SHIFT);
}
PUD·PMD의 기존 huge leaf
PUD에는 이미 하위 PMD table이 있거나 1 GiB leaf가 있을 수 있습니다. non-leaf이면 하위를 재사용합니다. leaf이고 현재 mask도 그 크기를 허용하면 그대로 유지할 수 있습니다. 반면 큰 leaf를 더 작은 table로 나눠야 한다면 같은 physical 내용과 속성을 보존해야 합니다.
이 전환에서 큰 page 표시를 제거하더라도 기존 protection을 무관한 기본값으로 덮어서는 안 됩니다. 옛 translation과 새 translation이 같은 backing과 attribute를 나타내야 하는 hardware 제약이 있기 때문입니다. 일부 helper를 쓰기 위한 type cast를 PTE 자체도 huge leaf가 된다는 뜻으로 해석해서도 안 됩니다.
새 entry에서는 mask가 허용하면 1 GiB leaf를 설치하고, 아니면 PMD table을 할당하여 더 내려갑니다. PMD도 같은 원리로 2 MiB leaf와 PTE table을 구별합니다. 기존 lower-level mapping을 재사용할 때와 새 table을 채운 뒤 상위 entry를 설치할 때의 lock 위치는 실제 source의 경로별로 확인해야 합니다.
범위 밖까지 순회하는 부분에는 early boot의 hole 정리도 있습니다. 책의 listing은 E820_TYPE_RAM과 E820_TYPE_RESERVED_KERN을 검사하지만, 아래 v6.18은 E820_TYPE_RAM과 E820_TYPE_ACPI를 검사합니다. 모든 reserved type을 RAM처럼 허용하거나, 범위 밖이라는 이유만으로 무조건 clear하는 정책이 아닙니다. E820은 PC의 초기 firmware memory-map 인터페이스에서 유래한 이름이며, 이 type 판정과 memblock의 free allocation 여부도 다른 문제입니다.
P4D는 runtime folding을 먼저 처리하며 virtual 경계로 진행합니다. PUD·PMD는 해당 table의 남은 entry를 순회하면서 요청 끝 밖의 hole도 정리할 수 있습니다. 아래 v6.18의 PUD는 loop마다 _prot에서 local prot을 다시 시작하고, 새로운 1 GiB leaf는 pfn_pud()·prot_sethuge()·set_pud_init()으로 구성합니다. 책에서 PTE type cast와 set_pte_init()을 사용한 표현과 code가 같지는 않습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:692-741
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: phys_p4d_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static unsigned long __meminit
phys_p4d_init(p4d_t *p4d_page, unsigned long paddr, unsigned long paddr_end,
	      unsigned long page_size_mask, pgprot_t prot, bool init)
{
	unsigned long vaddr, vaddr_end, vaddr_next, paddr_next, paddr_last;

	paddr_last = paddr_end;
	vaddr = (unsigned long)__va(paddr);
	vaddr_end = (unsigned long)__va(paddr_end);

	if (!pgtable_l5_enabled())
		return phys_pud_init((pud_t *) p4d_page, paddr, paddr_end,
				     page_size_mask, prot, init);

	for (; vaddr < vaddr_end; vaddr = vaddr_next) {
		p4d_t *p4d = p4d_page + p4d_index(vaddr);
		pud_t *pud;

		vaddr_next = (vaddr & P4D_MASK) + P4D_SIZE;
		paddr = __pa(vaddr);

		if (paddr >= paddr_end) {
			paddr_next = __pa(vaddr_next);
			if (!after_bootmem &&
			    !e820__mapped_any(paddr & P4D_MASK, paddr_next,
					     E820_TYPE_RAM) &&
			    !e820__mapped_any(paddr & P4D_MASK, paddr_next,
					     E820_TYPE_ACPI))
				set_p4d_init(p4d, __p4d(0), init);
			continue;
		}

		if (!p4d_none(*p4d)) {
			pud = pud_offset(p4d, 0);
			paddr_last = phys_pud_init(pud, paddr, __pa(vaddr_end),
					page_size_mask, prot, init);
			continue;
		}

		pud = alloc_low_page();
		paddr_last = phys_pud_init(pud, paddr, __pa(vaddr_end),
					   page_size_mask, prot, init);

		spin_lock(&init_mm.page_table_lock);
		p4d_populate_init(&init_mm, p4d, pud, init);
		spin_unlock(&init_mm.page_table_lock);
	}

	return paddr_last;
}
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:609-690
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: phys_pud_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static unsigned long __meminit
phys_pud_init(pud_t *pud_page, unsigned long paddr, unsigned long paddr_end,
	      unsigned long page_size_mask, pgprot_t _prot, bool init)
{
	unsigned long pages = 0, paddr_next;
	unsigned long paddr_last = paddr_end;
	unsigned long vaddr = (unsigned long)__va(paddr);
	int i = pud_index(vaddr);

	for (; i < PTRS_PER_PUD; i++, paddr = paddr_next) {
		pud_t *pud;
		pmd_t *pmd;
		pgprot_t prot = _prot;

		vaddr = (unsigned long)__va(paddr);
		pud = pud_page + pud_index(vaddr);
		paddr_next = (paddr & PUD_MASK) + PUD_SIZE;

		if (paddr >= paddr_end) {
			if (!after_bootmem &&
			    !e820__mapped_any(paddr & PUD_MASK, paddr_next,
					     E820_TYPE_RAM) &&
			    !e820__mapped_any(paddr & PUD_MASK, paddr_next,
					     E820_TYPE_ACPI))
				set_pud_init(pud, __pud(0), init);
			continue;
		}

		if (!pud_none(*pud)) {
			if (!pud_leaf(*pud)) {
				pmd = pmd_offset(pud, 0);
				paddr_last = phys_pmd_init(pmd, paddr,
							   paddr_end,
							   page_size_mask,
							   prot, init);
				continue;
			}
			/*
			 * If we are ok with PG_LEVEL_1G mapping, then we will
			 * use the existing mapping.
			 *
			 * Otherwise, we will split the gbpage mapping but use
			 * the same existing protection  bits except for large
			 * page, so that we don't violate Intel's TLB
			 * Application note (317080) which says, while changing
			 * the page sizes, new and old translations should
			 * not differ with respect to page frame and
			 * attributes.
			 */
			if (page_size_mask & (1 << PG_LEVEL_1G)) {
				if (!after_bootmem)
					pages++;
				paddr_last = paddr_next;
				continue;
			}
			prot = pte_pgprot(pte_clrhuge(*(pte_t *)pud));
		}

		if (page_size_mask & (1<<PG_LEVEL_1G)) {
			pages++;
			spin_lock(&init_mm.page_table_lock);
			set_pud_init(pud,
				     pfn_pud(paddr >> PAGE_SHIFT, prot_sethuge(prot)),
				     init);
			spin_unlock(&init_mm.page_table_lock);
			paddr_last = paddr_next;
			continue;
		}

		pmd = alloc_low_page();
		paddr_last = phys_pmd_init(pmd, paddr, paddr_end,
					   page_size_mask, prot, init);

		spin_lock(&init_mm.page_table_lock);
		pud_populate_init(&init_mm, pud, pmd, init);
		spin_unlock(&init_mm.page_table_lock);
	}

	update_page_count(PG_LEVEL_1G, pages);

	return paddr_last;
}
PMD의 기존 non-leaf는 이미 있는 PTE table을 얻어 init_mm.page_table_lock 아래 phys_pte_init()을 호출합니다. 새 PTE table은 먼저 채운 뒤 부모 PMD를 lock 아래 연결합니다. 기존 huge leaf를 split할 때 new_prot에 보존한 속성을 넘기는 분기와, 새로운 2 MiB leaf를 만드는 분기는 별개입니다. leaf의 크기를 바꾸는 일과 기존 mapping의 protection을 무조건 기본값으로 초기화하는 일을 섞지 않습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:525-601
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: phys_pmd_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static unsigned long __meminit
phys_pmd_init(pmd_t *pmd_page, unsigned long paddr, unsigned long paddr_end,
	      unsigned long page_size_mask, pgprot_t prot, bool init)
{
	unsigned long pages = 0, paddr_next;
	unsigned long paddr_last = paddr_end;

	int i = pmd_index(paddr);

	for (; i < PTRS_PER_PMD; i++, paddr = paddr_next) {
		pmd_t *pmd = pmd_page + pmd_index(paddr);
		pte_t *pte;
		pgprot_t new_prot = prot;

		paddr_next = (paddr & PMD_MASK) + PMD_SIZE;
		if (paddr >= paddr_end) {
			if (!after_bootmem &&
			    !e820__mapped_any(paddr & PMD_MASK, paddr_next,
					     E820_TYPE_RAM) &&
			    !e820__mapped_any(paddr & PMD_MASK, paddr_next,
					     E820_TYPE_ACPI))
				set_pmd_init(pmd, __pmd(0), init);
			continue;
		}

		if (!pmd_none(*pmd)) {
			if (!pmd_leaf(*pmd)) {
				spin_lock(&init_mm.page_table_lock);
				pte = (pte_t *)pmd_page_vaddr(*pmd);
				paddr_last = phys_pte_init(pte, paddr,
							   paddr_end, prot,
							   init);
				spin_unlock(&init_mm.page_table_lock);
				continue;
			}
			/*
			 * If we are ok with PG_LEVEL_2M mapping, then we will
			 * use the existing mapping,
			 *
			 * Otherwise, we will split the large page mapping but
			 * use the same existing protection bits except for
			 * large page, so that we don't violate Intel's TLB
			 * Application note (317080) which says, while changing
			 * the page sizes, new and old translations should
			 * not differ with respect to page frame and
			 * attributes.
			 */
			if (page_size_mask & (1 << PG_LEVEL_2M)) {
				if (!after_bootmem)
					pages++;
				paddr_last = paddr_next;
				continue;
			}
			new_prot = pte_pgprot(pte_clrhuge(*(pte_t *)pmd));
		}

		if (page_size_mask & (1<<PG_LEVEL_2M)) {
			pages++;
			spin_lock(&init_mm.page_table_lock);
			set_pmd_init(pmd,
				     pfn_pmd(paddr >> PAGE_SHIFT, prot_sethuge(prot)),
				     init);
			spin_unlock(&init_mm.page_table_lock);
			paddr_last = paddr_next;
			continue;
		}

		pte = alloc_low_page();
		paddr_last = phys_pte_init(pte, paddr, paddr_end, new_prot, init);

		spin_lock(&init_mm.page_table_lock);
		pmd_populate_kernel_init(&init_mm, pmd, pte, init);
		spin_unlock(&init_mm.page_table_lock);
	}
	update_page_count(PG_LEVEL_2M, pages);
	return paddr_last;
}
마지막 PTE와 통계
P4D·PUD 부근에서는 KASLR 때문에 PAGE_OFFSET과 physical 경계의 alignment가 같은 것으로 보장되지 않는 점도 중요합니다. virtual 경계를 따라 다음 entry를 정하고 physical 주소로 다시 바꾸는 방식은 암묵적인 alignment 가정을 피합니다. PMD·PTE 쪽의 조건과 같은 좌표계를 무조건 적용할 수는 없습니다.
마지막 phys_pte_init()은 더 아래 table을 만들지 않고 PFN과 protection을 final entry로 표현합니다. 1 GiB·2 MiB·4 KiB mapping의 통계와 마지막으로 mapping한 physical 끝도 추적합니다. 이것은 data page를 새로 allocation한 수를 세는 것과 다릅니다. direct map은 이미 존재하는 memory에 접근 경로를 만드는 작업입니다.
nonempty PTE는 보존합니다. Xen이 page-table page를 read-only로 미리 mapping해 둔 것처럼 caller보다 앞선 설정이 필요한 경우를 깨뜨리지 않기 위해서입니다. 재사용을 통계에 더하는 조건에는 !after_bootmem이 붙으며, 새 mapping을 만드는 count와 구분합니다. source에 남은 if (0)의 진단 출력은 실제 실행 경로가 아닙니다. 마지막 paddr_last도 단순히 input 끝을 echo하는 값이 아니라 경로에서 갱신되는 physical exclusive endpoint입니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  linux/arch/x86_64/mm/init.c
 *
 *  Copyright (C) 1995  Linus Torvalds
 *  Copyright (C) 2000  Pavel Machek <pavel@ucw.cz>
 *  Copyright (C) 2002,2003 Andi Kleen <ak@suse.de>
 */
/*
 * Linux v6.18, arch/x86/mm/init_64.c:471-518
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/mm/init_64.c
 * Complete function: phys_pte_init
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static unsigned long __meminit
phys_pte_init(pte_t *pte_page, unsigned long paddr, unsigned long paddr_end,
	      pgprot_t prot, bool init)
{
	unsigned long pages = 0, paddr_next;
	unsigned long paddr_last = paddr_end;
	pte_t *pte;
	int i;

	pte = pte_page + pte_index(paddr);
	i = pte_index(paddr);

	for (; i < PTRS_PER_PTE; i++, paddr = paddr_next, pte++) {
		paddr_next = (paddr & PAGE_MASK) + PAGE_SIZE;
		if (paddr >= paddr_end) {
			if (!after_bootmem &&
			    !e820__mapped_any(paddr & PAGE_MASK, paddr_next,
					     E820_TYPE_RAM) &&
			    !e820__mapped_any(paddr & PAGE_MASK, paddr_next,
					     E820_TYPE_ACPI))
				set_pte_init(pte, __pte(0), init);
			continue;
		}

		/*
		 * We will re-use the existing mapping.
		 * Xen for example has some special requirements, like mapping
		 * pagetable pages as RO. So assume someone who pre-setup
		 * these mappings are more intelligent.
		 */
		if (!pte_none(*pte)) {
			if (!after_bootmem)
				pages++;
			continue;
		}

		if (0)
			pr_info("   pte=%p addr=%lx pte=%016lx\n", pte, paddr,
				pfn_pte(paddr >> PAGE_SHIFT, PAGE_KERNEL).pte);
		pages++;
		set_pte_init(pte, pfn_pte(paddr >> PAGE_SHIFT, prot), init);
		paddr_last = (paddr & PAGE_MASK) + PAGE_SIZE;
	}

	update_page_count(PG_LEVEL_4K, pages);

	return paddr_last;
}
범위 분할, 기존 leaf의 재사용, root 공유와 table 공급을 따로 보면 긴 초기화 코드도 같은 질문의 반복으로 읽힙니다. 지금 범위를 어떤 크기로 표현할 수 있는지, 이미 같은 표현이 있는지, 없다면 table을 어디서 구해 어떻게 공개할지입니다. 이 세 조건을 지켜야 빠른 주소 덧셈 뒤에 실제로 사용할 수 있는 mapping이 생깁니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 3 §3.3.2.
- Linux v6.18 init.c: split_mem_range(), save_mr(), adjust_range_page_size_mask(), alloc_low_pages().
- Linux v6.18 init_64.c: phys_p4d_init()~phys_pte_init(), sync_global_pgds()와 arch_sync_kernel_mappings().
- Linux v6.18 pgtable_64_types.h: ARCH_PAGE_TABLE_SYNC_MASK.