두 process가 같은 pointer 값을 사용해도 서로 다른 data를 읽을 수 있습니다. 반대로 서로 다른 주소가 같은 physical page를 가리킬 수도 있습니다. virtual memory에서 주소는 RAM의 고정 위치를 적은 숫자가 아니라, 현재 address space의 translation을 거쳐 해석하는 좌표입니다.
이 간접 계층은 접근을 한 번 더 계산하는 비용만 만들지 않습니다. process 격리, sparse allocation, CoW와 memory 이동이 가능한 이유이기도 합니다. x86-64의 4 KiB base page를 기준으로 그 구조를 따라가겠습니다. 구현상의 수치와 이름은 upstream Linux v6.18을 기준으로 구별합니다.
physical pointer만으로 실행하면 생기는 일
모든 프로그램이 physical address를 직접 사용한다면 한 프로그램의 잘못된 store가 다른 프로그램이나 kernel을 망가뜨릴 수 있습니다. 민감한 data도 주소만 알면 읽을 수 있습니다. stability 문제와 security 문제가 같은 주소 접근에서 발생합니다.
loader도 곤란해집니다. 현재 프로그램의 code·data뿐 아니라 실행 중 앞으로 늘어날 memory까지 다른 프로그램과 겹치지 않도록 배치해야 합니다. physical memory가 작은 빈 구간으로 흩어져 있으면 총 여유량이 충분해도 큰 연속 buffer를 제공하지 못합니다.
memory를 옮겨 빈 공간을 합치려 해도 프로그램의 pointer가 옛 physical 위치를 직접 가리킵니다. pointer를 모조리 찾아 고치지 않는 한 relocation이 어렵습니다. 실제 RAM에 없는 data를 backing store로 내보냈다가 다시 가져오는 일 역시 직접 pointer만으로는 표현하기 어렵습니다.
virtual address는 이 문제들을 translation 뒤로 옮깁니다. 프로그램에는 연속 주소를 주고 physical page는 흩어져 배치할 수 있습니다. 어떤 virtual page가 어느 physical page를 가리키는지는 kernel이 바꿉니다. 다만 주소 추상화가 physical memory의 유한성까지 없애 주는 것은 아닙니다. 필요한 page나 metadata를 끝내 공급하지 못하는 실패는 여전히 존재합니다.
mapping을 바꿀 권한도 분리해야 합니다
프로그램이 자기 translation을 마음대로 수정해 다른 process의 page를 연결할 수 있다면 격리는 성립하지 않습니다. hardware는 privileged kernel과 unprivileged user 실행을 구분하고, translation 제어를 kernel의 권한으로 둡니다. context switch 때 address space를 바꿀 수 있는 것도 이 구분 위의 동작입니다.
kernel 관점에서 memory 제공은 physical page 확보와 virtual mapping 연결이라는 두 작업으로 나눌 수 있습니다. 그러나 모든 요청에서 두 작업을 즉시 끝내야 하는 것은 아닙니다. 먼저 범위와 권한만 승인하고 실제 접근 때 page를 연결할 수 있습니다.
CPU가 mapping 부재나 권한 위반을 발견하면 page fault를 일으킵니다. kernel은 접근이 잘못됐으면 거절하지만, 승인된 범위의 지연 작업이면 translation을 준비한 뒤 instruction을 재개할 수 있습니다. page fault는 오류 통보이면서 memory 정책을 실행하는 진입점입니다.
예를 들어 demand paging은 아직 사용하지 않은 범위에 data page를 만들지 않습니다. fork()의 CoW는 parent·child가 data를 공유하되 write를 막고, 필요한 write에서 격리를 마련합니다. NUMA balancing은 접근을 관찰할 hint fault를 이용해 현재 실행 CPU와 memory 배치를 다시 검토합니다. 이때의 접근 제한은 data를 무조건 버리는 munmap()과 다르며, 모든 hint fault가 migration 성공을 뜻하지도 않습니다.
평평한 table은 너무 큽니다
64-bit의 모든 byte 주소를 4 KiB page로 나누면 page 수는 2^52입니다. page마다 8-byte mapping entry 하나를 영구적으로 둔다면 table만 2^55 byte, 즉 32 PiB가 필요합니다. 이것은 실제 x86-64가 64-bit 전부를 translation한다는 주장이 아니라 flat table의 크기를 계산하는 가정입니다.
실제 process는 대부분의 주소를 사용하지 않습니다. 따라서 빈 주소를 위해 마지막 단계의 entry를 전부 만들어 두지 않는 sparse 구조가 필요합니다. Linux의 page table은 상위 entry가 다음 level의 table page를 가리키는 계층 구조입니다.
4 KiB table에 8-byte entry를 넣으면 512개가 들어갑니다. 여기서 512는 table 하나의 수용량이지 한번에 512개 data page를 반드시 mapping한다는 뜻은 아닙니다. PTE 하나만 present이고 나머지 511개가 비어 있어도 됩니다. 그 table을 가리키는 상위 entry가 없으면 table page 자체를 할당하지 않을 수 있습니다.
아래 계산은 실행 가능한 kernel 구현이 아니라 크기와 bit 수의 관계입니다.
base_page_bytes = 4096 = 2^12
entry_bytes = 8
entries_per_table = 4096 / 8 = 512 = 2^9

flat_entries = 2^64 / 2^12 = 2^52
flat_table_bytes = 2^52 * 8 = 2^55
PGD는 process에서 translation을 시작할 root입니다. mm_struct->pgd는 kernel이 사용하는 그 root의 주소이고, table entry는 다음 table 또는 최종 data의 physical 위치와 flags를 표현합니다. root의 kernel pointer와 entry 안의 physical address를 같은 종류의 pointer로 읽으면 안 됩니다.
다섯 level은 주소의 다른 구간을 읽습니다
Linux의 공통 이름은 PGD, P4D, PUD, PMD, PTE입니다. 일반적인 5-level walk는 이 순서로 table을 내려가며 마지막 12 bit를 data page 내부 offset으로 사용합니다. 각 table의 512개 entry를 선택하는 데에는 9 bit씩 필요합니다.
| Level | 5-level index bits | 담당하는 한 entry의 범위 |
|---|---|---|
| PGD | 56~48 | 256 TiB |
| P4D | 47~39 | 512 GiB |
| PUD | 38~30 | 1 GiB |
| PMD | 29~21 | 2 MiB |
| PTE | 20~12 | 4 KiB |
이는 index 계산을 위한 비교표입니다. 상위 entry가 언제나 data page 하나를 mapping한다는 뜻은 아닙니다. 일반 non-leaf entry는 다음 table을 가리킵니다. 해당 범위가 비어 있으면 그 아래로 내려갈 필요도 없습니다.
source에서 이 수치를 찾을 때는 entry 수와 shift를 짝지으면 됩니다. PTRS_PER_PGD, PTRS_PER_P4D, PTRS_PER_PUD, PTRS_PER_PMD, PTRS_PER_PTE는 각 level의 entry 수이고, PGDIR_SHIFT, P4D_SHIFT, PUD_SHIFT, PMD_SHIFT, PAGE_SHIFT는 index 아래에 남겨 두는 bit 수입니다. 예를 들어 PMD index는 주소를 21 bit 옮긴 뒤 해당 table의 index mask로 고릅니다. 하나의 PMD entry가 담당하는 범위가 1UL << PMD_SHIFT인 이유입니다.
이름을 풀면 PGD는 Page Global Directory, P4D는 Page 4th-level Directory, PUD는 Page Upper Directory, PMD는 Page Middle Directory이며 PTE는 Page Table Entry입니다. 여기서 directory를 선택하는 entry와 그 entry들이 모인 table page를 구별해야 합니다. pmd_t 하나는 PMD table 전체가 아니라 그 안의 entry 하나를 표현합니다.
pgd_t, p4d_t, pud_t, pmd_t, pte_t는 서로 다른 entry type입니다. x86은 raw 정수 값을 작은 struct로 감싸 compiler가 서로 다른 level을 혼동한 인자 전달을 잡을 수 있게 합니다. pteval_t 같은 value type과 entry wrapper도 구별합니다. pte_val()은 raw 값을 꺼내고 __pte()는 wrapper를 구성하는 계열이지, 그 호출만으로 live mapping에 entry가 설치되는 것은 아닙니다.
그 구분은 실제 type 선언에서 확인할 수 있습니다. 아래 첫 block은 v6.18 pgtable_64_types.h의 연속된 전체 typedef 선언입니다. 이 tag에서는 pmd_t도 이 header에 있습니다. raw alias들이 같은 unsigned long이어도 각 wrapper는 별도 struct이므로 PTE를 받는 함수에 PMD wrapper를 그대로 넘길 수 없습니다.
// SPDX-License-Identifier: GPL-2.0
/*
 * Linux v6.18, arch/x86/include/asm/pgtable_64_types.h:14-22
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/include/asm/pgtable_64_types.h
 * Complete declaration_group: x86_64_raw_entry_typedefs
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

typedef unsigned long	pteval_t;
typedef unsigned long	pmdval_t;
typedef unsigned long	pudval_t;
typedef unsigned long	p4dval_t;
typedef unsigned long	pgdval_t;
typedef unsigned long	pgprotval_t;

typedef struct { pteval_t pte; } pte_t;
typedef struct { pmdval_t pmd; } pmd_t;
나머지 세 block은 pgtable_types.h의 전체 typedef 선언입니다. 여기서 보여 주는 p4d_t 선언은 CONFIG_PGTABLE_LEVELS > 4, pud_t 선언은 CONFIG_PGTABLE_LEVELS > 3인 build 분기의 정의입니다. level을 접는 build에서는 다른 분기의 folded type을 사용합니다. 따라서 아래 선언만을 모든 build의 공통 ABI로 읽지 않습니다. 5-level 지원 build가 실행 중 4-level로 작동하는 runtime folding과도 구분해야 합니다.
// SPDX-License-Identifier: GPL-2.0
/*
 * Linux v6.18, arch/x86/include/asm/pgtable_types.h:295-295
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/include/asm/pgtable_types.h
 * Complete declaration: pgd_t
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

typedef struct { pgdval_t pgd; } pgd_t;
// SPDX-License-Identifier: GPL-2.0
/*
 * Linux v6.18, arch/x86/include/asm/pgtable_types.h:342-342
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/include/asm/pgtable_types.h
 * Complete declaration: p4d_t
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

typedef struct { p4dval_t p4d; } p4d_t;
// SPDX-License-Identifier: GPL-2.0
/*
 * Linux v6.18, arch/x86/include/asm/pgtable_types.h:368-368
 * Source: https://github.com/torvalds/linux/blob/v6.18/arch/x86/include/asm/pgtable_types.h
 * Complete declaration: pud_t
 * Source body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

typedef struct { pudval_t pud; } pud_t;
각 선언은 공식 v6.18 source 그대로이며 header의 GPL-2.0 표시를 유지했습니다. source 범위와 hash, license text를 함께 제공합니다. kernel header 문맥을 요구하는 선언으로, 별도 실행 프로그램은 아닙니다. 책에서 사용한 정확한 upstream tag를 확인했다는 뜻도 아닙니다.
4-level에서는 P4D가 folded됩니다. 공통 walker는 여전히 P4D라는 추상 level을 통과하지만 독립된 table page와 9-bit index를 추가하지 않습니다. PGD index는 47~39 bit를 사용하고 PGDIR_SHIFT는 39입니다. 단순히 가장 아래 PTE를 하나 없앤 4-level 구조가 아닙니다.
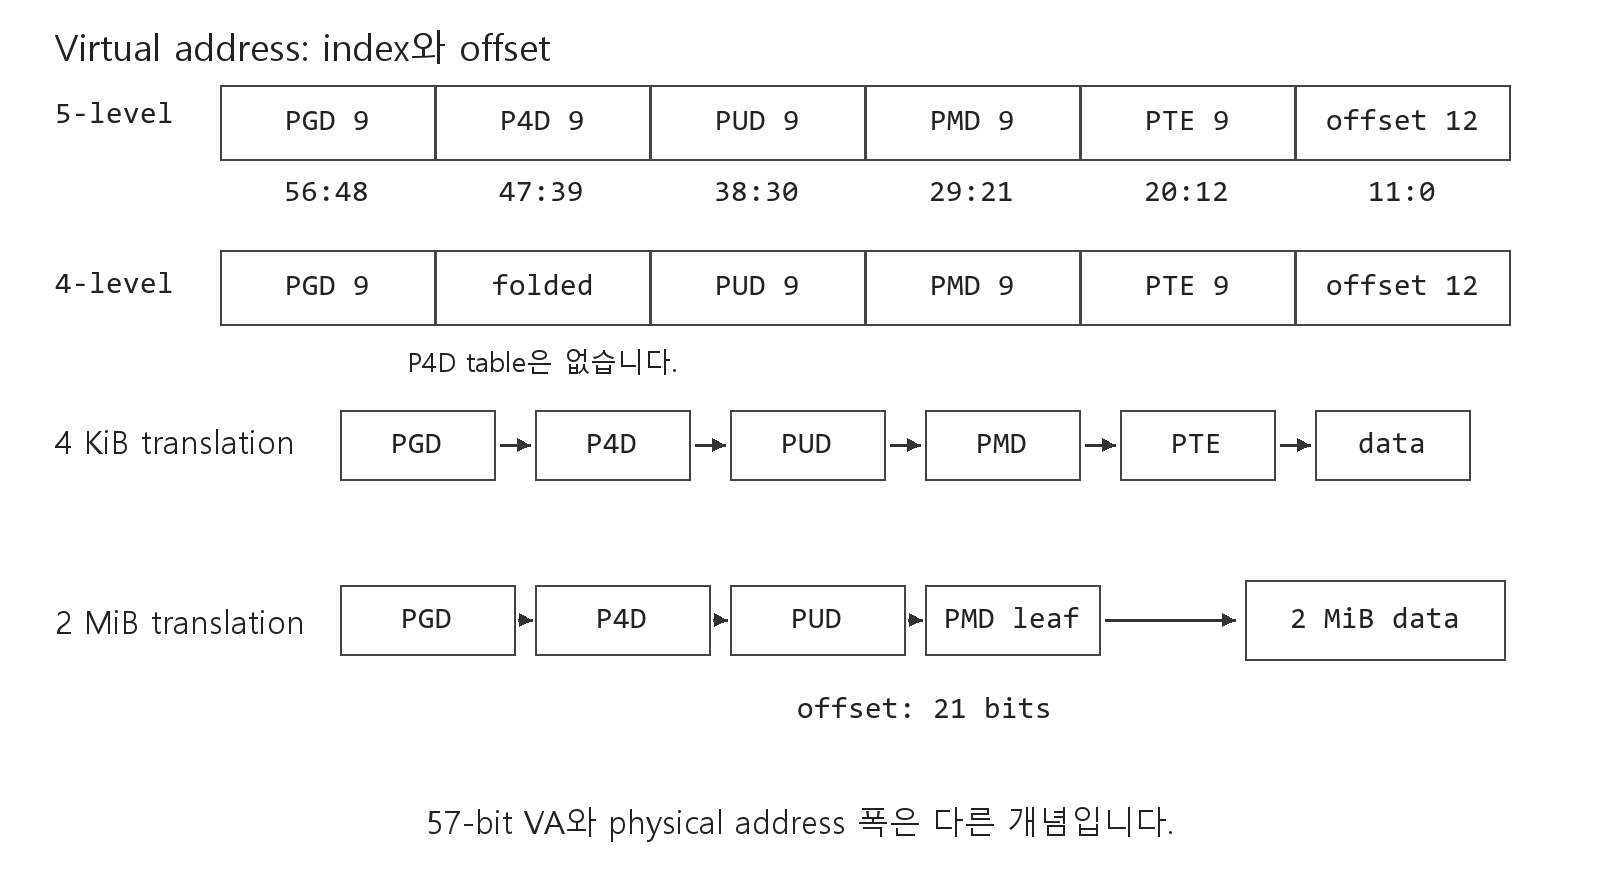
canonical과 physical 폭을 섞지 않습니다
일반적인 4-level x86-64는 48-bit virtual address를, 5-level은 57-bit virtual address를 translation합니다. canonical form은 상위 bit를 가장 높은 유효 bit의 부호 확장으로 맞추는 규칙입니다. 4-level에서는 bit 47을, 5-level에서는 bit 56을 그 위에 반복합니다. 이 설명은 주소 tagging을 위한 LAM 같은 별도 기능을 제외한 기본 주소 형식입니다.
따라서 5-level에서 의미 있는 virtual bit가 57개라는 사실을 physical address도 57-bit라는 뜻으로 바꾸면 안 됩니다. Linux v6.18의 MAX_POSSIBLE_PHYSMEM_BITS는 52이며 sparsemem의 MAX_PHYSMEM_BITS는 5-level 활성 여부에 따라 52 또는 46으로 정해집니다. 후자는 이 kernel의 memory 관리 범위를 나타내며 모든 4-level CPU의 physical-address hardware 한계를 46으로 선언하는 규칙이 아닙니다.
또한 CONFIG_X86_5LEVEL로 build했다는 사실과 실행 중 LA57이 활성이라는 사실은 다릅니다. 확인한 header는 pgtable_l5_enabled()와 runtime의 pgdir_shift, ptrs_per_p4d를 사용합니다. 구조를 읽을 때는 build 가능한 최대 level과 현재 사용하는 level을 함께 확인해야 합니다.
huge leaf는 아래 table 대신 data를 가리킵니다
PMD가 2 MiB leaf이면 PTE table을 더 읽지 않습니다. 4 KiB offset의 12 bit에 PTE index의 9 bit를 더한 21 bit가 data 내부 offset이 됩니다. PUD가 1 GiB leaf이면 PMD index까지 합쳐 30 bit가 offset입니다. 이 크기는 4-level과 5-level 모두 같습니다.
따라서 PUD에서 끝나는 x86-64 huge leaf를 2 GiB로 읽으면 안 됩니다. 2^30 byte는 1 GiB입니다. 상위 index의 수와 leaf가 담당하는 offset 크기는 다른 축입니다.
큰 leaf에는 해당 크기에 맞는 virtual·physical alignment와 backing 조건이 필요합니다. PTE table을 지우고 flag만 켜면 임의의 흩어진 512개 page가 자동으로 2 MiB leaf가 되는 것은 아닙니다. 아래 table을 더 읽지 않는 hardware 표현과, 그 표현을 안전하게 만들기 위한 allocation·split·collapse 정책을 나누어 생각해야 합니다.
큰 page는 하나의 translation으로 더 넓은 범위를 표현하지만 실제 성능 향상은 TLB 구성과 workload, 큰 contiguous backing의 비용에 따라 달라집니다. page table을 이해하는 출발점은 큰 page가 빠르다는 결론보다, 어느 entry에서 walk가 끝나고 어느 bit가 offset이 되는지 정확히 구별하는 것입니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 3 서론 및 §3.1~§3.1.1.
- Linux v6.18 pgtable_64_types.h: level, shift와 entry type.
- Linux v6.18 sparsemem.h: kernel physical-memory 범위.
- Linux v6.18 pgtable_types.h: entry와 leaf flag의 정의.