이 코드는 어떤 문제를 푸나요?
F2FS는 플래시 저장장치를 고려해 세그먼트와 노드 구조로 파일 위치를 관리합니다. 읽기 진입점에서는 압축 구현이 준비됐는지 확인하고 파일과 요청 조건에 맞는 읽기 방식을 고릅니다. 아래는 v6.6의 f2fs_file_read_iter 전체입니다. 이후 버전에 추가된 LFS 모드의 진행 중 DIO 대기 분기는 이 코드에 없으므로 같은 동작으로 설명하지 않습니다.
읽을 범위: v6.6 · fs/f2fs/file.c · f2fs_file_read_iter 4436–4460행입니다. 아래에 이 범위의 원문과 각 줄의 설명을 실었습니다. 주제 전체의 흐름과 다른 경로는 기존 분석에서 함께 읽으실 수 있습니다.
먼저 알아둘 개념
세그먼트와 노드
세그먼트는 블록 공간을 관리하는 단위이고 노드는 파일의 데이터 위치를 찾는 메타데이터를 담습니다. 파일 경로 이름과 물리 블록 주소는 서로 다른 정보입니다.
압축 백엔드
압축된 파일 내용을 읽으려면 그 압축 형식을 풀 수 있는 구현이 준비되어야 합니다. 저장장치에서 바이트를 읽는 것만으로 사용자에게 원래 내용을 돌려줄 수는 없습니다.
체크포인트
복구를 시작할 수 있는 파일시스템 상태를 기록한 기준입니다. 모든 read 호출이 체크포인트를 새로 기록하는 것은 아닙니다.
직접 I/O 선택
파일과 요청의 정렬·기능 조건 등을 살펴 직접 I/O를 사용할지 정합니다. v6.6의 이 진입 함수는 선택한 읽기 구현으로 바로 넘기며 별도의 inode_dio_wait를 직접 호출하지 않습니다.
처음 읽을 때
파일시스템이 F2FS라는 사실과 이번 요청이 직접 I/O를 쓴다는 사실을 구분하십시오. 이 함수는 요청 조건을 보고 직접 읽기 또는 페이지 캐시 읽기를 선택합니다. 파일 내부의 실제 블록 위치 탐색은 선택된 하위 함수로 이어집니다.
더 깊이 살펴볼 때
f2fs_should_use_dio는 단순히 하나의 사용자 플래그만 보는 판정이 아닙니다. 파일 속성과 요청을 넘겨 선택하고, 양수만 통계에 반영하며, 추적 활성화 검사를 통과한 이벤트만 기록합니다. 동시 쓰기와의 동기화는 이 함수에 없는 분기를 상상하지 말고 하위 경로에서 확인해야 합니다.
그림으로 보는 변화
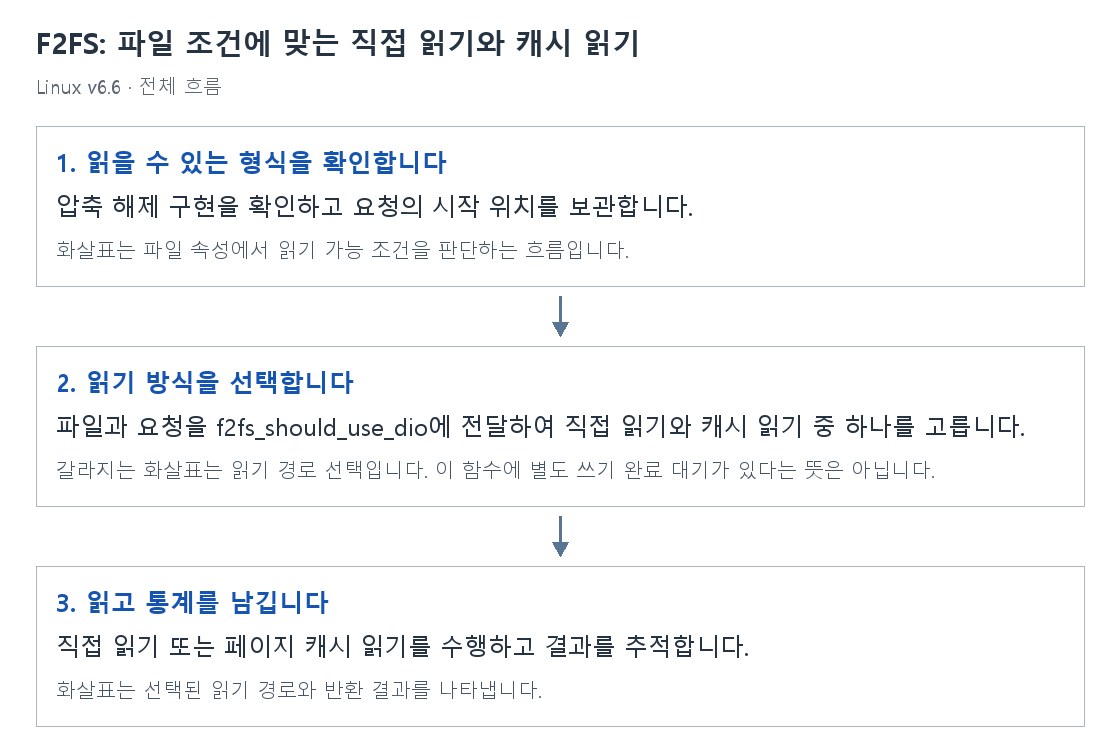
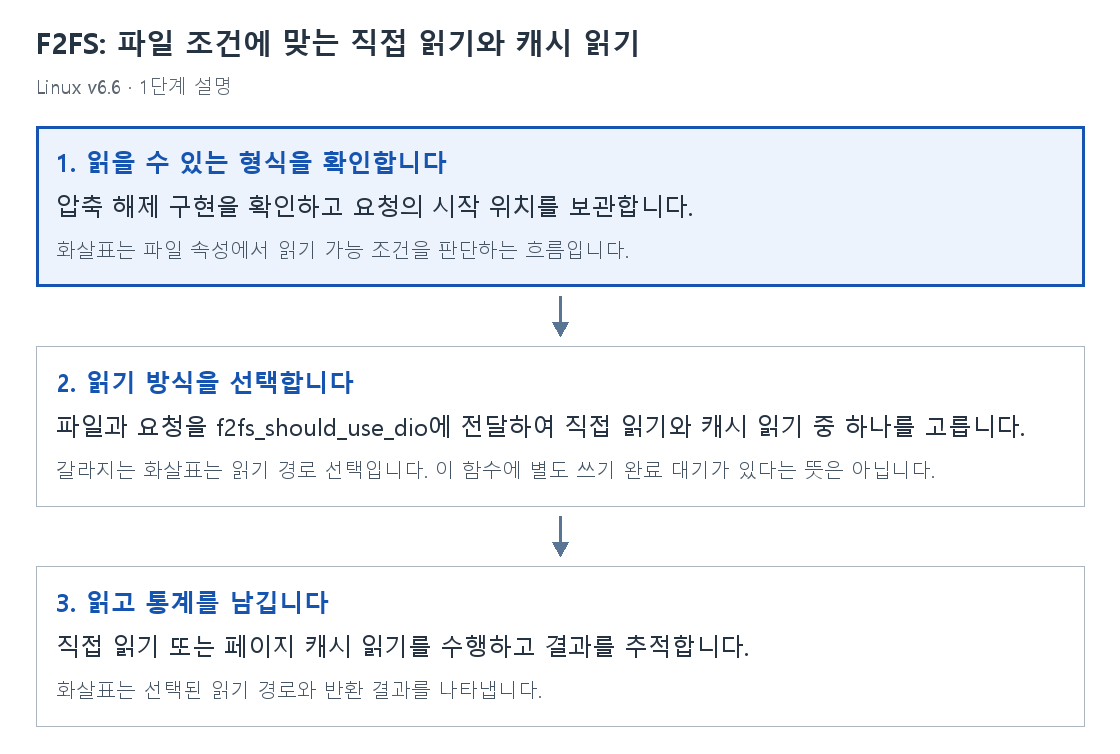
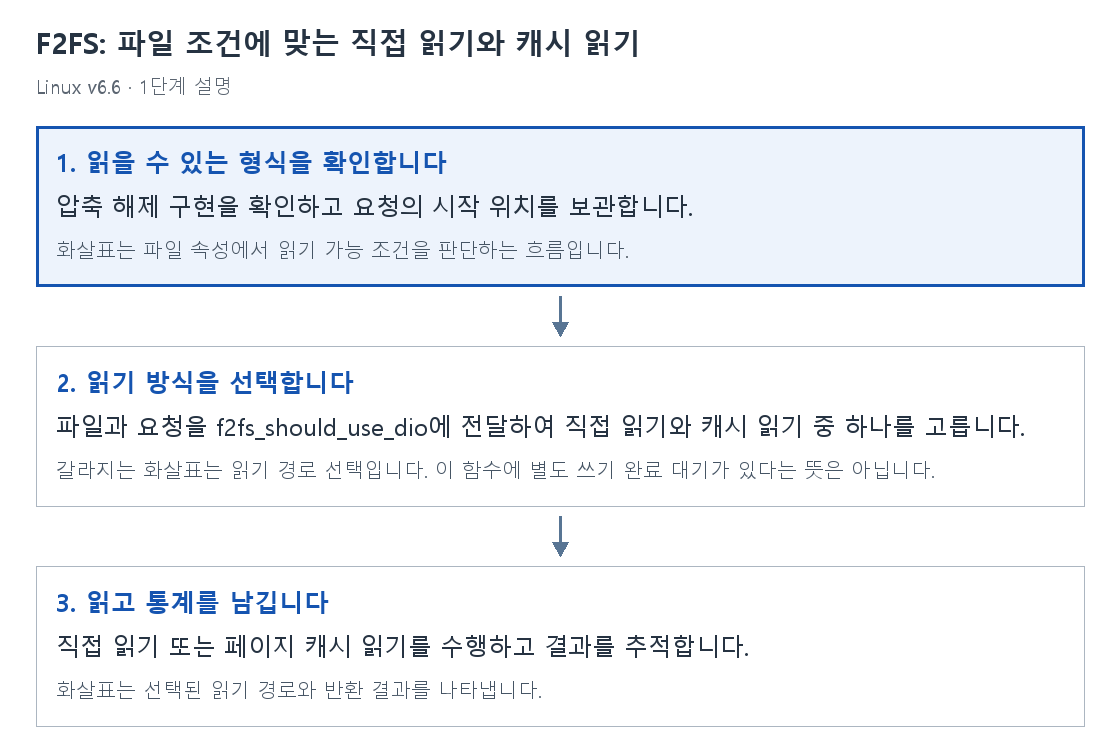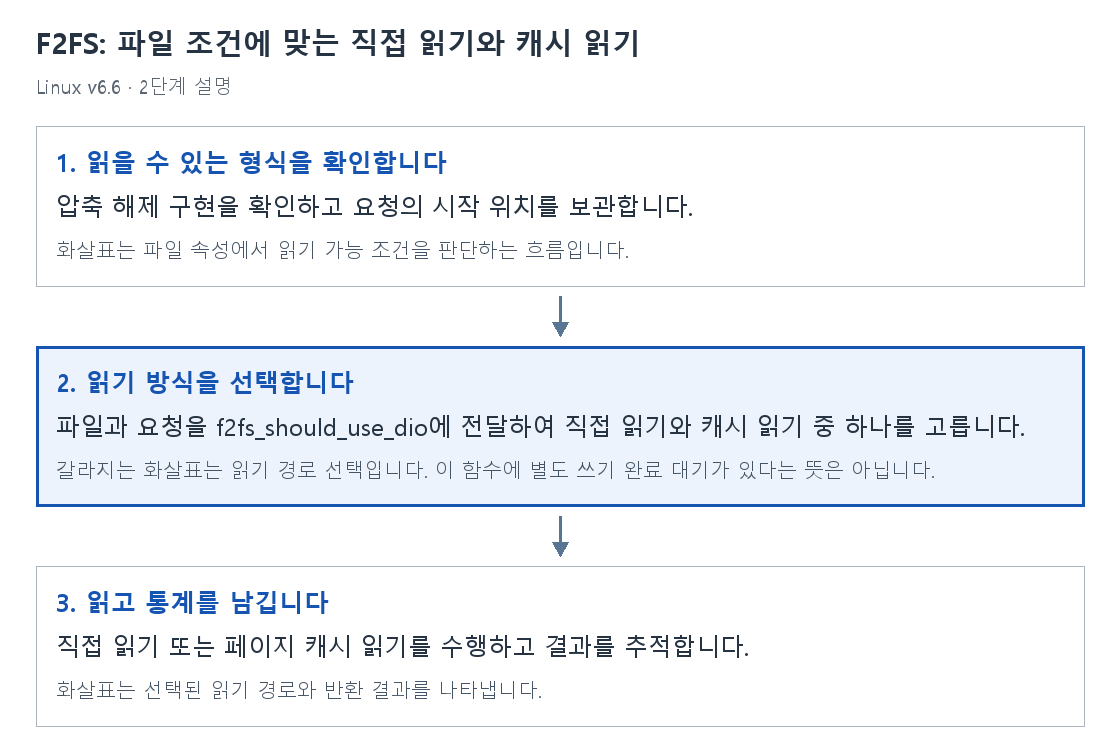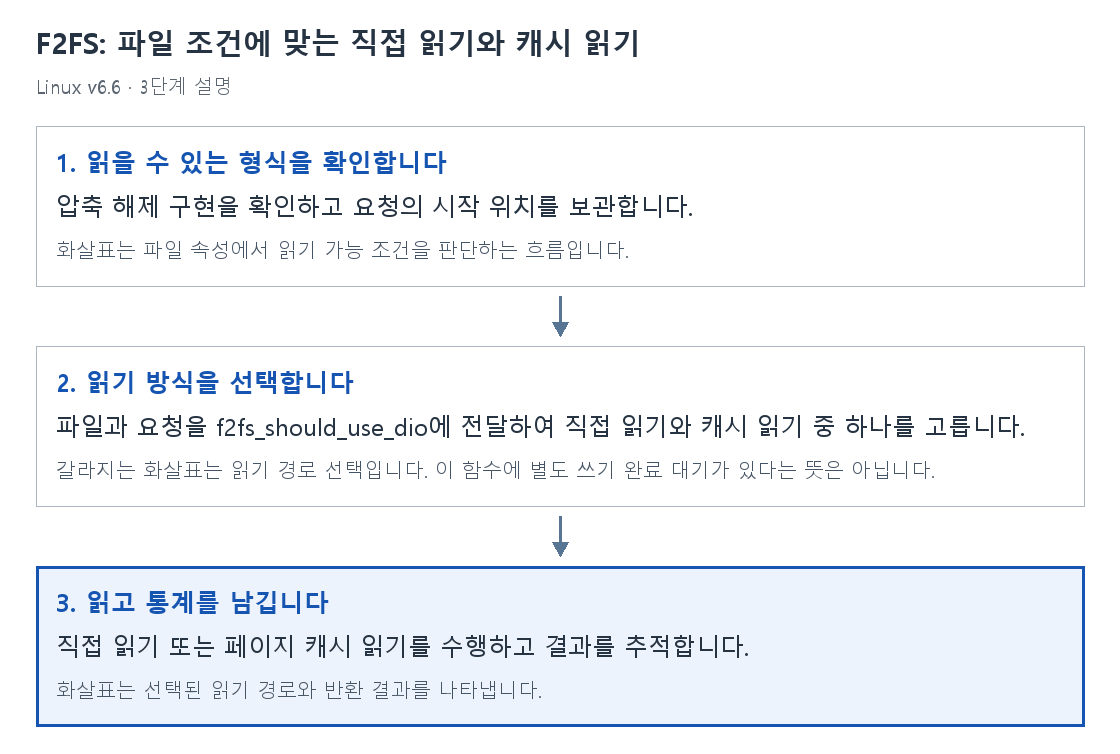
1. 읽을 수 있는 형식을 확인합니다
압축 해제 구현을 확인하고 요청의 시작 위치를 보관합니다.
화살표는 파일 속성에서 읽기 가능 조건을 판단하는 흐름입니다.
2. 읽기 방식을 선택합니다
파일과 요청을 f2fs_should_use_dio에 전달하여 직접 읽기와 캐시 읽기 중 하나를 고릅니다.
갈라지는 화살표는 읽기 경로 선택입니다. 이 함수에 별도 쓰기 완료 대기가 있다는 뜻은 아닙니다.
3. 읽고 통계를 남깁니다
직접 읽기 또는 페이지 캐시 읽기를 수행하고 결과를 추적합니다.
화살표는 선택된 읽기 경로와 반환 결과를 나타냅니다.
f2fs_file_read_iter를 한 줄씩 읽기
줄 번호는 v6.6 원문 기준입니다. 주석·빈 줄을 포함한 함수 전체를 먼저 보고, 그 아래에서 각 줄을 설명합니다.
static ssize_t f2fs_file_read_iter(struct kiocb *iocb, struct iov_iter *to)
{
	struct inode *inode = file_inode(iocb->ki_filp);
	const loff_t pos = iocb->ki_pos;
	ssize_t ret;

	if (!f2fs_is_compress_backend_ready(inode))
		return -EOPNOTSUPP;

	if (trace_f2fs_dataread_start_enabled())
		f2fs_trace_rw_file_path(iocb->ki_filp, iocb->ki_pos,
					iov_iter_count(to), READ);

	if (f2fs_should_use_dio(inode, iocb, to)) {
		ret = f2fs_dio_read_iter(iocb, to);
	} else {
		ret = filemap_read(iocb, to, 0);
		if (ret > 0)
			f2fs_update_iostat(F2FS_I_SB(inode), inode,
						APP_BUFFERED_READ_IO, ret);
	}
	if (trace_f2fs_dataread_end_enabled())
		trace_f2fs_dataread_end(inode, pos, ret);
	return ret;
}static ssize_t f2fs_file_read_iter(struct kiocb *iocb, struct iov_iter *to)F2FS 파일 읽기 요청과 목적지 반복자를 받습니다. 결과는 바이트 수 또는 음수 오류입니다.
struct inode *inode = file_inode(iocb->ki_filp);파일에서 inode를 얻어 F2FS 속성과 동시 I/O 상태를 확인합니다.
const loff_t pos = iocb->ki_pos;읽기 전 시작 위치를 보관합니다. 이후 위치가 이동해도 추적 기록에 원래 값을 쓸 수 있습니다.
ssize_t ret;읽기 결과를 저장할 부호 있는 변수입니다. 음수 오류도 담아야 합니다.
if (!f2fs_is_compress_backend_ready(inode))해당 파일을 읽는 데 필요한 압축 구현이 준비되어 있는지 확인합니다.
return -EOPNOTSUPP;준비되지 않았다면 지원하지 않는 작업이라는 오류를 반환합니다.
if (trace_f2fs_dataread_start_enabled())읽기 시작 추적 이벤트가 활성화됐을 때만 경로 추적 정보를 계산합니다.
f2fs_trace_rw_file_path(iocb->ki_filp, iocb->ki_pos,파일과 현재 위치를 추적 함수에 전달합니다.
iov_iter_count(to), READ);요청 바이트 수와 읽기 방향 READ도 함께 전달합니다.
if (f2fs_should_use_dio(inode, iocb, to)) {inode와 이번 I/O 조건을 함께 검사하여 직접 I/O 경로를 사용할지 바로 분기합니다. 이 v6.6 함수에는 별도의 dio 지역변수나 LFS DIO 대기 분기가 없습니다.
ret = f2fs_dio_read_iter(iocb, to);F2FS 직접 읽기를 수행해 결과를 ret에 저장합니다.
} else {직접 I/O를 선택하지 않은 요청은 아래 캐시 읽기 경로로 갑니다.
ret = filemap_read(iocb, to, 0);페이지 캐시를 이용하는 filemap 읽기에 요청을 넘깁니다.
if (ret > 0)실제로 양수 바이트를 읽었을 때만 읽은 양을 통계에 더합니다.
f2fs_update_iostat(F2FS_I_SB(inode), inode,F2FS 파일시스템과 inode를 통계 갱신 함수에 전달합니다.
APP_BUFFERED_READ_IO, ret);애플리케이션 버퍼드 읽기 종류와 실제 읽은 바이트 수를 전달합니다.
if (trace_f2fs_dataread_end_enabled())읽기 종료 추적 이벤트가 활성화되어 있는지 확인한 뒤에만 이벤트 호출을 실행합니다.
trace_f2fs_dataread_end(inode, pos, ret);원래 시작 위치와 최종 결과로 읽기 종료 추적 이벤트를 남깁니다.
return ret;실제 읽은 길이, 0 또는 오류를 호출자에게 반환합니다.
함께 생각해 볼 질문
이 v6.6 함수도 LFS 직접 쓰기를 명시적으로 기다리나요?
이 함수 본문에는 그 대기 분기가 없습니다. 이후 버전의 코드를 그대로 대입하면 안 되며 v6.6의 하위 I/O 경로에서 동기화가 이루어지는 위치를 따로 확인해야 합니다.
압축 기능이 준비되지 않은 파일을 읽으면 어떻게 되나요?
이 함수는 -EOPNOTSUPP를 반환해 지원되지 않는 상태를 알립니다.
시작 위치를 왜 별도 변수에 보관하나요?
읽는 동안 iocb의 현재 위치가 바뀔 수 있으므로 추적 종료 이벤트에 원래 요청 위치를 사용할 수 있게 합니다.
출처와 읽은 범위
Linux stable v6.6 · fs/f2fs/file.c
해당 버전 원본 파일 · 기존 코드 분석 · 설명 원고