설정값과 관측값
fio의 iodepth는 job이 유지하려는 진행 중 I/O 수입니다. numjobs는 같은 job의 복제 수입니다. 예를 들어 iodepth=32, numjobs=4는 job마다 최대 32개를 목표로 하는 네 job이지, 장치 안에서 언제나 정확히 128개가 처리된다는 뜻은 아닙니다.
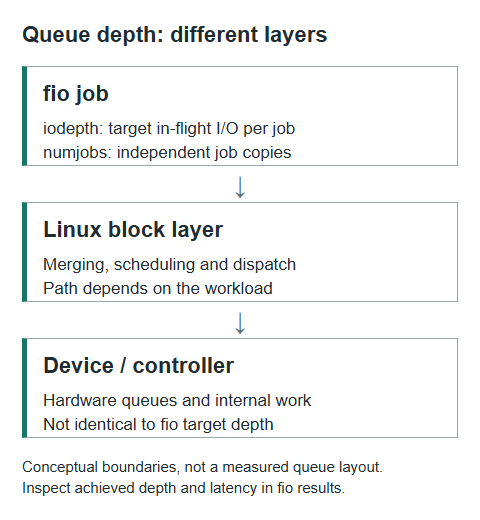
Linux blk-mq는 소프트웨어 대기와 하드웨어 제출 경로를 구분합니다. BIO 병합, 스케줄러, 사용 가능한 태그와 드라이버 상태에 따라 흐름이 달라집니다. fio의 깊이를 NVMe 내부 큐 깊이나 시스템 전체의 진행 중 요청 수와 그대로 같게 놓지 않습니다.
| 설정 | 읽는 의미 | 함께 확인할 것 |
|---|---|---|
iodepth | job당 진행 중 I/O의 목표 상한 | 결과에 나온 실제 IO depths 분포 |
numjobs | 같은 job의 복제 수 | 각 job의 결과와 합산 방식 |
bs / rw | I/O 크기와 읽기·쓰기 패턴 | 같은 깊이라도 같은 작업량은 아님 |
깊이를 올리기 전에
깊이를 바꿀 때는 numjobs, 블록 크기, 읽기·쓰기 비율, 시험 영역과 엔진을 고정합니다. 파일 시스템, 마운트 옵션, 장치와 펌웨어, fio 버전, 다른 부하, 캐시 조건, 준비 시간과 측정 시간도 함께 기록합니다.
동기식 엔진은 iodepth를 높여도 그만큼 비동기 요청을 쌓지 않습니다. Linux libaio도 buffered I/O에서는 원하는 깊이에 도달하지 않을 수 있습니다. 아래 예제는 direct=1을 사용하지만 지원 여부와 정렬 제약은 환경마다 확인해야 합니다. 이 옵션이 모든 장치 캐시를 끈다는 뜻은 아닙니다.
기존 시험 파일만 읽기
이 예제는 Linux에서 미리 내용을 채워 둔 1GiB 이상의 전용 일반 파일만 대상으로 합니다. 운영 데이터, 원시 블록 장치, 다른 프로세스가 바꾸는 파일에는 사용하지 않습니다. 파일을 새로 만들거나 채우는 절차는 포함하지 않았습니다. 경로는 실제 전용 시험 파일로 바꿔야 하며, 이 글에서는 fio를 실행하거나 장치 성능을 측정하지 않았습니다.
#!/bin/sh
set -eu
file=/path/to/dedicated-testfile
test -f "$file"
test ! -L "$file"
test -r "$file"
test "$(stat -c %s -- "$file")" -ge 1073741824
out=$(mktemp -d ./fio-qd-results.XXXXXX)
fio --version > "$out/fio-version.txt"
for depth in 1 2 4 8 16 32 64; do
  fio --readonly --allow_file_create=0 --name="qd-${depth}" \
      --filename="$file" --size=1g --rw=randread --bs=4k \
      --ioengine=libaio --direct=1 --iodepth="$depth" --numjobs=1 \
      --ramp_time=10 --runtime=60 --time_based \
      --output-format=json --output="$out/qd-${depth}.json"
done
printf 'Results: %s\n' "$out"
readonly는 쓰기·trim 작업을 막는 추가 안전장치이고, allow_file_create=0은 대상 파일이 없을 때 생성을 허용하지 않습니다. 읽기 시험도 장치 부하를 일으키며 파일 시스템의 메타데이터 변화까지 없다고 보장하지 않습니다. JSON 결과와 버전 기록은 매번 새로 만든 결과 디렉터리에 저장합니다. 사전 파일 검사 뒤에 다른 프로세스가 경로를 바꾸는 상황까지 방어하는 예제는 아닙니다.
각 깊이에서 ramp_time=10은 측정 전 준비 구간이고, time_based와 runtime=60은 이후 60초 동안 작업을 반복하게 합니다. 일곱 조건은 준비 구간을 포함해 대략 8분 10초에 시작·종료 비용이 더해집니다. 이 예제의 실행 시간이나 1GiB 영역이 모든 장치의 정상 상태를 보장하지는 않습니다.
결과를 비교하는 순서
먼저 오류·짧은 I/O·실제 깊이 분포를 확인합니다. fio의 IO depths는 구간별 통계이며, 예를 들어 16 구간에는 16–31이 포함됩니다. 설정이 32였다는 사실만으로 시험 내내 32를 달성했다고 적지 않습니다.
그다음 IOPS·대역폭과 지연을 함께 봅니다. 평균뿐 아니라 P95·P99를 비교하고 JSON 필드의 시간 단위를 확인합니다. clat는 완료 지연으로, 비동기 I/O에서는 제출·큐잉 절차 뒤부터 완료를 회수할 때까지의 구간입니다. 장치 내부 서비스 시간만 뜻하지 않으며, 전체 lat는 slat와 clat의 합입니다.
깊이를 늘려도 처리량 증가가 작고 꼬리 지연만 늘면, 그 부하에서는 추가 동시 요청의 이익이 작을 수 있습니다. 반복 시험과 실행 순서, 온도·캐시·백그라운드 작업을 확인하기 전에는 한 번의 차이를 장치 고유 성능으로 일반화하지 않습니다. 실제 서비스의 목표 지연과 요청 패턴에 맞춰 깊이를 고릅니다.
근거와 관련 글
공식 문서는 변경될 수 있습니다. 아래 정의는 확인일의 fio 문서와 Linux blk-mq 설명을 대조한 것이며, 설치한 버전의 도움말과 결과 형식을 다시 확인해야 합니다.
- fio 공식 문서: 옵션과 결과 해석 (iodepth, numjobs, allow_file_create, readonly, ramp_time, clat)
- Linux blk-mq 문서
- request_queue 원본 코드 분석 (Linux v6.6)
- request_queue 개념 설명 (Linux v6.6)
기존 커널 글은 요청 객체의 시작·완료를 설명합니다. 이 글은 fio 시험 조건과 결과 해석을 다루며, 두 설명의 관측 지점을 구분합니다.