메모리의 소유자는 여전히 각 블록입니다
CUDA thread-block cluster는 compute capability 9.0부터 제공되는 계층입니다. 같은 클러스터의 블록들은 한 GPU Processing Cluster(GPC)에 함께 실행되도록 배치됩니다. 이 범위에서 다른 블록의 shared memory를 읽고 쓰거나 원자 연산으로 갱신하는 주소 공간이 Distributed Shared Memory, DSMEM입니다.
각 블록이 할당한 메모리의 소유권과 수명은 그대로입니다. GPU 전체의 임의 블록, 다른 GPU, CPU까지 자동으로 접근 범위가 넓어지는 것이 아니며 Unified/Managed Memory와도 다른 개념입니다.
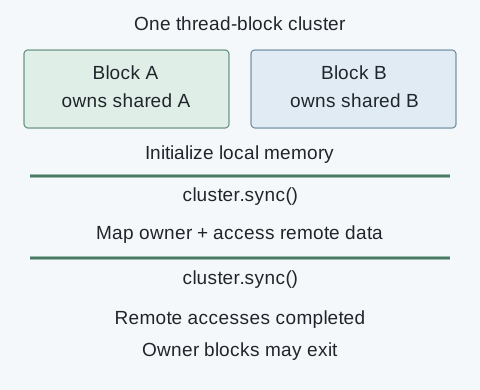
공식 histogram 예시는 bin을 소유 블록별로 나누고 cluster.map_shared_rank로 원격 shared-memory 주소를 얻습니다. 두 블록이 각각 bin 네 개를 맡는 가상 예시에서는 총 여덟 bin을 분산해 저장합니다. 한 bin의 동시 갱신에는 여전히 적절한 원자 연산이 필요합니다.
남의 메모리를 읽는 동안 소유 블록이 끝나면 안 됩니다
다른 블록의 shared memory에 접근하려면 그 블록이 존재해야 합니다. 공식 예시는 로컬 초기화 후 cluster.sync()를 호출해 초기화와 동시 존재를 맞춥니다. 원격 읽기·쓰기·atomic이 끝나기 전 소유 블록이 종료하지 않도록, 갱신 뒤에도 클러스터 동기화를 둡니다.
__syncthreads()는 한 블록 안의 장벽입니다. 이를 추가하는 것만으로 다른 블록의 초기화나 종료를 제어할 수 없습니다. 또한 클러스터 장벽에 도달하지 않는 조기 종료·조건 분기가 없는지 검토해야 합니다. 예시의 앞뒤 장벽은 모든 DSMEM 커널에 그대로 붙이는 장식이 아니라 데이터 공개와 수명 조건을 구현한 것입니다.
16블록과 227 KB는 항상 주어지는 용량이 아닙니다
Hopper Tuning Guide는 H100의 shared memory를 SM당 228 KB, 블록당 최대 227 KB로 구분합니다. DSMEM의 주소 가능 크기는 클러스터 블록 수와 실제로 설정한 블록당 할당량의 곱입니다. 최대값을 확인했다고 해서 커널이 그만큼 할당한 것은 아닙니다.
같은 안내의 클러스터 조건에서 이식 가능한 최대 크기는 8블록이고, 작은 GPU·MIG 구성에서는 더 낮아질 수 있습니다. H100의 16블록은 cudaFuncAttributeNonPortableClusterSizeAllowed로 비이식적 크기를 허용하는 조건입니다. 따라서 그림에 나오는 약 3.5 MiB를 모든 커널의 기본 용량으로 옮겨 적으면 안 됩니다.
대상 구성에서 cudaOccupancyMaxPotentialClusterSize와 cudaOccupancyMaxActiveClusters를 확인하고, 블록당 shared-memory 요청량과 허용 속성, 실제 launch 성공 여부를 함께 확인합니다. 큰 할당과 큰 클러스터가 활성 블록·클러스터 수를 줄일 수 있습니다.
줄어드는 것은 특정 중간 교환입니다
블록 간 재사용 데이터를 DSMEM에 두면 일부 global-memory 중간 읽기·쓰기를 줄일 후보가 됩니다. 하지만 global-memory 접근이 항상 HBM 왕복인 것은 아닙니다. L2 hit가 가능하고 입력·최종 출력은 여전히 global memory를 사용할 수 있습니다. “DRAM 왕복이 전혀 없다”거나 항상 낮은 지연이 보장된다고 일반화하지 않습니다.
Hopper 안내의 32바이트 세그먼트 정렬·coalescing은 원격 접근의 성능 권고입니다. 기능 사용 자체의 필수 조건으로 바꾸지 않습니다. 같은 입력과 정확도로 블록 로컬 방식, global/L2 경유 방식, DSMEM 방식을 비교하고, 시간·활성 클러스터 수·할당량·메모리 트래픽을 함께 봅니다. 원격 접근과 장벽 비용 때문에 개선되지 않는 경우도 있습니다.
출발점은 Florian Elio Mattana의 게시물과 보존 원고 #477입니다. 게시물의 외부 그림은 재게시하지 않았고, 공식 문서의 범위와 수명 조건을 대조했습니다. 실제 H100 커널 실행이나 벤치마크는 하지 않았습니다. 작업자의 실행 수명은 persistent kernel, 연산·대역폭 상한은 Roofline과 구분합니다.
English summary. DSMEM exposes per-block shared memory within a co-scheduled cluster. Initialization and owner lifetime must cover remote accesses. H100's optional 16-block configuration is not a portable default. Allocation, active clusters, synchronization cost and cache traffic determine whether it helps; no benchmark is claimed.