반복해서 다음 작업을 가져오는 작업자
Persistent kernel 패턴은 GPU 작업자가 한 커널 안에서 다음 작업을 계속 가져오도록 구성합니다. 작은 작업마다 호스트가 커널을 실행하는 비용을 줄일 후보이지만, 작업자의 수명과 입력이 도착하는 시점은 따로 설계해야 합니다.
Shashank Parsi의 HIP 예시에 보존된 코드 이미지를 읽으면, 호스트는 N=1000, data[i]=i인 배열과 0으로 초기화한 장치 카운터를 먼저 준비합니다. <<<1,128>>>은 블록 하나, 스레드 128개입니다. 각 스레드는 atomicAdd(counter,1)로 인덱스를 받아 1000 이상이면 종료하고, 그보다 작으면 해당 원소에 1을 더합니다.
HIP atomicAdd는 증가 전 값을 반환합니다. 정상적으로 초기화된 이 작은 유한 범위에서는 같은 카운터의 원자적 증가가 작업 번호의 중복 배분을 막습니다. 이는 다른 데이터의 공개 순서까지 보장하는 범용 큐 구현이라는 뜻이 아닙니다.
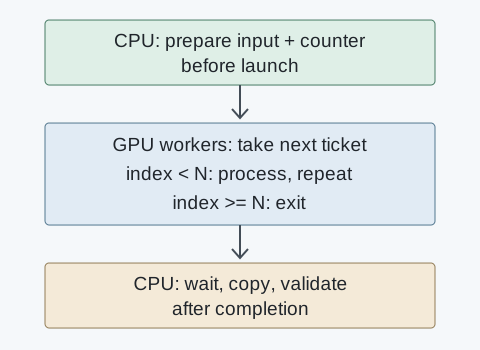
커널 뒤의 hipDeviceSynchronize()와 장치→호스트 복사 다음에 앞의 열 값만 출력합니다. 화면의 1 2 3 4 5 6 7 8 9 10은 저자 캡처이며, 전체 1000개 값이나 실행 시간의 독립 검증이 아닙니다.
빈 큐와 종료는 같은 상태가 아닙니다
실시간 호스트 생산자–GPU 소비자 큐에서는 입력을 다 썼다는 상태와 잠시 입력이 없는 상태가 다릅니다. 생산·소비 위치, 슬롯 재사용, 큐가 가득 찼을 때의 처리, 종료 신호를 정의해야 합니다. 생산자는 payload를 준비한 뒤 준비 상태를 공개하고, 소비자는 올바른 동기화로 이를 관찰한 다음 payload를 읽어야 합니다.
HIP의 coherence 문서는 메모리 종류에 따라 실행 중 가시성과 동기화 시점의 가시성이 다름을 설명합니다. 공유 가능한 주소나 coherent 메모리라고 해서 경쟁 없는 큐가 완성되는 것은 아닙니다. 호스트와 GPU 양쪽에서 지원하는 원자 연산의 범위와 메모리 순서, 실제 할당 방식까지 맞춰야 합니다.
- 유한 예시의 끝
- 이미 정한 N 이상의 번호를 받으면 해당 작업자는 종료합니다.
- 계속 입력받는 큐의 끝
- 일시적 공백과 서비스 종료를 구분하고, 처리 중 작업과 슬롯 수명까지 정리해야 합니다.
- 현재 이미지의 한계
- 실행 중 CPU가 새 작업을 넣는 경로, 생산자·소비자 인덱스와 종료 프로토콜은 구현되어 있지 않습니다.
블록 하나는 CU마다 하나라는 뜻이 아닙니다
HIP 프로그래밍 모델에서 work-group의 CU 배치와 실행 순서는 하드웨어 자원과 스케줄링의 영향을 받습니다. 이 예시의 단일 블록을 GPU 전체의 CU마다 하나씩 배치한 것으로 읽을 수 없습니다. 그리드 블록 수를 CU 수와 같게 해도 지정 CU에 일대일 고정 배치된다는 보장은 아닙니다.
장시간 살아 있는 블록은 레지스터·공유 메모리·실행 자원을 점유합니다. 단일 카운터의 경합, 빈 큐의 대기 방식, 다른 커널의 지연을 포함해서 판단해야 합니다. 커널 실행 횟수가 줄었다고 해서 처리량이나 응답 시간이 개선됐다고 결론 내리지 않습니다.
먼저 결과와 종료 조건을 확인합니다
- API 오류를 확인하고 전체 배열을 CPU 기준값과 대조합니다. 앞의 열 값 출력만으로 검사를 끝내지 않습니다.
- 작업 수가 스레드 수보다 작거나 나누어떨어지지 않는 경우, 0인 경우의 종료를 확인합니다. 큰 카운터에서는 오버플로도 따로 설계합니다.
- 같은 입력·장치·HIP 버전에서 반복 실행 방식과 단일 실행 방식을 비교합니다. 초기화·전송 포함 시간과 커널 시간은 구분합니다.
- 실시간 큐로 확장한다면 포화·공백·종료·동시 접근을 따로 검사합니다. 처리량 외에 다른 작업의 지연도 봅니다.
이 글은 보존 이미지와 공식 문서를 대조한 설명입니다. HIP 프로그램을 컴파일·실행하거나 성능을 측정하지 않았으며 원저자 코드는 재게시하지 않았습니다. 연산량과 이동량의 상한은 Roofline 설명에서 이어집니다.
English summary. An atomic ticket counter distributes a finite, preloaded workload. It is not a host-fed concurrent queue. Publication ordering, visibility, backpressure and termination need separate protocols. The one-block example and its ten printed values do not establish whole-device placement, complete correctness or speedup.