이벤트가 발생한 순간의 신원을 보존합니다
컨테이너별 CPU 사용량과 요청이 늦어진 원인은 같은 질문이 아닙니다. cgroup 카운터에 짧은 이벤트를 결합하려면 PID/TID, cgroup ID, 시간, 이벤트 종류와 대상 객체를 함께 기록해야 합니다. 컨테이너 이름은 보통 사용자 공간의 cgroup·런타임 메타데이터 해석 결과입니다.
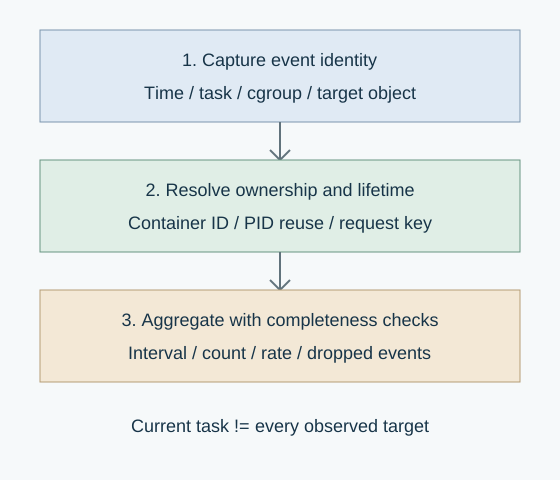
PID는 재사용되고 컨테이너는 종료됩니다. 이름 캐시만 보지 말고 식별자의 수명과 매핑 시각을 남깁니다. I/O 완료를 실행한 task와 요청을 시작한 task도 다를 수 있으므로, 제출 시점의 귀속 정보를 완료와 정확히 연결해야 합니다.
카운터와 이벤트는 같은 값을 뜻하지 않습니다
- cpu.stat과 CPU 사용률은 runnable 대기 시간과 다릅니다. 스케줄러 시각을 작업별로 연결해야 합니다.
- memory.events는 기본적으로 하위 cgroup 사건도 포함합니다. memory.events.local은 해당 cgroup 자체의 사건을 나타냅니다. high·max·oom·oom_kill을 구분하고 OOM 종료를 곧바로 누수로 단정하지 않습니다.
- block request 지연은 syscall 지연이 아닙니다. Page cache hit에는 block 요청이 없을 수 있습니다.
- TCP 재전송은 관측 결과입니다. 혼잡, 경로 손실, 상대 상태를 추가로 대조해야 합니다.
- 전체 syscall 평균이나 상위 몇 개 항목은 긴 꼬리와 누락된 이벤트를 설명하지 못합니다.
cgroup v2 문서와 기존 메모리 압박 글의 계층·카운터 정의를 이벤트 시간축과 맞춥니다.
공개 에이전트에서 확인한 정적 검토 지점
Karim Hassan의 소개를 계기로 observability_agent의 고정 커밋 d4886f21을 대조했습니다. 아래는 지정 파일의 소스 검토이며 실행 장애 재현이나 전체 코드 감사가 아닙니다.
- memory.c: page fault 분류
- PF_PROT 비트로 minor/major를 나누지만 non-present fault에도 디스크 접근 없이 해결되는 경우가 있습니다. VM_FAULT_MAJOR의 저장장치 읽기 결과와 같은 계수로 취급하지 않습니다.
- cpu.c: 다음 task의 cgroup
- sched_switch에서 next_pid를 기록하면서 현재 task의 cgroup ID를 넣습니다. Linux v6.18 tracepoint의 해당 current는 이전 task입니다. 두 task가 다른 cgroup인 전환에서 귀속을 검증해야 합니다.
- io.c: 요청 키와 제외된 완료
- 임시 키는 장치와 sector 하위 32비트의 조합입니다. 같은 키의 동시 요청이 충돌할 수 있는지 확인해야 하며, 오류 완료는 map 항목을 지우고 통계에서 제외합니다. 모든 I/O와 오류 지연을 완전하게 집계한다는 뜻이 아닙니다.
- network.c: flow 범위
- flow map 키는 IPv4 주소와 포트를 사용합니다. 별도 이벤트에 IPv6 주소 필드가 있어도 IPv6 flow 집계가 완전하다는 증거는 아닙니다.
Docker 설명과 Kubernetes 권한을 혼동하지 않습니다
고정 커밋의 DaemonSet은 privileged: true, hostPID: true, hostNetwork: true와 host mount를 사용합니다. 다른 배포 예시의 “privileged 불필요” 설명을 이 구성의 보안 보증으로 옮기지 않습니다. Kubernetes Baseline은 host namespace 공유와 privileged 컨테이너를 허용하지 않습니다.
BPF 설계 Q&A는 tracepoint와 kprobe 부착 위치를 안정 ABI로 보장하지 않습니다. 대상 커널에서 필드·프로그램 로드·verifier 통과를 확인하고, 일부 모듈 실패를 정상적인 무이벤트 화면과 구분해야 합니다. 이 글은 권한 확대나 에이전트 설치를 지시하지 않습니다.
조용한 화면이 사건 감소인지 손실인지 확인합니다
BPF ring buffer는 공간이 부족하면 reservation이 실패하며 producer가 기다리지 않습니다. 실패·손실 계수와 consumer 처리율 없이 “이벤트가 없었다”고 판정하지 않습니다.
같은 호스트·커널·컨테이너 부하에서 agent OFF/ON을 반복하고 모듈도 하나씩 켭니다. 처리량, p50/p99, CPU 시간, agent·map 메모리, 이벤트 발생률·소비율을 함께 기록합니다. 화면 예시만으로 near-zero overhead를 입증할 수 없습니다. /proc·strace·perf 관측 원칙처럼 도구 자체의 영향도 측정 대상입니다.
원 게시물의 여섯 그림을 이번 중앙 검토에서 다시 열거나 복제하지 않았습니다. 고정 소스와 공식 문서의 해당 항목을 확인했으며, 전체 Go 수집기 감사·커널 로드·컨테이너 배포·성능 측정은 하지 않았습니다.