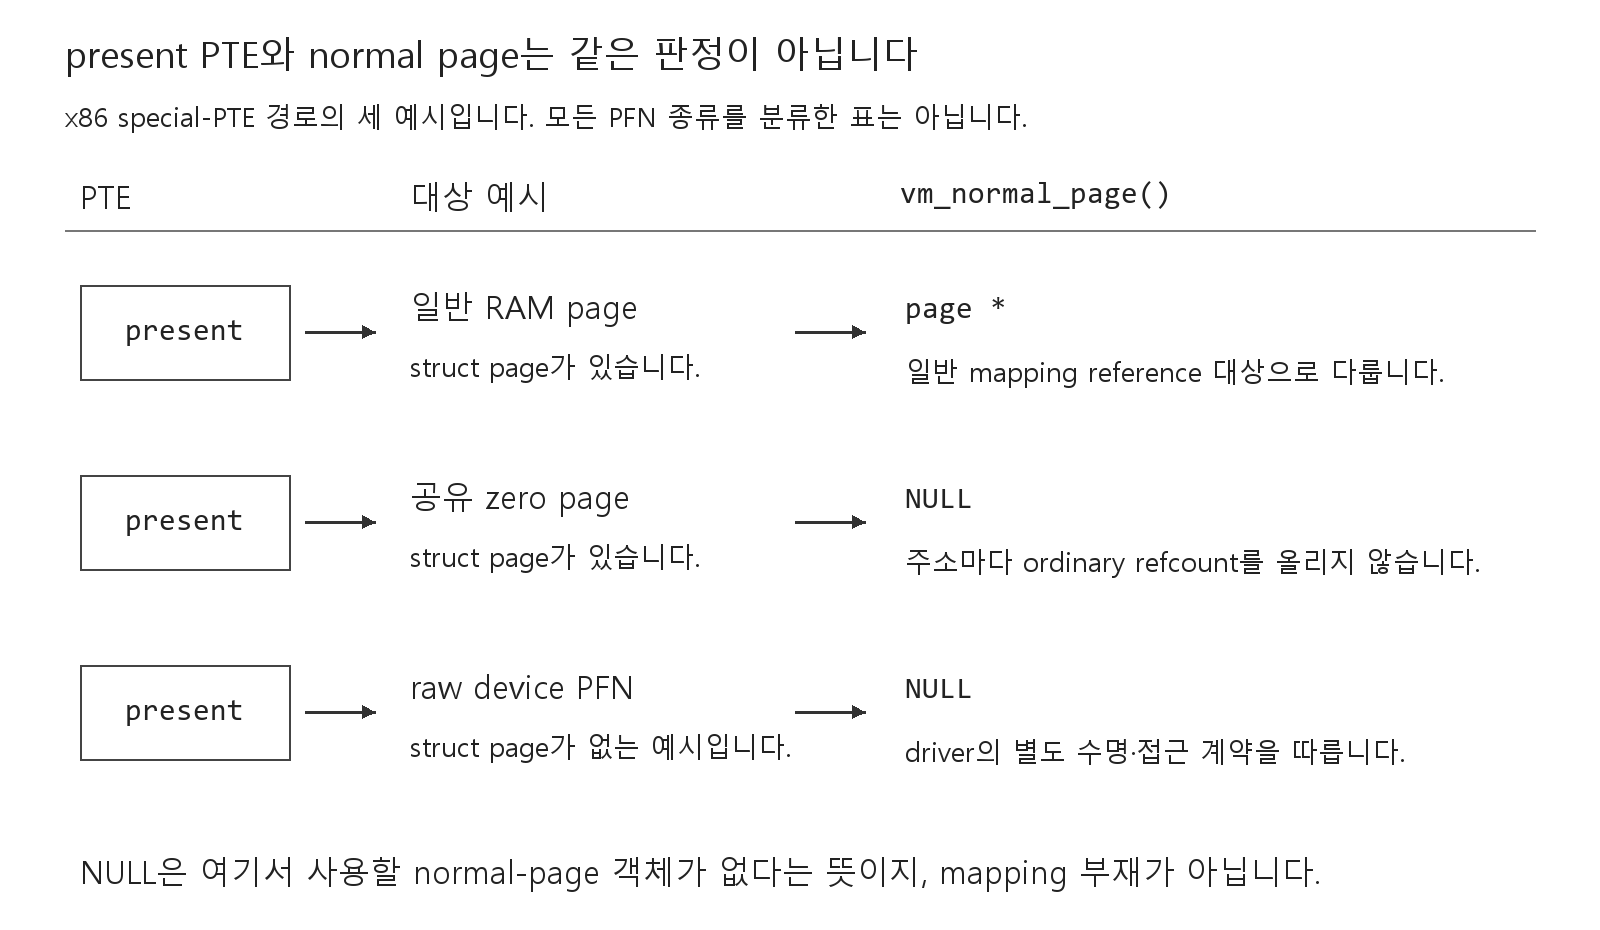
PTE에서 PFN을 읽을 수 있다면 언제나 struct page를 얻어 reference를 올려도 될까요. device memory와 special mapping에서는 그렇지 않습니다. RAM의 metadata가 존재하는지와 일반 page 수명 규칙을 적용해도 되는지는 다른 질문입니다.
normal이라는 판정의 의미
vm_normal_page()는 주어진 VMA·주소·PTE를 일반적인 page reference 대상으로 다룰 수 있는지 판단합니다. x86 special PTE, zero PFN, VM_PFNMAP·VM_MIXEDMAP와 callback 조건을 구분합니다. NULL은 “translation이 없다”가 아니라 “이 entry에 일반 page 계약을 적용하지 않는다”는 결과일 수 있습니다.
zero page에도 metadata가 존재하지만 일반 anonymous allocation처럼 reference를 관리하지 않습니다. raw device PFN에는 아예 보통의 struct page가 없을 수 있습니다. 반대로 device 관련 mapping 중에도 별도 metadata와 lifetime protocol을 가진 경우가 있어 PFNMAP라는 단어 하나로 전부 같은 대상으로 취급할 수 없습니다.
연속 PFN과 mixed mapping
v6.0 remap_pfn_range_notrack()는 page-aligned 시작 주소를 요구하고 크기는 PAGE_ALIGN으로 올려 끝을 구합니다. CoW 가능한 VMA라면 전체 VMA를 정확히 덮어야 하며, 시작 PFN을 vm_pgoff에 기록합니다. special PTE bit가 없는 architecture에서는 vm_pgoff + ((addr - vm_start) >> PAGE_SHIFT)와 실제 PFN이 같은지로 원래 PFN mapping을 식별하고, 그 관계를 벗어난 CoW page를 normal로 구분합니다. x86의 special-bit 경로와 이 fallback 규칙을 섞어 적용하면 안 됩니다.
이 helper가 설정하는 VM_IO는 side effect가 있을 수 있는 접근이라는 신호이고, VM_PFNMAP은 raw PFN 수명 규칙, VM_DONTEXPAND는 확장 제한, VM_DONTDUMP는 core dump 제외에 관계합니다. notrack 변형의 caller는 pgprot_t의 caching bit를 미리 검증해야 합니다. pfn -= addr >> PAGE_SHIFT 뒤 각 virtual address의 page 번호를 다시 더하는 것은 원하는 선형 PFN translation을 유지하려는 좌표 변환입니다. table allocation 실패는 error로 전파하며 이 helper가 그때까지 설치한 모든 entry를 자체적으로 rollback하는 함수라고 가정해서는 안 됩니다.
vm_normal_page()의 callback find_special_page가 있으면 그 계약이 먼저 적용될 수 있습니다. special bit가 없을 때 MIXEDMAP은 pfn_valid()로 normal metadata를 구분하고, special bit가 있는 x86에서는 entry별 special 판정이 우선합니다. 예기치 않은 special entry나 memmap 범위를 벗어난 PFN은 bad-PTE 진단 대상입니다. PageReserved page도 반환될 수 있으므로 normal이라는 결과가 곧 자유롭게 free 가능한 page라는 뜻은 아닙니다. devmap·ZONE_DEVICE의 역사적 reference 규칙은 일반 raw PFN과 다시 구분합니다.
remap_pfn_range() 계열은 driver가 지정한 PFN 구간을 user page table에 연결합니다. table walk와 필요한 table allocation, architecture protection 처리가 있지만 page allocator가 새 user data를 공급하는 anonymous fault와는 다릅니다. backing device의 수명과 teardown은 driver의 계약입니다.
VM_MIXEDMAP은 같은 VMA에 normal page와 PFN-only entry가 섞일 수 있는 경우를 나타냅니다. page 삽입 API와 vmf_insert_mixed() 같은 PFN fault API가 구별됩니다. VMA 하나에 속한다는 이유로 모든 PTE의 reference 처리가 같다고 가정해서는 안 됩니다.
special private CoW는 source를 어떻게 읽는가
v6.0의 정확한 실패 처리는 두 갈래입니다. 먼저 inatomic user copy가 실패하면 PTE lock을 얻고 original snapshot과 비교합니다. PTE가 달라졌으면 false로 돌아가 target을 버리고 refault할 수 있게 합니다. PTE가 같으면 lock 아래에서 한 번 더 copy를 시도하며, 여전히 읽을 수 없으면 WARN을 남기고 target page 전체를 zero-fill한 뒤 성공으로 취급합니다. 부분 copy의 나머지 byte만 놔두는 동작이 아닙니다. software accessed-bit architecture에서 이미 lock을 가진 경우에는 그 상태에 맞는 경로를 사용합니다.
아래 bool 반환의 전체 정의는 v6.0입니다. v6.18의 같은 helper는 kmap_local_page()와 명시적인 pagefault disable/enable을 사용하고, PTE 경쟁은 -EAGAIN, normal source의 machine-check copy 실패는 -EHWPOISON, 성공은 0으로 구분합니다. caller가 이 결과를 해석하는 방식까지 함께 바뀌었으므로 bool 성공 검사를 그대로 가져오면 안 됩니다. 이 역사적 best-effort zero-fill은 모든 device mapping에 대해 신뢰할 수 있는 snapshot copy를 제공한다는 약속이 아닙니다.
normal page가 없는 private source도 CoW가 필요할 수 있습니다. 일반 copy_user_highpage()에 page pointer를 전달할 수 없으므로 special copy 경로는 source의 user mapping을 통해 읽는 방식을 사용합니다. 그 접근에는 uaccess exception 복구가 필요합니다. driver backing을 무조건 direct-map pointer로 바꾸어 memcpy하는 방식이 아닙니다.
copy 중 entry가 바뀌거나 user access가 실패할 수 있습니다. fault handler는 PTE 상태를 다시 확인하고 복사하지 못한 byte가 새 private target에서 정보 유출로 이어지지 않도록 처리합니다. 이 세부 분기는 architecture와 callback에 민감하므로 normal RAM의 CoW 순서를 special PFN에 기계적으로 적용하지 않습니다.
shared writable PFN에는 copy 대신 승인 경로가 있습니다
shared PFN write fault에는 pfn_mkwrite를 호출하는 경로가 있습니다. 잠들 수 있도록 PTE lock을 놓고 callback을 수행한 뒤 재획득하여 snapshot을 비교합니다. callback이 없는 허용 경로는 PTE reuse로 끝날 수 있습니다. 일반 folio가 없는 만큼 file folio처럼 dirty flag와 put_page를 무조건 수행하면 안 됩니다.
special mapping을 다룰 때의 원칙은 명확합니다. PTE 상태, PFN의 종류, metadata 존재와 ownership protocol을 따로 확인해야 합니다. 이 구별은 fault뿐 아니라 GUP, munmap과 device driver의 buffer 수명에서도 그대로 필요합니다.
Linux v6.0의 special mapping 전체 정의
special-bit architecture와 그 bit가 없는 architecture의 판정 차이, raw PFN 설치와 CoW copy 실패 경로를 끝까지 비교합니다. 이 tag의 bool 반환 helper를 최신 error-code interface와 혼합하지 않습니다.
아래는 Linux v6.0의 전체 함수·자료형 정의입니다. kernel의 header·configuration·호출 규약에 의존하는 코드이며 독립 실행 프로그램은 아닙니다. 본문 해설과는 별도로 각 source의 SPDX license를 적용합니다. 원래 copyright notice는 source notice에, GPL version 2 전문은 license 파일에 보존합니다. 표시상의 tab을 space로 바꾼 것 외에 함수 내부의 문장이나 configuration 분기는 제거하지 않았습니다.
vm_normal_page()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
struct page *vm_normal_page(struct vm_area_struct *vma, unsigned long addr,
                pte_t pte)
{
    unsigned long pfn = pte_pfn(pte);

    if (IS_ENABLED(CONFIG_ARCH_HAS_PTE_SPECIAL)) {
        if (likely(!pte_special(pte)))
            goto check_pfn;
        if (vma->vm_ops && vma->vm_ops->find_special_page)
            return vma->vm_ops->find_special_page(vma, addr);
        if (vma->vm_flags & (VM_PFNMAP | VM_MIXEDMAP))
            return NULL;
        if (is_zero_pfn(pfn))
            return NULL;
        if (pte_devmap(pte))
        /*
         * NOTE: New users of ZONE_DEVICE will not set pte_devmap()
         * and will have refcounts incremented on their struct pages
         * when they are inserted into PTEs, thus they are safe to
         * return here. Legacy ZONE_DEVICE pages that set pte_devmap()
         * do not have refcounts. Example of legacy ZONE_DEVICE is
         * MEMORY_DEVICE_FS_DAX type in pmem or virtio_fs drivers.
         */
            return NULL;

        print_bad_pte(vma, addr, pte, NULL);
        return NULL;
    }

    /* !CONFIG_ARCH_HAS_PTE_SPECIAL case follows: */

    if (unlikely(vma->vm_flags & (VM_PFNMAP|VM_MIXEDMAP))) {
        if (vma->vm_flags & VM_MIXEDMAP) {
            if (!pfn_valid(pfn))
                return NULL;
            goto out;
        } else {
            unsigned long off;
            off = (addr - vma->vm_start) >> PAGE_SHIFT;
            if (pfn == vma->vm_pgoff + off)
                return NULL;
            if (!is_cow_mapping(vma->vm_flags))
                return NULL;
        }
    }

    if (is_zero_pfn(pfn))
        return NULL;

check_pfn:
    if (unlikely(pfn > highest_memmap_pfn)) {
        print_bad_pte(vma, addr, pte, NULL);
        return NULL;
    }

    /*
     * NOTE! We still have PageReserved() pages in the page tables.
     * eg. VDSO mappings can cause them to exist.
     */
out:
    return pfn_to_page(pfn);
}
remap_pfn_range_notrack()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
int remap_pfn_range_notrack(struct vm_area_struct *vma, unsigned long addr,
        unsigned long pfn, unsigned long size, pgprot_t prot)
{
    pgd_t *pgd;
    unsigned long next;
    unsigned long end = addr + PAGE_ALIGN(size);
    struct mm_struct *mm = vma->vm_mm;
    int err;

    if (WARN_ON_ONCE(!PAGE_ALIGNED(addr)))
        return -EINVAL;

    /*
     * Physically remapped pages are special. Tell the
     * rest of the world about it:
     *   VM_IO tells people not to look at these pages
     *  (accesses can have side effects).
     *   VM_PFNMAP tells the core MM that the base pages are just
     *  raw PFN mappings, and do not have a "struct page" associated
     *  with them.
     *   VM_DONTEXPAND
     *      Disable vma merging and expanding with mremap().
     *   VM_DONTDUMP
     *      Omit vma from core dump, even when VM_IO turned off.
     *
     * There's a horrible special case to handle copy-on-write
     * behaviour that some programs depend on. We mark the "original"
     * un-COW'ed pages by matching them up with "vma->vm_pgoff".
     * See vm_normal_page() for details.
     */
    if (is_cow_mapping(vma->vm_flags)) {
        if (addr != vma->vm_start || end != vma->vm_end)
            return -EINVAL;
        vma->vm_pgoff = pfn;
    }

    vma->vm_flags |= VM_IO | VM_PFNMAP | VM_DONTEXPAND | VM_DONTDUMP;

    BUG_ON(addr >= end);
    pfn -= addr >> PAGE_SHIFT;
    pgd = pgd_offset(mm, addr);
    flush_cache_range(vma, addr, end);
    do {
        next = pgd_addr_end(addr, end);
        err = remap_p4d_range(mm, pgd, addr, next,
                pfn + (addr >> PAGE_SHIFT), prot);
        if (err)
            return err;
    } while (pgd++, addr = next, addr != end);

    return 0;
}
__wp_page_copy_user()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static inline bool __wp_page_copy_user(struct page *dst, struct page *src,
                       struct vm_fault *vmf)
{
    bool ret;
    void *kaddr;
    void __user *uaddr;
    bool locked = false;
    struct vm_area_struct *vma = vmf->vma;
    struct mm_struct *mm = vma->vm_mm;
    unsigned long addr = vmf->address;

    if (likely(src)) {
        copy_user_highpage(dst, src, addr, vma);
        return true;
    }

    /*
     * If the source page was a PFN mapping, we don't have
     * a "struct page" for it. We do a best-effort copy by
     * just copying from the original user address. If that
     * fails, we just zero-fill it. Live with it.
     */
    kaddr = kmap_atomic(dst);
    uaddr = (void __user *)(addr & PAGE_MASK);

    /*
     * On architectures with software "accessed" bits, we would
     * take a double page fault, so mark it accessed here.
     */
    if (arch_faults_on_old_pte() && !pte_young(vmf->orig_pte)) {
        pte_t entry;

        vmf->pte = pte_offset_map_lock(mm, vmf->pmd, addr, &vmf->ptl);
        locked = true;
        if (!likely(pte_same(*vmf->pte, vmf->orig_pte))) {
            /*
             * Other thread has already handled the fault
             * and update local tlb only
             */
            update_mmu_tlb(vma, addr, vmf->pte);
            ret = false;
            goto pte_unlock;
        }

        entry = pte_mkyoung(vmf->orig_pte);
        if (ptep_set_access_flags(vma, addr, vmf->pte, entry, 0))
            update_mmu_cache(vma, addr, vmf->pte);
    }

    /*
     * This really shouldn't fail, because the page is there
     * in the page tables. But it might just be unreadable,
     * in which case we just give up and fill the result with
     * zeroes.
     */
    if (__copy_from_user_inatomic(kaddr, uaddr, PAGE_SIZE)) {
        if (locked)
            goto warn;

        /* Re-validate under PTL if the page is still mapped */
        vmf->pte = pte_offset_map_lock(mm, vmf->pmd, addr, &vmf->ptl);
        locked = true;
        if (!likely(pte_same(*vmf->pte, vmf->orig_pte))) {
            /* The PTE changed under us, update local tlb */
            update_mmu_tlb(vma, addr, vmf->pte);
            ret = false;
            goto pte_unlock;
        }

        /*
         * The same page can be mapped back since last copy attempt.
         * Try to copy again under PTL.
         */
        if (__copy_from_user_inatomic(kaddr, uaddr, PAGE_SIZE)) {
            /*
             * Give a warn in case there can be some obscure
             * use-case
             */
warn:
            WARN_ON_ONCE(1);
            clear_page(kaddr);
        }
    }

    ret = true;

pte_unlock:
    if (locked)
        pte_unmap_unlock(vmf->pte, vmf->ptl);
    kunmap_atomic(kaddr);
    flush_dcache_page(dst);

    return ret;
}
참고 자료
Lorenzo Stoakes, The Linux Memory Manager, Chapter 6 §6.12. normal-page 판정, remap과 special copy는 Linux v6.18 mm/memory.c, driver interface는 Memory Management APIs를 참고하실 수 있습니다.