연속된 virtual range를 예약하는 일과 그 주소에서 읽고 쓸 수 있게 만드는 일은 다릅니다. vmalloc의 뒷부분은 page들을 확보하고, 그 page들을 추적할 배열을 만들고, kernel page table에 연결합니다. 이 중간에 실패하면 이미 성공한 부분만 정확히 되돌려야 합니다.
이 흐름은 성공 경로보다 실패 경로를 먼저 생각하면 선명해집니다. 주소만 확보한 상태, page가 일부 있는 상태, PTE까지 일부 설치한 상태는 해제 대상이 서로 다릅니다. upstream v6.18의 __vmalloc_area_node()와 관련 mapping helper들을 기준으로 그 경계를 살펴보겠습니다.
page 배열도 메모리를 사용합니다
vmalloc은 struct page * 배열을 이용해 backing page들을 기억합니다. data 크기를 base-page 단위로 센 값에 pointer 크기를 곱하면 배열에 필요한 byte 수가 됩니다. 4 KiB page와 8-byte pointer 환경에서 data가 4 MiB이면 1,024개 pointer, 즉 8 KiB 배열이 필요합니다. 배열은 data page 자체가 아니라 그 page들의 목록입니다.
__vmalloc_area_node()는 작은 배열에는 kmalloc_node_noprof()를, 배열이 한 page보다 크면 vmalloc 계열을 사용합니다. vmalloc을 구현하려고 다시 vmalloc을 호출하지만 같은 크기로 무한히 재귀하지는 않습니다. 관리할 data page 수에 비례한 pointer 배열은 data보다 훨씬 작아지고, 결국 작은 배열을 직접 할당하는 경계에 도달합니다.
배열용 GFP mask에는 reclaim 관련 제한을 전달하고 __GFP_ZERO를 추가합니다. 배열을 0으로 준비하면 아직 채우지 않은 slot과 이미 확보한 page를 구분하기도 쉽습니다. 그렇다고 NULL slot을 만날 때까지 무작정 해제하는 것은 아닙니다. 실제 확보 수인 area->nr_pages가 부분 성공의 범위를 기록합니다.
data page의 GFP 조건과 page-table protection도 구분해야 합니다. GFP는 page를 어느 조건에서 확보할지에 관한 것이고 pgprot_t는 CPU가 그 mapping을 어떻게 사용할지에 관한 것입니다. PAGE_KERNEL을 넘겼다고 reclaim이 허용되는 것도 아니며, GFP_KERNEL만으로 NX 등 모든 PTE 속성이 정해지는 것도 아닙니다. 현재 helper에는 DMA zone modifier가 없는 경우 highmem 허용을 더하는 내부 처리도 있지만, 이를 공개 vmalloc API가 임의의 zone modifier를 지원한다는 뜻으로 확대해서는 안 됩니다.
bulk allocation은 부분 성공할 수 있습니다
vm_area_alloc_pages()는 order-0 page를 한 장씩만 요청하지 않습니다. bulk allocator로 묶어서 확보하면 반복적인 allocator 진입 비용을 줄일 수 있습니다. v6.18의 한 번 요청 상한은 100 page입니다. 긴 preemption-off 구간을 피하기 위한 batching이지 vmalloc allocation 전체의 크기 제한이 아닙니다.
bulk allocator가 요청한 수보다 적게 돌려주어도 즉시 모든 작업을 포기하지는 않습니다. 먼저 얻은 page 수를 누적하고, 나머지는 더 허용적인 단일 page allocation 경로로 시도할 수 있습니다. 이 경로의 NUMA 선택도 중요합니다. 명시적인 node가 없는 NUMA_NO_NODE를 단순히 가장 가까운 node로 치환하면 task의 mempolicy를 무시할 수 있습니다. 현재 코드는 policy에 맞는 allocation과 node 지정 allocation을 구분합니다.
반복 도중 allocator가 끝내 page를 내주지 못하면 현재까지 확보한 수를 반환합니다. fatal signal의 조건에는 version 차이가 있습니다. 책의 loop는 signal이 pending이면 중단하지만, v6.18은 __GFP_NOFAIL이 없을 때만 signal로 빠집니다. 호출자는 요청 수와 실제 수가 같은지 비교해야 합니다. allocation 실패의 이유가 RAM 부족뿐이라고 생각하면 signal 중단과 큰 order 확보 실패를 오진할 수 있습니다. 현재 코드는 이러한 경우의 경고를 구별하여 불필요한 실패 메시지도 줄입니다.
큰 allocation과 큰 leaf를 연결합니다
huge vmap 경로는 높은 order의 physical allocation을 시도할 수 있습니다. 큰 leaf 하나가 physical로 연속된 범위를 표현하려면 그에 맞는 backing이 필요하기 때문입니다. virtual alignment만 크게 맞추고 흩어진 임의의 page들을 2 MiB leaf 하나에 연결할 수는 없습니다.
확보한 높은 order allocation은 이 경로에서 base-page 단위로 추적할 수 있도록 split합니다. __GFP_COMP로 compound metadata를 만들겠다는 요구와, 해제 시 각 base page를 독립적으로 처리하려는 요구는 구별해야 합니다. 현재 vm_area_alloc_pages()는 order가 있으면 split_page()를 사용하며 이 helper가 임의의 compound allocation을 모두 받아 주는 계약은 아닙니다. nr_pages도 큰 덩어리 개수가 아니라 배열에 기록한 base page 수입니다.
큰 order 시도는 실패할 수 있으므로 __vmalloc_node_range_noprof()에는 page shift를 base-page로 낮추는 fallback이 있습니다. 실패한 큰 시도에서 얻은 일부 page와 예약을 먼저 정리한 뒤 다시 시작해야 합니다. 같은 vm_struct에 이전 시도의 page들을 남겨 둔 채 새로운 order를 섞어 성공으로 처리하는 흐름이 아닙니다. 특히 큰 order에는 __GFP_NOFAIL을 그대로 적용하지 않습니다. 큰 연속 allocation을 끝없이 강제하면 reclaim과 compaction의 부담이 지나치게 커질 수 있기 때문입니다.
다음은 v6.18 vm_area_alloc_pages()의 전체 정의입니다. bulk의 부분 성공 뒤에는 pages + nr_allocated부터 이어 쓰며, 높은 order에서는 1U << order개 base page를 배열에 기록합니다. 예전 listing의 bulk_gfp에서 NOFAIL을 지우는 local 처리와 매 loop의 cond_resched()를 현재 함수에도 있다고 가정하지 않습니다. 현재 코드는 이 부분이 달라졌습니다.
code는 upstream GPL-2.0-only이며 source·license 기록, GPL-2.0 text를 제공합니다. 전체 함수이지만 kernel 의존성을 가진 code이고 standalone 실행·kernel runtime 검증은 하지 않았습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  Copyright (C) 1993  Linus Torvalds
 *  Support of BIGMEM added by Gerhard Wichert, Siemens AG, July 1999
 *  SMP-safe vmalloc/vfree/ioremap, Tigran Aivazian <tigran@veritas.com>, May 2000
 *  Major rework to support vmap/vunmap, Christoph Hellwig, SGI, August 2002
 *  Numa awareness, Christoph Lameter, SGI, June 2005
 *  Improving global KVA allocator, Uladzislau Rezki, Sony, May 2019
 */
/*
 * Linux v6.18, mm/vmalloc.c:3590-3676
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/vmalloc.c
 * Complete function: vm_area_alloc_pages
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static inline unsigned int
vm_area_alloc_pages(gfp_t gfp, int nid,
		unsigned int order, unsigned int nr_pages, struct page **pages)
{
	unsigned int nr_allocated = 0;
	struct page *page;
	int i;

	/*
	 * For order-0 pages we make use of bulk allocator, if
	 * the page array is partly or not at all populated due
	 * to fails, fallback to a single page allocator that is
	 * more permissive.
	 */
	if (!order) {
		while (nr_allocated < nr_pages) {
			unsigned int nr, nr_pages_request;

			/*
			 * A maximum allowed request is hard-coded and is 100
			 * pages per call. That is done in order to prevent a
			 * long preemption off scenario in the bulk-allocator
			 * so the range is [1:100].
			 */
			nr_pages_request = min(100U, nr_pages - nr_allocated);

			/* memory allocation should consider mempolicy, we can't
			 * wrongly use nearest node when nid == NUMA_NO_NODE,
			 * otherwise memory may be allocated in only one node,
			 * but mempolicy wants to alloc memory by interleaving.
			 */
			if (IS_ENABLED(CONFIG_NUMA) && nid == NUMA_NO_NODE)
				nr = alloc_pages_bulk_mempolicy_noprof(gfp,
							nr_pages_request,
							pages + nr_allocated);
			else
				nr = alloc_pages_bulk_node_noprof(gfp, nid,
							nr_pages_request,
							pages + nr_allocated);

			nr_allocated += nr;

			/*
			 * If zero or pages were obtained partly,
			 * fallback to a single page allocator.
			 */
			if (nr != nr_pages_request)
				break;
		}
	}

	/* High-order pages or fallback path if "bulk" fails. */
	while (nr_allocated < nr_pages) {
		if (!(gfp & __GFP_NOFAIL) && fatal_signal_pending(current))
			break;

		if (nid == NUMA_NO_NODE)
			page = alloc_pages_noprof(gfp, order);
		else
			page = alloc_pages_node_noprof(nid, gfp, order);

		if (unlikely(!page))
			break;

		/*
		 * High-order allocations must be able to be treated as
		 * independent small pages by callers (as they can with
		 * small-page vmallocs). Some drivers do their own refcounting
		 * on vmalloc_to_page() pages, some use page->mapping,
		 * page->lru, etc.
		 */
		if (order)
			split_page(page, order);

		/*
		 * Careful, we allocate and map page-order pages, but
		 * tracking is done per PAGE_SIZE page so as to keep the
		 * vm_struct APIs independent of the physical/mapped size.
		 */
		for (i = 0; i < (1U << order); i++)
			pages[nr_allocated + i] = page + i;

		nr_allocated += 1U << order;
	}

	return nr_allocated;
}
page table은 또 다른 allocation입니다
backing page를 모두 얻었어도 끝이 아닙니다. kernel virtual range를 설명할 page-table page가 없으면 새로 확보해야 합니다. data allocation이 성공하고 page-table allocation이 실패하는 경우도 정상적인 실패 경로에 포함되어야 합니다.
다음은 구현 코드가 아닌 호출관계입니다. profiling wrapper와 architecture별 큰-leaf 세부 분기는 생략한 개념적 흐름입니다.
__vmalloc_area_node
  -> vm_area_alloc_pages
  -> vmap_pages_range
     -> vmap_pages_range_noflush
        -> __vmap_pages_range_noflush
           -> vmap_small_pages_range_noflush
              -> vmap_pages_p4d_range -> vmap_pages_pud_range
                 -> vmap_pages_pmd_range -> vmap_pages_pte_range
완전한 함수 정의는 Linux v6.18 mm/vmalloc.c에 있습니다. 이 경로는 범위를 각 level의 경계로 나누어 순회합니다. pgd_addr_end() 같은 helper는 다음 top-level 경계나 요청 끝 중 먼저 오는 곳까지만 처리하게 합니다. 한 loop에서 서로 다른 PGD entry가 담당할 주소를 잘못 섞지 않기 위한 제한입니다. 아래 level에도 같은 구조가 반복됩니다.
p4d_alloc_track(), pud_alloc_track(), pmd_alloc_track() 등의 helper는 없는 table을 준비하면서 어느 level이 변경되었는지도 기록합니다. folded level은 실제 table을 하나 더 할당하는 단계가 아닙니다. 최하위 PTE 경로는 page 배열의 다음 항목을 골라 PFN과 protection을 조합하여 entry를 설치합니다. 이미 차 있는 entry를 아무 설명 없이 덮어쓰는 범용 API가 아니며, 배열의 유효 범위와 page의 적합성을 검사하는 조건도 있습니다.
huge mapping을 선택할 수 있는 범위는 위 순회에서 큰 leaf로 설치할 수 있습니다. 작은 page 경로를 설명하는 호출관계만 보고 모든 성공 결과가 PTE leaf라고 단정하면 안 됩니다. 반대로 huge 경로가 존재한다고 해서 모든 범위가 하나의 큰 leaf가 되는 것도 아닙니다.
allocation context와 mapping 동기화
호출자가 data allocation에 GFP_NOFS 또는 GFP_NOIO 제한을 주었는데 내부 page-table allocation이 이를 무시하면 문제가 됩니다. filesystem lock을 쥔 경로가 filesystem reclaim에 다시 들어가거나, 금지한 I/O를 유발할 수 있습니다. 현재 구현은 mapping 동안 memalloc_nofs_save() 또는 memalloc_noio_save()로 scope를 설정하고 작업 후 이전 상태로 복구합니다. 인자 한 개가 내부 모든 allocator에 자동 전파된다고 기대하지 않는 방식입니다.
mapping을 마친 뒤에는 architecture가 요구하는 cache 및 kernel mapping 동기화도 수행해야 합니다. flush_cache_vmap()이 특정 architecture에서 가벼울 수 있다는 것과, 호출 자체가 불필요하다는 것은 다릅니다. 또한 수정 level을 모은 mask와 ARCH_PAGE_TABLE_SYNC_MASK가 겹치면 arch_sync_kernel_mappings()가 필요할 수 있습니다. v6.18 x86은 이 mask를 정의하므로, x86에서는 항상 아무 동기화도 하지 않는다고 일반화할 수 없습니다.
TLB invalidation과 data-cache coherency도 서로 다른 문제입니다. 새 주소를 게시하는 시점, 이전 mapping을 제거한 주소의 재사용 시점, permission 변경 뒤의 동기화 요구를 각 API 계약에 맞춰 지켜야 합니다. helper 이름에 noflush가 붙은 이유도 호출자가 뒤에서 맡을 일이 남아 있기 때문입니다.
실패하면 실제로 얻은 것만 돌려줍니다
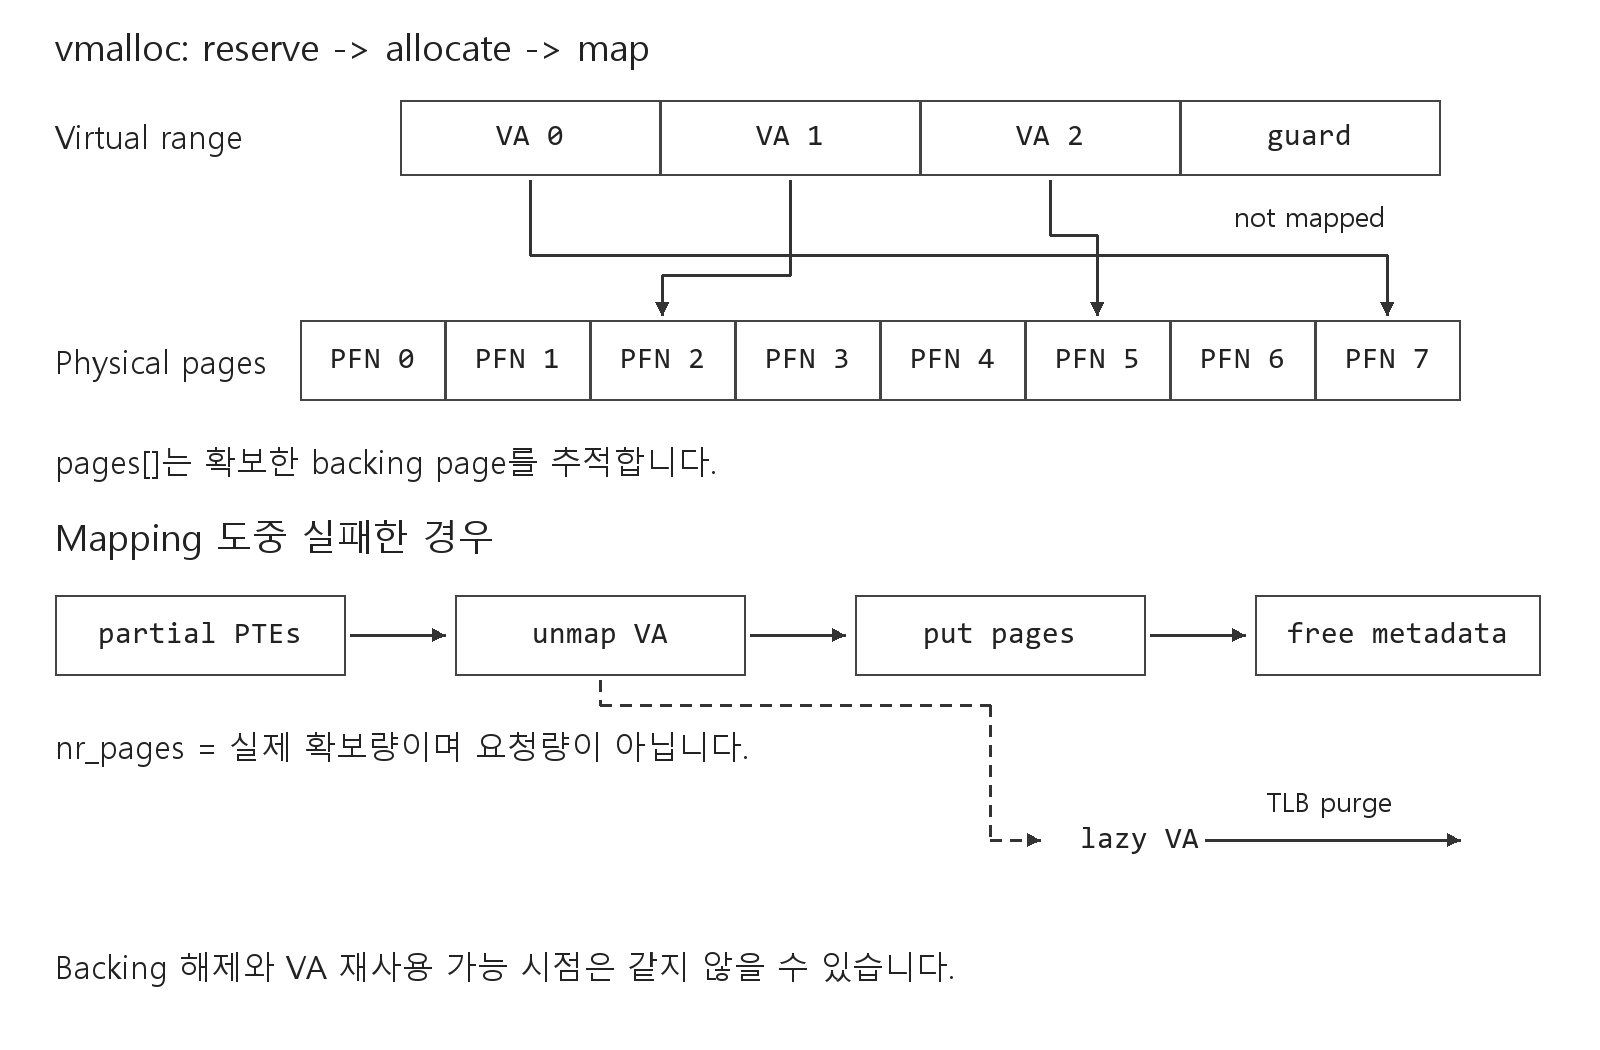
그림은 주소 예약, page 확보와 mapping을 구분한 도식입니다. KASAN, memcg와 각 architecture의 cache 처리는 세부 단계로 표시하지 않았습니다.
page 배열만 실패했다면 data page는 아직 없습니다. 이때 현재 __vmalloc_area_node()는 free_vm_area()로 주소와 metadata를 정리합니다. 반면 backing page가 일부 있거나 mapping 단계에서 실패하면 fail label의 vfree()로 갑니다. 모든 실패가 같은 label로 모이지는 않습니다. 객체가 가진 nr_pages가 해제 범위를 결정하므로, 요청했던 전체 길이를 성공한 page 수로 착각하면 아직 없는 page를 해제하게 됩니다.
vfree()는 mapping을 제거하고 backing page들을 반환하며 page 배열과 metadata를 정리합니다. 높은 order에서 split한 page도 base-page 배열로 해제할 수 있게 준비되어 있습니다. memcg 통계와 vmalloc page 통계도 소유권에 맞추어 되돌립니다. VM_MAP_PUT_PAGES로 page를 넘겨받은 vmap()에는 별도의 accounting 조건이 적용됩니다.
vunmap()과 vfree()는 같은 뜻이 아닙니다. 일반적인 vmap()에 대응하는 vunmap()은 virtual mapping을 없애되 caller 소유 page를 대신 free하지 않습니다. VM_MAP_PUT_PAGES로 성공적으로 소유권을 넘겼다면 문서가 지정한 vfree() 계약을 따라야 합니다. mapping 실패로 반환값이 NULL인 경우에는 성공한 소유권 이전을 가정할 수 없습니다.
완성 직전에는 KASAN의 접근 가능 상태와 초기화 조건을 반영하고 VM_UNINITIALIZED를 지우며, 필요한 kmemleak 처리를 수행합니다. caller가 보는 것은 하나의 pointer지만 그 뒤에는 주소, 배열, page reference, page table, 진단 상태가 함께 완성되어야 합니다. vmalloc을 단지 '불연속 RAM을 연속으로 보이게 하는 함수'로 외우는 것보다 이 소유권 묶음으로 이해하면 실패와 해제를 훨씬 정확하게 읽을 수 있습니다.
guard를 빼는 작은 helper도 전체 정의로 확인할 수 있습니다. header의 SPDX는 GPL-2.0입니다.
// SPDX-License-Identifier: GPL-2.0
/*
 * Linux v6.18, include/linux/vmalloc.h:232-240
 * Source: https://github.com/torvalds/linux/blob/v6.18/include/linux/vmalloc.h
 * Complete function: get_vm_area_size
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static inline size_t get_vm_area_size(const struct vm_struct *area)
{
	if (!(area->flags & VM_NO_GUARD))
		/* return actual size without guard page */
		return area->size - PAGE_SIZE;
	else
		return area->size;

}
다음 v6.18 __vmalloc_area_node()는 배열·page·mapping의 소유권을 한 함수 안에서 연결합니다. nr_vmalloc_pages는 실제 확보 수만 더합니다. memcg는 책의 page별 반복 대신, 모든 page가 같은 memcg에 charge된다는 전제에서 첫 page와 실제 수를 사용하며 __GFP_ACCOUNT와 nonzero 수를 검사합니다. 높은 order에는 NOFAIL을 제거하고, page-table mapping에서는 NOFS·NOIO scope를 설정했다가 성공·실패 판단 전에 복구합니다. mapping이 실패하고 원래 요청에 NOFAIL이 있으면 한 tick을 기다린 뒤 다시 시도합니다. 이는 data page allocation의 retry와는 별도 단계입니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *  Copyright (C) 1993  Linus Torvalds
 *  Support of BIGMEM added by Gerhard Wichert, Siemens AG, July 1999
 *  SMP-safe vmalloc/vfree/ioremap, Tigran Aivazian <tigran@veritas.com>, May 2000
 *  Major rework to support vmap/vunmap, Christoph Hellwig, SGI, August 2002
 *  Numa awareness, Christoph Lameter, SGI, June 2005
 *  Improving global KVA allocator, Uladzislau Rezki, Sony, May 2019
 */
/*
 * Linux v6.18, mm/vmalloc.c:3678-3789
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/vmalloc.c
 * Complete function: __vmalloc_area_node
 * Body unchanged. Kernel dependencies are not bundled.
 * License text: GPL-2.0.txt
 */

static void *__vmalloc_area_node(struct vm_struct *area, gfp_t gfp_mask,
				 pgprot_t prot, unsigned int page_shift,
				 int node)
{
	const gfp_t nested_gfp = (gfp_mask & GFP_RECLAIM_MASK) | __GFP_ZERO;
	bool nofail = gfp_mask & __GFP_NOFAIL;
	unsigned long addr = (unsigned long)area->addr;
	unsigned long size = get_vm_area_size(area);
	unsigned long array_size;
	unsigned int nr_small_pages = size >> PAGE_SHIFT;
	unsigned int page_order;
	unsigned int flags;
	int ret;

	array_size = (unsigned long)nr_small_pages * sizeof(struct page *);

	if (!(gfp_mask & (GFP_DMA | GFP_DMA32)))
		gfp_mask |= __GFP_HIGHMEM;

	/* Please note that the recursion is strictly bounded. */
	if (array_size > PAGE_SIZE) {
		area->pages = __vmalloc_node_noprof(array_size, 1, nested_gfp, node,
					area->caller);
	} else {
		area->pages = kmalloc_node_noprof(array_size, nested_gfp, node);
	}

	if (!area->pages) {
		warn_alloc(gfp_mask, NULL,
			"vmalloc error: size %lu, failed to allocated page array size %lu",
			nr_small_pages * PAGE_SIZE, array_size);
		free_vm_area(area);
		return NULL;
	}

	set_vm_area_page_order(area, page_shift - PAGE_SHIFT);
	page_order = vm_area_page_order(area);

	/*
	 * High-order nofail allocations are really expensive and
	 * potentially dangerous (pre-mature OOM, disruptive reclaim
	 * and compaction etc.
	 *
	 * Please note, the __vmalloc_node_range_noprof() falls-back
	 * to order-0 pages if high-order attempt is unsuccessful.
	 */
	area->nr_pages = vm_area_alloc_pages((page_order ?
		gfp_mask & ~__GFP_NOFAIL : gfp_mask) | __GFP_NOWARN,
		node, page_order, nr_small_pages, area->pages);

	atomic_long_add(area->nr_pages, &nr_vmalloc_pages);
	/* All pages of vm should be charged to same memcg, so use first one. */
	if (gfp_mask & __GFP_ACCOUNT && area->nr_pages)
		mod_memcg_page_state(area->pages[0], MEMCG_VMALLOC,
				     area->nr_pages);

	/*
	 * If not enough pages were obtained to accomplish an
	 * allocation request, free them via vfree() if any.
	 */
	if (area->nr_pages != nr_small_pages) {
		/*
		 * vm_area_alloc_pages() can fail due to insufficient memory but
		 * also:-
		 *
		 * - a pending fatal signal
		 * - insufficient huge page-order pages
		 *
		 * Since we always retry allocations at order-0 in the huge page
		 * case a warning for either is spurious.
		 */
		if (!fatal_signal_pending(current) && page_order == 0)
			warn_alloc(gfp_mask, NULL,
				"vmalloc error: size %lu, failed to allocate pages",
				area->nr_pages * PAGE_SIZE);
		goto fail;
	}

	/*
	 * page tables allocations ignore external gfp mask, enforce it
	 * by the scope API
	 */
	if ((gfp_mask & (__GFP_FS | __GFP_IO)) == __GFP_IO)
		flags = memalloc_nofs_save();
	else if ((gfp_mask & (__GFP_FS | __GFP_IO)) == 0)
		flags = memalloc_noio_save();

	do {
		ret = vmap_pages_range(addr, addr + size, prot, area->pages,
			page_shift);
		if (nofail && (ret < 0))
			schedule_timeout_uninterruptible(1);
	} while (nofail && (ret < 0));

	if ((gfp_mask & (__GFP_FS | __GFP_IO)) == __GFP_IO)
		memalloc_nofs_restore(flags);
	else if ((gfp_mask & (__GFP_FS | __GFP_IO)) == 0)
		memalloc_noio_restore(flags);

	if (ret < 0) {
		warn_alloc(gfp_mask, NULL,
			"vmalloc error: size %lu, failed to map pages",
			area->nr_pages * PAGE_SIZE);
		goto fail;
	}

	return area->addr;

fail:
	vfree(area->addr);
	return NULL;
}
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 3의 vmalloc backing allocation과 virtual mapping 설명.
- Linux v6.18 mm/vmalloc.c: vm_area_alloc_pages, __vmalloc_area_node, vmap과 해제
- Linux v6.18 include/linux/vmalloc.h: API와 소유권 관련 flags
- Linux v6.18 x86 page-table level과 sync mask