MOVABLE 요청에 맞는 free list가 비었다고 allocation을 바로 실패시키면 여유 memory를 활용하지 못합니다. 반대로 다른 type의 pageblock에서 작은 조각을 계속 가져오면 큰 연속 범위를 만들기 어려워집니다. fallback은 이 두 문제 사이에서 후보 크기와 pageblock의 혼합 정도를 함께 판단합니다.
Linux v6.1에서는 fallback이 free-list 구성을 바꾸고, 일반 탐색이 다시 그 list에서 allocation하는 구조를 볼 수 있습니다. 여기서는 후보 선택부터 split, reserve와 최종 preparation까지 연결하겠습니다.
같은 type에서는 가장 작은 적합한 order를 찾습니다
__rmqueue_smallest()는 요청 order에서 시작해 더 큰 order로 올라갑니다. get_page_from_free_area()로 같은 migrate type의 list에서 첫 후보를 조회하고, 실제 제거는 del_page_from_free_list()로 수행합니다. 조회한 pointer를 얻는 것과 free list에서 소유권을 떼어 내는 것은 다른 동작입니다. 필요 이상으로 큰 부분은 expand()로 나눕니다. 요청을 충족하는 최소 order를 우선하는 것이 기본 경로입니다.
예를 들어 order-4 block에서 order-1을 만들면 order-3, order-2, order-1의 남는 절반을 각각 free list에 돌려놓습니다. 세 번 split해서 세 개의 block entry를 만드는 것이지 base page 세 개만 반환하는 것은 아닙니다. 각 단계에서 뒤쪽 절반을 남기고 앞쪽 범위를 계속 나누면 원래 시작 descriptor에 필요한 크기의 block이 남습니다.
free list에서 제거한 block은 더 이상 buddy-free 상태가 아니므로 반환할 쪽에 free block의 order 표시를 새로 붙일 필요는 없습니다. 남겨 둔 절반에는 list와 buddy order를 설정합니다. debug guard를 사용하는 configuration에서는 일부 절반을 일반 가용 list 대신 guard로 처리할 수 있습니다. 이 list 조작은 zone lock을 보유한 상태에서 수행됩니다.
다른 type에서는 큰 후보가 오히려 유리할 수 있습니다
일반 fallback의 우선순위는 UNMOVABLE 요청이면 RECLAIMABLE 다음 MOVABLE, MOVABLE이면 RECLAIMABLE 다음 UNMOVABLE, RECLAIMABLE이면 UNMOVABLE 다음 MOVABLE입니다. HIGHATOMIC·CMA·ISOLATE를 이 순서 뒤에 덧붙일 수는 없습니다. 그 type들은 별도 권한과 처리 조건을 가집니다.
find_suitable_fallback()은 해당 order의 free area가 비었는지 확인하고 primary·secondary type을 순서대로 살핍니다. 적합한 후보가 없으면 -1을 반환합니다. only_stealable을 요구하는 caller라면 whole-block stealing을 시도할 수 있는 후보인지도 반영합니다. block이 존재하는 조건과 whole-block 처리가 유리한 조건이 분리되어 있습니다.
__rmqueue_fallback()은 일반적으로 큰 order부터 찾습니다. 큰 block이라면 여러 작은 조각을 섞는 대신 pageblock 전체의 free 공간을 요청 type으로 바꾸기 쉽기 때문입니다. NOFRAGMENT가 설정되면 최소 탐색 order를 pageblock order로 높여 작은 혼합을 피하지만 whole-block fallback까지 금지하지는 않습니다.
예외도 있습니다. MOVABLE 요청에서 whole-block stealing이 어렵고 발견한 block이 요청보다 크면, 작은 order부터 다시 적합한 fallback을 찾습니다. 작은 movable allocation 하나로 큰 non-movable free block을 과하게 분할하지 않으려는 선택입니다. “fallback은 항상 가장 큰 block을 고른다”로 요약하면 이 분기를 놓칩니다.
v6.1의 NOFRAGMENT 조건은 요청 order가 pageblock order보다 작을 때만 최소 탐색 order를 올립니다. 요청이 이미 더 크면 원래 order를 유지하여 요청보다 작은 후보를 찾지 않습니다. 큰 free block 탐색은 여유가 많은 pageblock을 저렴하게 찾으려는 근사이며, type별 전체 free 양을 정확히 세어 최댓값을 고르는 census도 아닙니다.
Order 절반과 page 수 절반은 다른 계산입니다
can_steal_fallback()에 전달되는 order는 caller가 최종적으로 필요한 요청 order가 아니라 현재 탐색 중인 후보 free block의 current_order입니다. 후보가 pageblock order 이상이면 whole-block 처리 가능성을 인정합니다. 그보다 작더라도 order >= pageblock_order / 2, 요청 type이 UNMOVABLE·RECLAIMABLE인 경우, mobility grouping이 비활성인 경우 등을 heuristic으로 허용합니다.
여기의 나눗셈은 지수에 적용됩니다. pageblock order가 9이면 9 / 2는 정수 4이고 order-4는 16 page입니다. pageblock의 절반인 256 page라는 뜻이 아닙니다. NOFRAGMENT로 작은 후보를 배제하지 않은 시도에서는 order-0 요청이라도 탐색 중인 후보가 order-6이면 이 판정에 0이 아니라 6을 전달합니다. 작은 요청이라는 이유만으로 whole-block stealing 시도가 반드시 금지되는 것은 아닙니다. 이 조건을 현재 page 수의 과반 증명으로 해석하면 잘못됩니다. 뒤쪽에서 free·alike page 수를 실제로 더해 pageblock 절반과 비교하는 조건은 별도로 존재합니다.
후보 type과 whole-block 가능성을 따로 판정합니다
다음은 Linux v6.1의 fallback 배열과 두 판정 함수 전문입니다. SPDX는 GPL-2.0-only이며 들여쓰기만 정리했습니다. 배열의 각 행 끝은 실제 fallback type이 아닌 MIGRATE_TYPES sentinel입니다.
static int fallbacks[MIGRATE_TYPES][3] = {
    [MIGRATE_UNMOVABLE]   = { MIGRATE_RECLAIMABLE, MIGRATE_MOVABLE,   MIGRATE_TYPES },
    [MIGRATE_MOVABLE]     = { MIGRATE_RECLAIMABLE, MIGRATE_UNMOVABLE, MIGRATE_TYPES },
    [MIGRATE_RECLAIMABLE] = { MIGRATE_UNMOVABLE,   MIGRATE_MOVABLE,   MIGRATE_TYPES },
};
int find_suitable_fallback(struct free_area *area, unsigned int order,
            int migratetype, bool only_stealable, bool *can_steal)
{
    int i;
    int fallback_mt;

    if (area->nr_free == 0)
        return -1;

    *can_steal = false;
    for (i = 0;; i++) {
        fallback_mt = fallbacks[migratetype][i];
        if (fallback_mt == MIGRATE_TYPES)
            break;

        if (free_area_empty(area, fallback_mt))
            continue;

        if (can_steal_fallback(order, migratetype))
            *can_steal = true;

        if (!only_stealable)
            return fallback_mt;

        if (*can_steal)
            return fallback_mt;
    }

    return -1;
}
static bool can_steal_fallback(unsigned int order, int start_mt)
{
    /*
     * Leaving this order check is intended, although there is
     * relaxed order check in next check. The reason is that
     * we can actually steal whole pageblock if this condition met,
     * but, below check doesn't guarantee it and that is just heuristic
     * so could be changed anytime.
     */
    if (order >= pageblock_order)
        return true;

    if (order >= pageblock_order / 2 ||
        start_mt == MIGRATE_RECLAIMABLE ||
        start_mt == MIGRATE_UNMOVABLE ||
        page_group_by_mobility_disabled)
        return true;

    return false;
}
이 검색은 일반 mergeable type을 입력으로 받는 경로입니다. CMA·HIGHATOMIC·ISOLATE를 같은 우선순위 행으로 임의 추가해서는 안 됩니다. area 자체가 비면 -1을 반환하는데, 이 early return은 can_steal을 초기화하기 전입니다. caller는 적합한 type이 반환되었을 때의 output만 사용해야 합니다. only_stealable은 후보 존재와 whole-block 처리 가능성을 구별하기 위한 조건입니다.
Stealing은 live data를 옮기는 작업이 아닙니다
steal_suitable_fallback()은 pageblock type을 다시 읽습니다. 후보를 찾은 뒤 HIGHATOMIC으로 바뀐 경우에는 whole-block 변경을 피하고 단일 candidate를 옮기는 분기로 갑니다. 같은 zone lock을 사용하는 주변 경로가 있어도 이전에 관찰한 분류를 영원히 유효하다고 전제하지 않습니다.
후보가 pageblock 이상 크기라면 그 범위에 포함되는 pageblock의 type을 바꾸고 free-list 소속을 옮깁니다. 더 작은 후보라면 fragmentation 압력을 반영하기 위해 watermark를 boost할 수 있습니다. boost가 적용되고 KSWAPD 동작을 요청한 경우 ZONE_BOOSTED_WATERMARK를 설정합니다. 이 이름과 page·node의 다른 flag를 혼동하지 않아야 합니다.
whole-block stealing이 허용되면 move_freepages_block()으로 같은 pageblock의 free page들을 요청 type list로 옮기고 free·movable 수를 얻습니다. zone 경계를 넘지 않도록 제한하며, 이동한 free가 없으면 단일 candidate 처리로 내려갑니다. 사용 중인 page 내용을 다른 physical address로 복사하는 migration은 여기서 수행하지 않습니다.
alike_pages는 요청 성격과 비슷한 allocated page의 추정량입니다. MOVABLE 요청이면 allocated movable 수를 사용합니다. 기존 MOVABLE block을 non-movable 요청에 바꾸는 경우에는 pageblock 전체에서 free와 movable을 뺀 부분을 이용합니다. 서로 다른 non-movable type 사이에서는 정확히 구별하기 어려워 보수적으로 0으로 둡니다.
free와 alike의 합이 pageblock page 수의 절반 이상이거나 grouping이 비활성인 조건에서 pageblock ownership을 바꿉니다. free list 이동과 pageblock type 변경은 서로 다른 동작이며, 후자가 항상 따라오는 것은 아닙니다. 그렇기 때문에 pageblock type을 모든 live page의 정밀한 분류표로 읽을 수 없습니다.
free·movable 수를 구하는 실제 과정도 같은 범위 이동의 일부입니다. 다음 세 함수는 mm/page_alloc.c의 전문이며 SPDX는 GPL-2.0-only입니다.
static int move_freepages(struct zone *zone,
              unsigned long start_pfn, unsigned long end_pfn,
              int migratetype, int *num_movable)
{
    struct page *page;
    unsigned long pfn;
    unsigned int order;
    int pages_moved = 0;

    for (pfn = start_pfn; pfn <= end_pfn;) {
        page = pfn_to_page(pfn);
        if (!PageBuddy(page)) {
            /*
             * We assume that pages that could be isolated for
             * migration are movable. But we don't actually try
             * isolating, as that would be expensive.
             */
            if (num_movable &&
                    (PageLRU(page) || __PageMovable(page)))
                (*num_movable)++;
            pfn++;
            continue;
        }

        /* Make sure we are not inadvertently changing nodes */
        VM_BUG_ON_PAGE(page_to_nid(page) != zone_to_nid(zone), page);
        VM_BUG_ON_PAGE(page_zone(page) != zone, page);

        order = buddy_order(page);
        move_to_free_list(page, zone, order, migratetype);
        pfn += 1 << order;
        pages_moved += 1 << order;
    }

    return pages_moved;
}
int move_freepages_block(struct zone *zone, struct page *page,
                int migratetype, int *num_movable)
{
    unsigned long start_pfn, end_pfn, pfn;

    if (num_movable)
        *num_movable = 0;

    pfn = page_to_pfn(page);
    start_pfn = pageblock_start_pfn(pfn);
    end_pfn = pageblock_end_pfn(pfn) - 1;

    /* Do not cross zone boundaries */
    if (!zone_spans_pfn(zone, start_pfn))
        start_pfn = pfn;
    if (!zone_spans_pfn(zone, end_pfn))
        return 0;

    return move_freepages(zone, start_pfn, end_pfn, migratetype,
                                num_movable);
}
static void change_pageblock_range(struct page *pageblock_page,
                    int start_order, int migratetype)
{
    int nr_pageblocks = 1 << (start_order - pageblock_order);

    while (nr_pageblocks--) {
        set_pageblock_migratetype(pageblock_page, migratetype);
        pageblock_page += pageblock_nr_pages;
    }
}
num_movable은 실제 isolation을 시험한 성공 수가 아닙니다. non-buddy page의 LRU 또는 __PageMovable 표지를 보고 추정합니다. 반면 이동한 free 양은 buddy block의 order만큼 합산하며 중간 descriptor를 건너뜁니다. 사용 중인 data를 복사하거나 pinned page를 풀어 주는 과정은 없습니다.
zone의 처음과 끝도 비대칭적으로 처리합니다. pageblock 시작이 zone 밖이면 현재 PFN부터 시작하도록 좁히지만 pageblock 끝이 zone 밖이면 0을 반환합니다. 따라서 항상 pageblock 전체를 움직인다고 가정해서는 안 됩니다. 여러 pageblock 크기의 큰 후보를 처리하는 change_pageblock_range()는 필요한 개수만큼 분류 bitmap을 바꾸며, live page 각각의 allocation 용도를 바꾸는 함수가 아닙니다.
Stealing과 boost는 실제 조건을 따라갑니다
다음은 boost_watermark()와 steal_suitable_fallback()의 전문입니다. SPDX는 GPL-2.0-only입니다.
static inline bool boost_watermark(struct zone *zone)
{
    unsigned long max_boost;

    if (!watermark_boost_factor)
        return false;
    /*
     * Don't bother in zones that are unlikely to produce results.
     * On small machines, including kdump capture kernels running
     * in a small area, boosting the watermark can cause an out of
     * memory situation immediately.
     */
    if ((pageblock_nr_pages * 4) > zone_managed_pages(zone))
        return false;

    max_boost = mult_frac(zone->_watermark[WMARK_HIGH],
            watermark_boost_factor, 10000);

    /*
     * high watermark may be uninitialised if fragmentation occurs
     * very early in boot so do not boost. We do not fall
     * through and boost by pageblock_nr_pages as failing
     * allocations that early means that reclaim is not going
     * to help and it may even be impossible to reclaim the
     * boosted watermark resulting in a hang.
     */
    if (!max_boost)
        return false;

    max_boost = max(pageblock_nr_pages, max_boost);

    zone->watermark_boost = min(zone->watermark_boost + pageblock_nr_pages,
        max_boost);

    return true;
}
static void steal_suitable_fallback(struct zone *zone, struct page *page,
        unsigned int alloc_flags, int start_type, bool whole_block)
{
    unsigned int current_order = buddy_order(page);
    int free_pages, movable_pages, alike_pages;
    int old_block_type;

    old_block_type = get_pageblock_migratetype(page);

    /*
     * This can happen due to races and we want to prevent broken
     * highatomic accounting.
     */
    if (is_migrate_highatomic(old_block_type))
        goto single_page;

    /* Take ownership for orders >= pageblock_order */
    if (current_order >= pageblock_order) {
        change_pageblock_range(page, current_order, start_type);
        goto single_page;
    }

    /*
     * Boost watermarks to increase reclaim pressure to reduce the
     * likelihood of future fallbacks. Wake kswapd now as the node
     * may be balanced overall and kswapd will not wake naturally.
     */
    if (boost_watermark(zone) && (alloc_flags & ALLOC_KSWAPD))
        set_bit(ZONE_BOOSTED_WATERMARK, &zone->flags);

    /* We are not allowed to try stealing from the whole block */
    if (!whole_block)
        goto single_page;

    free_pages = move_freepages_block(zone, page, start_type,
                        &movable_pages);
    /*
     * Determine how many pages are compatible with our allocation.
     * For movable allocation, it's the number of movable pages which
     * we just obtained. For other types it's a bit more tricky.
     */
    if (start_type == MIGRATE_MOVABLE) {
        alike_pages = movable_pages;
    } else {
        /*
         * If we are falling back a RECLAIMABLE or UNMOVABLE allocation
         * to MOVABLE pageblock, consider all non-movable pages as
         * compatible. If it's UNMOVABLE falling back to RECLAIMABLE or
         * vice versa, be conservative since we can't distinguish the
         * exact migratetype of non-movable pages.
         */
        if (old_block_type == MIGRATE_MOVABLE)
            alike_pages = pageblock_nr_pages
                        - (free_pages + movable_pages);
        else
            alike_pages = 0;
    }

    /* moving whole block can fail due to zone boundary conditions */
    if (!free_pages)
        goto single_page;

    /*
     * If a sufficient number of pages in the block are either free or of
     * comparable migratability as our allocation, claim the whole block.
     */
    if (free_pages + alike_pages >= (1 << (pageblock_order-1)) ||
            page_group_by_mobility_disabled)
        set_pageblock_migratetype(page, start_type);

    return;

single_page:
    move_to_free_list(page, zone, current_order, start_type);
}
boost factor가 0이거나 managed 규모가 pageblock 네 개보다 작으면 boost하지 않습니다. HIGH 기반 비율 계산 결과가 0인 초기 상태에서도 중단합니다. 허용된 경우에는 pageblock 단위로 늘리되 계산한 최대 boost에서 제한합니다. 혼합이 발생하면 언제나 무제한으로 watermark를 높인다는 규칙이 아닙니다.
whole-block 경로가 free list들을 옮겼더라도 pageblock type 변경은 free·alike의 합계 조건을 다시 통과해야 합니다. single_page라는 label도 요청 크기의 base page 한 개를 뜻하지 않습니다. 이 경로가 옮기는 것은 current_order인 후보 free block 하나입니다. 그 order는 최종 요청 order와 다를 수 있습니다.
Highatomic reserve는 획득 뒤에도 관리합니다
higher-order 요청이 HARDER 권한으로 성공한 뒤 reserve_highatomic_pageblock()이 해당 pageblock을 reserve로 전환할 수 있습니다. v6.1의 기준값은 managed page 수의 약 1%에 pageblock 하나를 더한 값입니다. 상한을 먼저 보고 zone lock 안에서 재검사하며, 현재 type이 일반 mergeable type인 경우에만 변경합니다.
변경할 때 nr_reserved_highatomic 장부와 pageblock type, free-list 소속을 함께 맞춥니다. 이것은 성공한 block을 다시 caller에게서 빼앗는다는 뜻이 아니라 해당 pageblock의 남은 free 공간을 특별한 공급원으로 관리하는 조치입니다. memory pressure에서 reserve를 되돌리는 별도 경로도 있어 영구적인 carve-out과는 다릅니다.
다음은 reserve_highatomic_pageblock() 전문입니다. SPDX는 GPL-2.0-only입니다.
static void reserve_highatomic_pageblock(struct page *page, struct zone *zone,
                unsigned int alloc_order)
{
    int mt;
    unsigned long max_managed, flags;

    /*
     * Limit the number reserved to 1 pageblock or roughly 1% of a zone.
     * Check is race-prone but harmless.
     */
    max_managed = (zone_managed_pages(zone) / 100) + pageblock_nr_pages;
    if (zone->nr_reserved_highatomic >= max_managed)
        return;

    spin_lock_irqsave(&zone->lock, flags);

    /* Recheck the nr_reserved_highatomic limit under the lock */
    if (zone->nr_reserved_highatomic >= max_managed)
        goto out_unlock;

    /* Yoink! */
    mt = get_pageblock_migratetype(page);
    /* Only reserve normal pageblocks (i.e., they can merge with others) */
    if (migratetype_is_mergeable(mt)) {
        zone->nr_reserved_highatomic += pageblock_nr_pages;
        set_pageblock_migratetype(page, MIGRATE_HIGHATOMIC);
        move_freepages_block(zone, page, MIGRATE_HIGHATOMIC, NULL);
    }

out_unlock:
    spin_unlock_irqrestore(&zone->lock, flags);
}
앞의 계산값은 증가 전의 판정 기준입니다. 조건을 통과하면 pageblock 하나만큼 한꺼번에 더하므로 마지막 증가 뒤의 값이 비정렬 기준값보다 커질 수 있습니다. byte 단위로 정확히 1%를 봉인하는 상한이 아닙니다. 증가 전 빠른 검사와 lock 안의 재검사, type 판정, 장부·pageblock·free-list 변경을 함께 읽어야 합니다.
마지막 preparation과 charge가 성공해야 끝납니다
prep_new_page()의 post_alloc_hook()는 private 상태 정리, refcount 초기화, architecture·sanitizer·page-owner 관련 처리와 필요한 zeroing 등을 수행합니다. 그 뒤 양수 order와 __GFP_COMP가 함께 요구되면 compound metadata를 준비합니다. reserve를 사용한 allocation의 pfmemalloc 상태도 적절히 전파해야 합니다. 이 상태의 page를 일반 용도로 무제한 소비하면 reclaim 경로의 진행에 영향을 줄 수 있습니다.
다음은 prep_new_page()와 post_alloc_hook()의 전문입니다. SPDX는 GPL-2.0-only이며 초기화가 끝난 뒤 compound 준비와 pfmemalloc 표시를 적용하는 순서를 보존했습니다.
static void prep_new_page(struct page *page, unsigned int order, gfp_t gfp_flags,
                            unsigned int alloc_flags)
{
    post_alloc_hook(page, order, gfp_flags);

    if (order && (gfp_flags & __GFP_COMP))
        prep_compound_page(page, order);

    /*
     * page is set pfmemalloc when ALLOC_NO_WATERMARKS was necessary to
     * allocate the page. The expectation is that the caller is taking
     * steps that will free more memory. The caller should avoid the page
     * being used for !PFMEMALLOC purposes.
     */
    if (alloc_flags & ALLOC_NO_WATERMARKS)
        set_page_pfmemalloc(page);
    else
        clear_page_pfmemalloc(page);
}
inline void post_alloc_hook(struct page *page, unsigned int order,
                gfp_t gfp_flags)
{
    bool init = !want_init_on_free() && want_init_on_alloc(gfp_flags) &&
            !should_skip_init(gfp_flags);
    bool init_tags = init && (gfp_flags & __GFP_ZEROTAGS);
    int i;

    set_page_private(page, 0);
    set_page_refcounted(page);

    arch_alloc_page(page, order);
    debug_pagealloc_map_pages(page, 1 << order);

    /*
     * Page unpoisoning must happen before memory initialization.
     * Otherwise, the poison pattern will be overwritten for __GFP_ZERO
     * allocations and the page unpoisoning code will complain.
     */
    kernel_unpoison_pages(page, 1 << order);

    /*
     * As memory initialization might be integrated into KASAN,
     * KASAN unpoisoning and memory initializion code must be
     * kept together to avoid discrepancies in behavior.
     */

    /*
     * If memory tags should be zeroed (which happens only when memory
     * should be initialized as well).
     */
    if (init_tags) {
        /* Initialize both memory and tags. */
        for (i = 0; i != 1 << order; ++i)
            tag_clear_highpage(page + i);

        /* Note that memory is already initialized by the loop above. */
        init = false;
    }
    if (!should_skip_kasan_unpoison(gfp_flags)) {
        /* Unpoison shadow memory or set memory tags. */
        kasan_unpoison_pages(page, order, init);

        /* Note that memory is already initialized by KASAN. */
        if (kasan_has_integrated_init())
            init = false;
    } else {
        /* Ensure page_address() dereferencing does not fault. */
        for (i = 0; i != 1 << order; ++i)
            page_kasan_tag_reset(page + i);
    }
    /* If memory is still not initialized, do it now. */
    if (init)
        kernel_init_pages(page, 1 << order);
    /* Propagate __GFP_SKIP_KASAN_POISON to page flags. */
    if (kasan_hw_tags_enabled() && (gfp_flags & __GFP_SKIP_KASAN_POISON))
        SetPageSkipKASanPoison(page);

    set_page_owner(page, order, gfp_flags);
    page_table_check_alloc(page, order);
}
private 정리와 head reference 준비 뒤에 architecture·debug mapping·unpoison 처리가 이어집니다. poison pattern을 검사하기 전에 ZERO 처리로 덮어쓰면 정상 검증을 깨뜨릴 수 있어 unpoison이 memory 초기화보다 앞섭니다. tag 초기화나 KASAN integrated init이 내용을 이미 초기화했으면 init을 내려 중복 초기화를 피합니다. owner와 page-table 검사 hook도 반환 준비의 일부입니다.
초기화 생략의 조건을 정하는 두 helper는 다음과 같습니다. 같은 파일의 실제 정의이며 SPDX는 GPL-2.0-only입니다.
static inline bool should_skip_kasan_unpoison(gfp_t flags)
{
    /* Don't skip if a software KASAN mode is enabled. */
    if (IS_ENABLED(CONFIG_KASAN_GENERIC) ||
        IS_ENABLED(CONFIG_KASAN_SW_TAGS))
        return false;

    /* Skip, if hardware tag-based KASAN is not enabled. */
    if (!kasan_hw_tags_enabled())
        return true;

    /*
     * With hardware tag-based KASAN enabled, skip if this has been
     * requested via __GFP_SKIP_KASAN_UNPOISON.
     */
    return flags & __GFP_SKIP_KASAN_UNPOISON;
}
static inline bool should_skip_init(gfp_t flags)
{
    /* Don't skip, if hardware tag-based KASAN is not enabled. */
    if (!kasan_hw_tags_enabled())
        return false;

    /* For hardware tag-based KASAN, skip if requested. */
    return (flags & __GFP_SKIP_ZERO);
}
software KASAN mode에서는 HW-tag용 skip bit로 unpoison을 생략하지 않습니다. HW-tag 초기화·runtime enable 상태와 GFP 요청을 구별합니다. init_on_free, init_on_alloc, ZERO, tag 초기화, KASAN 처리를 단일 memset 한 줄로 요약할 수 없는 이유입니다.
memcg accounting을 요청한 경우 마지막 charge가 실패할 수도 있습니다. 이때 얻은 page를 __free_pages()로 반환하고 NULL을 돌려주는 unwind가 필요합니다. list에서 block을 찾았다는 사실만으로 API 성공을 선언할 수 없는 마지막 이유입니다.
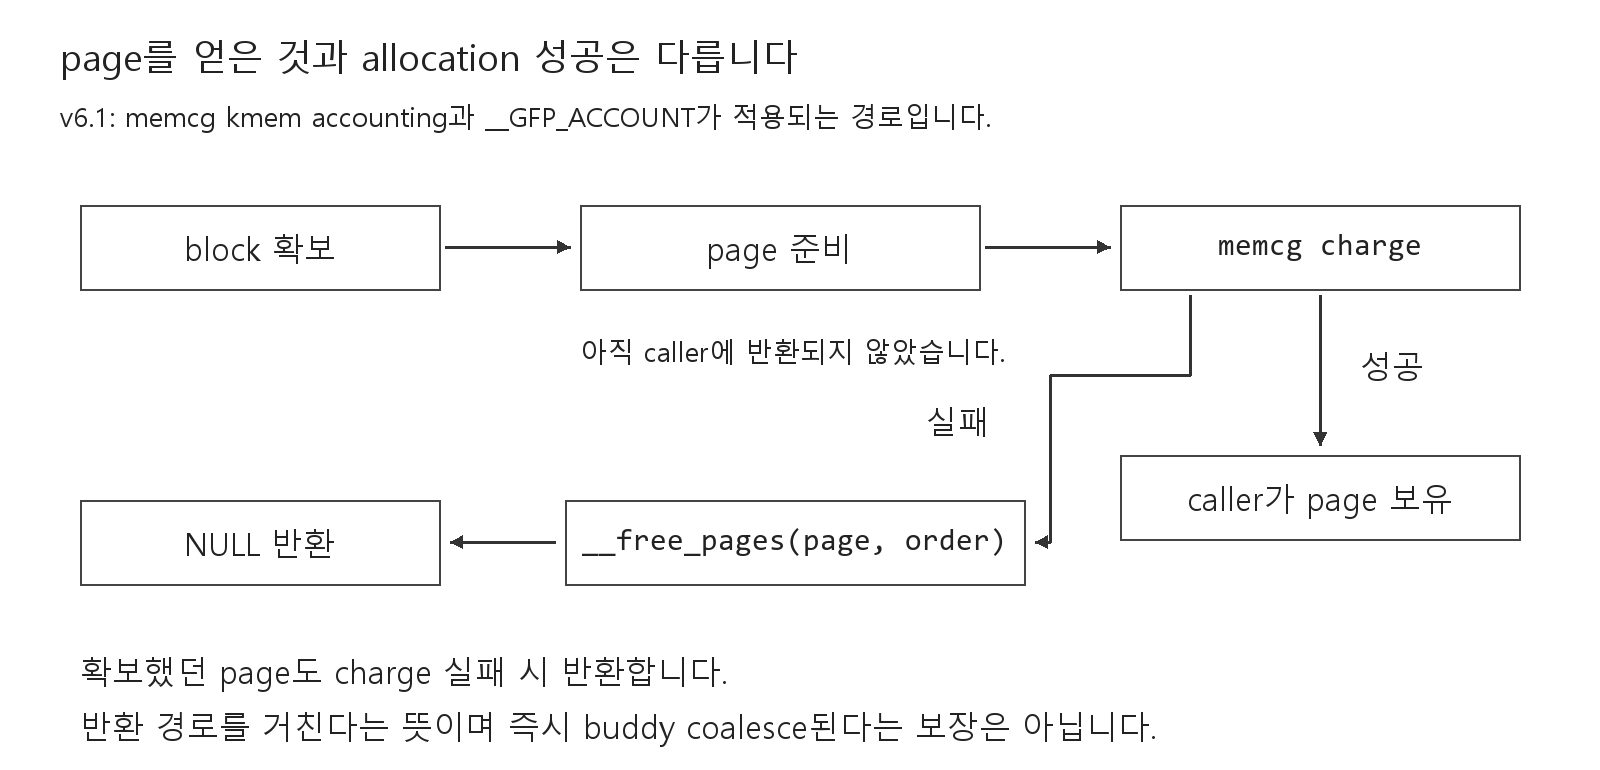
fallback은 free memory의 분류를 조정해 성공 가능성과 장기적인 fragmentation 사이에서 절충합니다. final preparation은 그 결과를 새 owner의 계약에 맞춥니다. 두 단계를 나누면 allocation trace에 나타난 후보 이동을 data migration이나 최종 성공으로 잘못 읽지 않게 됩니다.
같은 type 탐색과 split의 함수 전문입니다
다음은 Linux v6.1의 __rmqueue_smallest()와 expand() 전문입니다. mm/page_alloc.c의 SPDX는 GPL-2.0-only이며 들여쓰기만 정리했습니다. 이 호출 관계에서 zone lock은 이미 보유한 상태입니다.
static __always_inline
struct page *__rmqueue_smallest(struct zone *zone, unsigned int order,
                        int migratetype)
{
    unsigned int current_order;
    struct free_area *area;
    struct page *page;

    /* Find a page of the appropriate size in the preferred list */
    for (current_order = order; current_order < MAX_ORDER; ++current_order) {
        area = &(zone->free_area[current_order]);
        page = get_page_from_free_area(area, migratetype);
        if (!page)
            continue;
        del_page_from_free_list(page, zone, current_order);
        expand(zone, page, order, current_order, migratetype);
        set_pcppage_migratetype(page, migratetype);
        trace_mm_page_alloc_zone_locked(page, order, migratetype,
                pcp_allowed_order(order) &&
                migratetype < MIGRATE_PCPTYPES);
        return page;
    }

    return NULL;
}
static inline void expand(struct zone *zone, struct page *page,
    int low, int high, int migratetype)
{
    unsigned long size = 1 << high;

    while (high > low) {
        high--;
        size >>= 1;
        VM_BUG_ON_PAGE(bad_range(zone, &page[size]), &page[size]);

        /*
         * Mark as guard pages (or page), that will allow to
         * merge back to allocator when buddy will be freed.
         * Corresponding page table entries will not be touched,
         * pages will stay not present in virtual address space
         */
        if (set_page_guard(zone, &page[size], high, migratetype))
            continue;

        add_to_free_list(&page[size], zone, high, migratetype);
        set_buddy_order(&page[size], high);
    }
}
get_page_from_free_area()는 첫 entry를 조회합니다. 이어지는 del_page_from_free_list()가 제거를 수행하며, split이 끝난 뒤 반환할 head에 PCP용 migratetype을 기록합니다. 새 owner의 refcount·zeroing·compound 준비는 이 함수의 역할이 아닙니다.
expand()는 먼저 high를 하나 낮추고 size를 절반으로 줄인 뒤 그 뒤쪽 절반을 검사합니다. guard가 설정되면 일반 free list에 추가하지 않고 다음 split으로 갑니다. 그렇지 않은 경우에만 list 추가와 buddy-order 설정을 함께 수행합니다. 단순히 큰 block을 두 list에 모두 넣는 algorithm이 아닙니다.
Fallback은 list를 바꾸고 성공 여부만 돌려줍니다
다음은 같은 파일의 __rmqueue_fallback() 전문입니다. SPDX는 GPL-2.0-only입니다. 큰 후보 탐색, MOVABLE 예외의 작은 후보 재탐색, stealing과 trace까지 해당 함수 scope를 모두 보존했습니다.
/*
 * Try finding a free buddy page on the fallback list and put it on the free
 * list of requested migratetype, possibly along with other pages from the same
 * block, depending on fragmentation avoidance heuristics. Returns true if
 * fallback was found so that __rmqueue_smallest() can grab it.
 *
 * The use of signed ints for order and current_order is a deliberate
 * deviation from the rest of this file, to make the for loop
 * condition simpler.
 */
static __always_inline bool
__rmqueue_fallback(struct zone *zone, int order, int start_migratetype,
                        unsigned int alloc_flags)
{
    struct free_area *area;
    int current_order;
    int min_order = order;
    struct page *page;
    int fallback_mt;
    bool can_steal;

    /*
     * Do not steal pages from freelists belonging to other pageblocks
     * i.e. orders < pageblock_order. If there are no local zones free,
     * the zonelists will be reiterated without ALLOC_NOFRAGMENT.
     */
    if (order < pageblock_order && alloc_flags & ALLOC_NOFRAGMENT)
        min_order = pageblock_order;

    /*
     * Find the largest available free page in the other list. This roughly
     * approximates finding the pageblock with the most free pages, which
     * would be too costly to do exactly.
     */
    for (current_order = MAX_ORDER - 1; current_order >= min_order;
                --current_order) {
        area = &(zone->free_area[current_order]);
        fallback_mt = find_suitable_fallback(area, current_order,
                start_migratetype, false, &can_steal);
        if (fallback_mt == -1)
            continue;

        /*
         * We cannot steal all free pages from the pageblock and the
         * requested migratetype is movable. In that case it's better to
         * steal and split the smallest available page instead of the
         * largest available page, because even if the next movable
         * allocation falls back into a different pageblock than this
         * one, it won't cause permanent fragmentation.
         */
        if (!can_steal && start_migratetype == MIGRATE_MOVABLE
                    && current_order > order)
            goto find_smallest;

        goto do_steal;
    }

    return false;

find_smallest:
    for (current_order = order; current_order < MAX_ORDER;
                            current_order++) {
        area = &(zone->free_area[current_order]);
        fallback_mt = find_suitable_fallback(area, current_order,
                start_migratetype, false, &can_steal);
        if (fallback_mt != -1)
            break;
    }

    /*
     * This should not happen - we already found a suitable fallback
     * when looking for the largest page.
     */
    VM_BUG_ON(current_order == MAX_ORDER);

do_steal:
    page = get_page_from_free_area(area, fallback_mt);

    steal_suitable_fallback(zone, page, alloc_flags, start_migratetype,
                                can_steal);

    trace_mm_page_alloc_extfrag(page, order, current_order,
        start_migratetype, fallback_mt);

    return true;

}
min_order를 올리는 것은 NOFRAGMENT가 적용된 작은 요청에서 pageblock보다 작은 후보를 섞지 않기 위한 선택입니다. 큰 order를 찾았더라도 can_steal이 거짓이고 요청이 MOVABLE이면 find_smallest로 방향을 바꿀 수 있습니다. 이 두 탐색 loop에서 사용하는 signed order는 아래로 내려가는 종료 조건을 표현하기 위한 의도적인 선택입니다.
do_steal 뒤에 반환하는 것은 true뿐입니다. 실제 caller인 __rmqueue()는 그 결과로 같은 type의 smallest 탐색을 다시 실행합니다. 이 함수 자체가 반환할 page를 이미 최종 preparation해서 caller에게 넘긴 것처럼 읽어서는 안 됩니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access, 2025, Physical Memory 장.
- Linux
v6.1: __rmqueue_smallest·expand·fallback·stealing·highatomic·prep_new_page의 전체 구현, migrate type, 내부 allocation 조건.