DMA 제약이 없는 요청이 낮은 주소의 page를 모두 가져가면, 나중에 그 주소만 사용할 수 있는 device가 곤란해집니다. Linux는 이 문제를 단순히 “이 PFN들은 영원히 DMA 전용”이라고 표시하는 방식으로만 해결하지 않습니다. 요청이 원래 사용할 수 있는 zone을 기준으로 lower zone의 allocation 문턱을 달리합니다.
그 문턱의 한 부분이 lowmem_reserve[]입니다. Linux v6.1의 계산을 따라가면 ratio가 커질수록 보호량이 줄어드는 이유, free가 남아 있는데도 요청을 거절하는 이유, totalreserve_pages가 실제 예약 pool이 아닌 이유를 함께 이해할 수 있습니다.
같은 lower zone에서도 요청에 따라 protection이 달라집니다
zone의 lowmem_reserve는 값 하나가 아니라 최고 허용 zone index별 배열입니다. DMA만 사용할 수 있는 요청과 NORMAL까지 사용할 수 있는 요청이 DMA zone에 왔을 때 같은 protection을 적용하지 않는 것입니다. higher zone을 사용할 수 있는 요청일수록 lower zone을 아껴야 할 이유가 있습니다.
setup_per_zone_lowmem_reserve()는 한 lower zone 위에 있는 zone들의 managed page를 누적하고 lower zone에 대응하는 ratio로 나누어 protection을 계산합니다. 자기 자신보다 높은 zone을 대상으로 하는 값이며, lower zone 자신의 현재 free page를 ratio로 나누는 공식이 아닙니다. 계산의 기반은 managed 규모이지 순간적인 free 양이 아닙니다.
ratio는 역방향으로 작동합니다. 같은 누적 managed count를 더 큰 수로 나누면 protection은 작아집니다. 정수 나눗셈이므로 소수점 이하는 버려집니다. ratio가 0인 경우에는 나눗셈을 하지 않고 해당 보호를 비활성화하는 분기를 사용합니다. 값을 낮추는 행위가 무조건 “더 자유롭게 allocation”을 뜻한다고 해석하면 반대 결과를 낼 수 있습니다.
현재 system의 읽기 전용 자료를 살피려면 다음 command를 사용할 수 있습니다. 여기서는 실행하지 않았으며, 아래에 실측 출력이 있다고 가정하지 않습니다. 첫 command는 값을 조회할 뿐 변경하지 않습니다.
sysctl vm.lowmem_reserve_ratio
cat /proc/zoneinfo
/proc/zoneinfo의 protection은 출력된 zone 종류 순서의 base-page count입니다. managed나 현재 free와는 다른 항목이며, 다음 계산 예시는 그 배열 값이 어디에서 나오는지 보여 줍니다.
숫자 예시로 계산 방향을 확인합니다
DMA·DMA32·NORMAL·MOVABLE의 managed page 수를 각각 3,977, 765,917, 1,836,032, 5,099,663으로 가정하겠습니다. DEVICE는 0입니다. ratio가 각각 256, 128, 32, 0이고 DEVICE도 0인 계산 예시입니다. 실제 특정 머신의 측정값이나 기본 설정값을 뜻하지 않습니다.
DMA가 DMA32까지 허용된 요청을 상대할 때는 765,917을 256으로 나누어 2,991을 얻습니다. NORMAL까지 허용되면 위쪽 합계가 2,601,949가 되어 protection은 10,163입니다. MOVABLE까지 허용되면 7,701,612를 256으로 나눈 30,084가 됩니다. DEVICE의 managed 수가 0이면 그 zone을 누적해도 합계는 더 커지지 않습니다.
DMA32의 NORMAL 대상 값은 1,836,032를 128로 나눈 14,344입니다. MOVABLE까지의 합계는 6,935,695이므로 54,185가 됩니다. NORMAL의 MOVABLE 대상 값은 5,099,663을 32로 나눈 159,364입니다. MOVABLE의 ratio가 0이므로 더 높은 DEVICE 요청을 위한 해당 entry는 0으로 씁니다. 마지막 DEVICE zone은 그보다 높은 종류가 없어서 lower-zone loop에 들어가지 않습니다. 이 예의 각 배열에서 자기 index 이하의 값도 0이며, 함수가 그 entry들을 새로 계산하는 것은 아닙니다.
숫자의 크기가 실제 lower zone에 존재하는 free 양보다 커 보일 수도 있습니다. protection은 “지금 이만큼 page를 별도 list로 떼어 놓았다”는 수량이 아니라, 특정 요청이 이 zone에서 allocation할 수 있는지를 판단하는 기준이기 때문입니다.
Watermark 검사에서는 protection을 더해 비교합니다
기본적인 관계는 조정한 free 수가 선택한 mark와 lowmem_reserve[highest_zoneidx]의 합보다 충분히 커야 한다는 것입니다. __zone_watermark_ok()에서는 이 합 이하인 경우를 거절합니다. free가 mark보다 크더라도 protection까지 넘지 못하면 높은 zone을 쓸 수 있는 요청은 lower zone에서 실패할 수 있습니다.
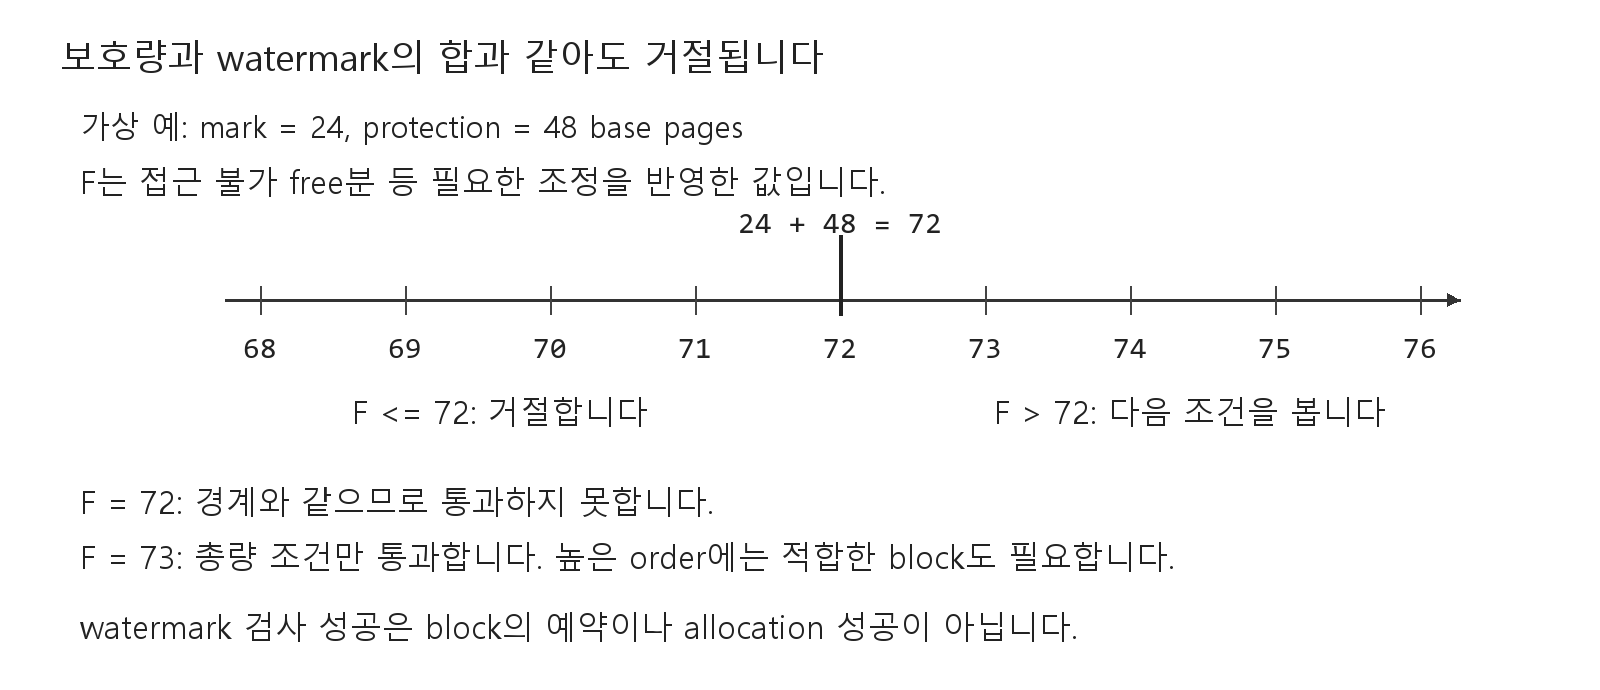
실제 free 계산에는 order 때문에 바로 쓸 수 없는 양, 권한이 없는 highatomic·CMA 여유 등도 들어갑니다. HIGH나 OOM 관련 내부 flag가 mark를 완화하는 경우에도 protection과 모든 다른 조건이 자동으로 사라지는 것은 아닙니다. 숫자 하나만 바꾸면 실패가 해결될 것이라는 결론을 내리기 전에 어느 항이 문턱을 만들었는지 구별해야 합니다.
MIN·LOW·HIGH는 한 pool을 세 등분한 경계가 아닙니다. background reclaim을 시작하고 allocation에 허용할 여유를 판단하는 기준입니다. watermark boost가 더해질 수도 있고, memcg처럼 별도 제약에 따른 reclaim도 있으므로 zone이 HIGH 위에 있다는 이유만으로 시스템 전체의 reclaim이 정지한다고 말할 수는 없습니다.
LOW는 background reclaim을 깨우고 HIGH는 충분한 여유를 회복했는지 판단하는 기준으로 연결됩니다. MIN 부근에서 바로 얻지 못한 요청은 GFP가 허용하면 direct reclaim에 참여할 수 있고, 그렇지 않으면 실패를 받아들여야 합니다. OOM 판단도 이러한 경로의 조건을 거친 뒤의 일입니다. WMARK_PROMO는 NUMA memory tiering의 promotion 판단을 위한 별도 기준입니다. 숫자 경계를 넘는 순간 모든 caller가 같은 행동을 하는 interrupt처럼 이해하면 안 됩니다.
kswapd가 회복했다고 판단하는 단위도 시스템 전체 free 합계는 아닙니다. v6.1의 pgdat_balanced()는 node 안에서 highest_zoneidx까지의 managed zone을 살피고 요청 order에 대한 watermark 검사를 통과하는 zone이 있는지 확인합니다. 일반 모드에서는 HIGH, memory tiering 모드에서는 PROMO를 기준으로 사용할 수 있습니다. 해당 범위에 managed zone이 하나도 없다면 이 요청에 맞춰 균형을 잡을 대상도 없으므로 balanced로 취급하는 예외가 있습니다. 모든 node의 모든 zone이 HIGH 위로 올라와야만 background reclaim이 쉴 수 있다는 조건은 아닙니다. 실제 sleep 준비에는 대기 중인 direct reclaimer 같은 추가 상태도 관여합니다.
totalreserve_pages는 계산된 장부입니다
calculate_totalreserve_pages()는 zone마다 가장 큰 lowmem protection과 high watermark를 고려하고, 그 zone의 managed 수를 넘지 않도록 제한해 합산합니다. node별 reserve 장부와 global totalreserve_pages에 반영하는 구조입니다. 모든 index의 protection을 단순히 더하지 않는 이유는 같은 lower-zone 보호를 중복 계산하지 않기 위해서입니다.
이 총량은 특정 PFN들을 봉인한 pool의 크기가 아닙니다. kernel이 여유 memory와 reclaim의 기준을 해석할 때 사용하는 정책상의 장부입니다. 각 task에게 같은 양을 별도로 청구하는 것도 아닙니다. lower zone protection, watermark, highatomic free list를 모두 같은 종류의 “예약 메모리”라고 부르면 실제 구현과 멀어집니다.
managed 규모나 watermark 설정이 바뀌면 관련 값의 재계산도 필요합니다. min_free_kbytes, lowmem reserve ratio, memory hotplug 같은 변화가 연결됩니다. 조정 가능한 값이라는 사실은 운영 중 임의로 낮춰도 된다는 뜻이 아닙니다. allocation 성공률뿐 아니라 제약이 강한 caller와 reclaim의 forward progress를 보호하기 위한 값이기 때문입니다.
reserve를 이해하는 가장 실용적인 관점은 “누구를 위해 남기는가”와 “누가 그 문턱을 적용받는가”를 분리하는 것입니다. free page의 존재와 그 caller에게 허용된 free page의 존재는 다른 조건입니다.
Protection을 계산하는 두 함수의 전문입니다
다음은 Linux v6.1의 setup_per_zone_lowmem_reserve() 전문입니다. 같은 파일 mm/page_alloc.c의 SPDX는 GPL-2.0-only이며 들여쓰기만 정리했습니다. 앞의 숫자 예시와 달리 아래 코드는 해당 tag의 실제 구현입니다.
static void setup_per_zone_lowmem_reserve(void)
{
    struct pglist_data *pgdat;
    enum zone_type i, j;

    for_each_online_pgdat(pgdat) {
        for (i = 0; i < MAX_NR_ZONES - 1; i++) {
            struct zone *zone = &pgdat->node_zones[i];
            int ratio = sysctl_lowmem_reserve_ratio[i];
            bool clear = !ratio || !zone_managed_pages(zone);
            unsigned long managed_pages = 0;

            for (j = i + 1; j < MAX_NR_ZONES; j++) {
                struct zone *upper_zone = &pgdat->node_zones[j];

                managed_pages += zone_managed_pages(upper_zone);

                if (clear)
                    zone->lowmem_reserve[j] = 0;
                else
                    zone->lowmem_reserve[j] = managed_pages / ratio;
            }
        }
    }

    /* update totalreserve_pages */
    calculate_totalreserve_pages();
}
바깥 loop는 online node, 그다음은 lower zone입니다. 마지막 zone은 그보다 높은 zone이 없으므로 lower-zone loop에서 제외합니다. ratio가 0이거나 lower zone의 managed 수가 0이면 위쪽 entry를 0으로 씁니다. upper managed의 누적은 계속 수행하지만 나눗셈은 하지 않습니다. 이 함수가 설정하는 것은 j > i인 entry이며 자기 이하 entry를 새로 계산하는 loop는 아닙니다.
끝에서 호출하는 calculate_totalreserve_pages()도 전문을 함께 보겠습니다.
static void calculate_totalreserve_pages(void)
{
    struct pglist_data *pgdat;
    unsigned long reserve_pages = 0;
    enum zone_type i, j;

    for_each_online_pgdat(pgdat) {

        pgdat->totalreserve_pages = 0;

        for (i = 0; i < MAX_NR_ZONES; i++) {
            struct zone *zone = pgdat->node_zones + i;
            long max = 0;
            unsigned long managed_pages = zone_managed_pages(zone);

            /* Find valid and maximum lowmem_reserve in the zone */
            for (j = i; j < MAX_NR_ZONES; j++) {
                if (zone->lowmem_reserve[j] > max)
                    max = zone->lowmem_reserve[j];
            }

            /* we treat the high watermark as reserved pages. */
            max += high_wmark_pages(zone);

            if (max > managed_pages)
                max = managed_pages;

            pgdat->totalreserve_pages += max;

            reserve_pages += max;
        }
    }
    totalreserve_pages = reserve_pages;
}
node별 합계를 먼저 0으로 다시 시작하고, 각 zone에서는 자기 index 이상에 있는 protection의 최댓값만 고릅니다. 여기에 boost를 포함하는 high_wmark_pages()를 더한 뒤 managed 수로 상한을 제한합니다. node의 합과 global 합을 모두 다시 만드는 구조이므로 예전 값에 새 계산을 끝없이 누적하지 않습니다. 이 계산이 free-list entry를 제거하거나 refcount를 올리지 않는다는 점도 코드에서 확인할 수 있습니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access, 2025, Physical Memory 장.
- Linux
v6.1: setup_per_zone_lowmem_reserve·calculate_totalreserve_pages·watermark 검사, zone의 reserve와 watermark 필드, pgdat_balanced와 kswapd sleep 준비. - Linux kernel documentation: vm sysctl의 lowmem_reserve_ratio와 min_free_kbytes.